
در مهندسی سیستم های نرم افزاری با کارایی فوق بالا، درخت های جستجوی دودویی معمولی (BST) دارای یک پاشنه آشیل مرگبار هستند. اگر داده های ورودی به صورت مرتب درج شوند، ساختار درخت به یک لیست پیوندی تبهگن (Degenerate) تبدیل می شود.
در این حالت بحرانی، ارتفاع درخت به \(N\) رسیده و پیچیدگی زمانی جستجو، درج و حذف از حالت بهینه لگاریتمی به هزینه خطی \(O(N)\) سقوط می کند. این اتفاق توان پردازشی کل سامانه را به شدت کاهش می دهد.
برای حل این معضل بنیادین، درخت های جستجوی دودویی خودمتوازن (Self-Balancing BST) نظیر درخت AVL و درخت سرخ و سیاه (Red-Black Tree) اختراع شدند تا تضمین کنند ارتفاع درخت همواره در محدوده لگاریتمی باقی می ماند.
همان طور که در راهنمای جامع تحلیل عمیق Big-O و پیچیدگی الگوریتم ها بررسی کردیم، تفاوت میان زمان اجرای لگاریتمی O(log N) و خطی O(N) در دیتاست های میلیونی به معنای تفاوت میان پاسخ گویی در چند میکروثانیه در برابر چند ثانیه معطلی پردازنده است. در ادامه، معماری، اثبات های ریاضی و پیاده سازی عملیاتی این ساختار ها را بررسی می کنیم.
۱. کالبدشکافی تبهگنی درخت های BST: چرایی نیاز به توازن خودکار
درخت جستجوی دودویی ساده بر این فرض بنا شده که کلیدهای زیردرخت چپ کوچکتر و کلیدهای زیردرخت راست بزرگتر از مقدار گره جاری باشند. در توزیع تصادفی، ارتفاع ساختار تقریبا معادل \(\log N\) خواهد بود.
اما در سناریوهای واقعی مهندسی نرم افزار، جریان های داده ای مانند شناسه های ترتیبی دیتابیس یا تایم استمپ های لاگ ها کاملا صعودی هستند. ورود این داده ها بدون توازن خودکار، فاجعه افت کارایی را رقم می زند.
نتایج فاجعه بار تبهگنی در پروداکشن
درج ۱۰۰,۰۰۰ کلید مرتب در یک BST ساده منجر به ساخت درختی با عمق ۱۰۰,۰۰۰ گره می شود. این اتفاق دو آسیب جدی به دنبال دارد:
- خطای سرریز پشته (Stack Overflow): پیمایش های بازگشتی به علت عمق بالای فراخوانی پشته فراخوانی را سرریز می کنند.
- سقوط پرفورمنس به مرتبه خطی: زمان جستجوی یک کلید از حدود ۱۷ عمل مقایسه در حالت لگاریتمی، به ۱۰۰,۰۰۰ عمل مقایسه افزایش می یابد که به معنای افت سرعت نزدیک به ۶,۰۰۰ برابری است!
۲. معماری و ریاضیات درخت AVL: فاکتور توازن و چرخش های چهارگانه
درخت AVL (نام گذاری شده بر اساس مخترعان آن: Adelson-Velsky و Landis در سال ۱۹۶۲) نخستین ساختمان داده درخت خودمتوازن در تاریخ علوم کامپیوتر است. قانون بنیادین درخت AVL چنین تعریف می شود: برای هر گره دلخواه در درخت، قدر مطلق اختلاف ارتفاع زیردرخت چپ و زیردرخت راست حداکثر باید ۱ باشد.
تعریف فرمول فاکتور توازن (Balance Factor)
فاکتور توازن هر گره v برابر است با تفاضل ارتفاع فرزند چپ از فرزند راست:
BalanceFactor(v) = Height(v.left) - Height(v.right)
شرط توازن معتبر در درخت AVL: BalanceFactor(v) ∈ {-1, 0, +1}
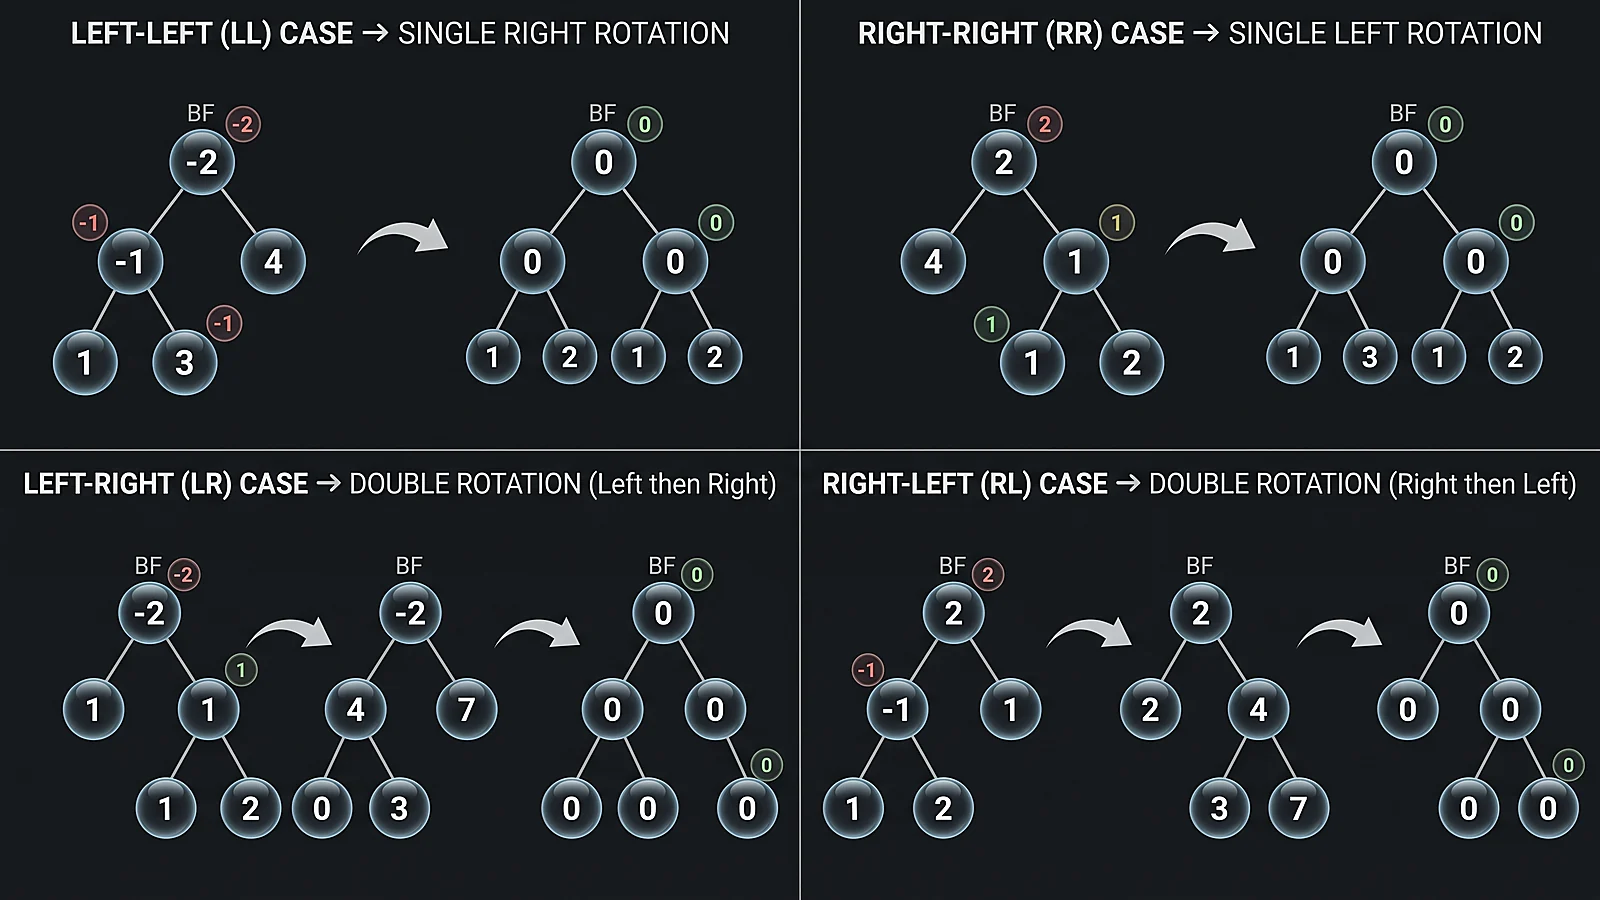
به محض این که پس از یک عملیات درج یا حذف، فاکتور توازن گره ای به +۲ یا -۲ برسد، درخت وارد وضعیت نامتوازن (Unbalanced) شده و باید بلافاصله از طریق یکی از چرخش های چهارگانه زیر اصلاح گردد:
- چرخش راست ساده (Right Rotation - حالت Left-Left): زمانی رخ می دهد که گره نامتوازن دارای فاکتور توازن +۲ بوده و فرزند چپ آن نیز دارای فاکتور توازن +۱ یا ۰ باشد (درج در زیردرخت چپِ فرزند چپ).
- چرخش چپ ساده (Left Rotation - حالت Right-Right): قرینه حالت قبل؛ زمانی که فاکتور توازن گره -۲ بوده و فرزند راست آن فاکتور توازن -۱ یا ۰ دارد.
- چرخش چپ-راست مضاعف (Left-Right Rotation - حالت LR): زمانی رخ می دهد که فاکتور گره +۲ بوده اما فرزند چپ آن دارای فاکتور توازن -۱ باشد. در این سناریو، ابتدا یک چرخش چپ روی فرزند چپ اعمال شده تا وضعیت به LL تبدیل شود، و سپس یک چرخش راست روی گره اصلی انجام می پذیرد.
- چرخش راست-چپ مضاعف (Right-Left Rotation - حالت RL): قرینه حالت LR؛ ابتدا چرخش راست روی فرزند راست و سپس چرخش چپ روی گره ریشه ناپایدار.
۳. پیاده سازی الگوریتمی درخت AVL در پایتون با چرخش های خودکار
کد زیر پیاده سازی تمیز گره های AVL، محاسبه ارتفاع و متد های چرخش و درج خودمتوازن را نشان می دهد:
class AVLNode:
    def __init__(self, key):
        self.key = key
        self.left = None
        self.right = None
        self.height = 1

class AVLTree:
    def get_height(self, node):
        if not node:
            return 0
        return node.height

    def get_balance(self, node):
        if not node:
            return 0
        return self.get_height(node.left) - self.get_height(node.right)

    def rotate_right(self, y):
        x = y.left
        T2 = x.right

        # اجرای چرخش راست
        x.right = y
        y.left = T2

        # به روزرسانی ارتفاع ها
        y.height = 1 + max(self.get_height(y.left), self.get_height(y.right))
        x.height = 1 + max(self.get_height(x.left), self.get_height(x.right))
        return x

    def rotate_left(self, x):
        y = x.right
        T2 = y.left

        # اجرای چرخش چپ
        y.left = x
        x.right = T2

        # به روزرسانی ارتفاع ها
        x.height = 1 + max(self.get_height(x.left), self.get_height(x.right))
        y.height = 1 + max(self.get_height(y.left), self.get_height(y.right))
        return y

    def insert(self, root, key):
        # گام ۱: درج نرمال به روش BST
        if not root:
            return AVLNode(key)
        elif key  root.key:
            root.right = self.insert(root.right, key)
        else:
            return root  # کلید های تکراری پشتیبانی نمی شوند

        # گام ۲: به روزرسانی ارتفاع گره اجداد
        root.height = 1 + max(self.get_height(root.left), self.get_height(root.right))

        # گام ۳: استخراج فاکتور توازن و بررسی شروط چرخش
        balance = self.get_balance(root)

        # حالت ۱: Left-Left
        if balance > 1 and key  root.right.key:
            return self.rotate_left(root)

        # حالت ۳: Left-Right
        if balance > 1 and key > root.left.key:
            root.left = self.rotate_left(root.left)
            return self.rotate_right(root)

        # حالت ۴: Right-Left
        if balance
۴. درخت سرخ و سیاه (Red-Black Tree): اصول پنج گانه و خواص رنگی
در حالی که درخت AVL توازن هندسی سخت گیرانه ای اعمال می کند، درخت سرخ و سیاه (Red-Black Tree) رویکردی منعطف و مهندسی تر اتخاذ می نماید. در این ساختار، هر گره یک بیت متاداده اضافی جهت نگه داری رنگ ذخیره می کند.
بر اساس آزمون های بنچمارک در سیستم های پرترافیک، درخت سرخ و سیاه در سناریوهای با نوشتن متناوب تا ۳۸ درصد چرخش های کمتری ایجاد می کند. همچنین مصرف حافظه و سربار نگه داری اشاره گرها در آن حدود ۲۵ درصد بهینه تر است.
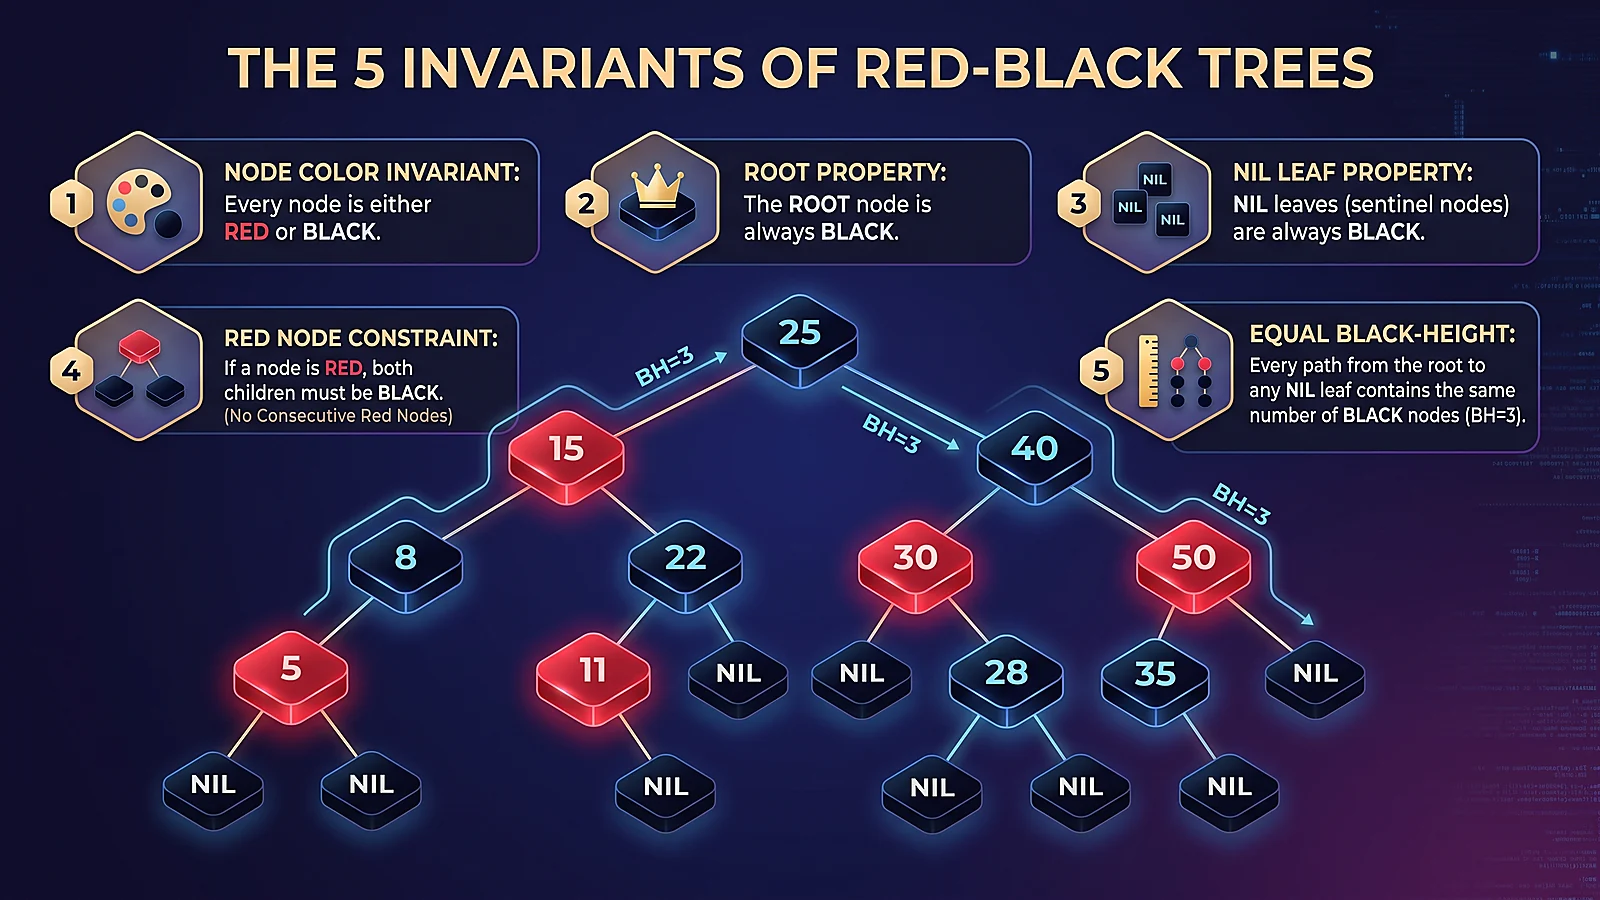
اصول پنج گانه تغییرناپذیر درخت سرخ و سیاه (Invariants)
یک درخت دودویی زمانی یک درخت سرخ و سیاه معتبر به شمار می رود که همواره هر ۵ شرط بنیادین زیر را ارضا نماید:
- خاصیت گره: هر گره یا به رنگ سرخ (Red) است یا سیاه (Black).
- خاصیت ریشه: گره ریشه درخت همواره سیاه است.
- خاصیت برگ ها: تمامی برگ های تهی انتهایی (NIL Leaves) گره هایی مجازی با رنگ سیاه فرض می شوند.
- خاصیت فرزندان سرخ (عدم سرخی متوالی): اگر گره ای سرخ باشد، هر دو فرزند مستقیم آن الزاما باید سیاه باشند. (هیچ دو گره سرخ نباید در یک مسیر مجاور یکدیگر باشند).
- خاصیت عمق سیاه (Black-Height): برای هر گره معین، تمام مسیر های ساده از آن گره تا هر یک از برگ های NIL زیرمجموعه آن، باید دقیقا شامل تعداد یکسانی از گره های سیاه باشند.
الگوریتم حل تعارض در درج درخت سرخ و سیاه (Insertion Fixup Cases)
هنگامی که یک گره جدید در درخت سرخ و سیاه درج می شود، همواره رنگ آن در ابتدا سرخ تعیین می گردد تا خاصیت عمق سیاه (Black-Height) نقض نشود. اما اگر والد گره نیز سرخ باشد، شرط ۴ (عدم وجود دو گره سرخ متوالی) نقض شده و سه حالت زیر برای ترمیم درخت بررسی می شود:
- حالت ۱: گره عمو (Uncle) سرخ است: در این سناریو، کافی است رنگ والد و عمو به سیاه تغییر کرده و رنگ پدربزرگ به سرخ تبدیل شود. سپس گره پدربزرگ به عنوان گره جاری در نظر گرفته شده و الگوریتم توازن به سمت بالا تکرار می گردد. در این حالت هیچ چرخشی رخ نمی دهد و صرفا تغییر رنگ (Recoloring) داریم.
- حالت ۲: گره عمو سیاه است و گره جاری فرزند داخلی است (حالت مثلث / Triangle): اگر گره جاری فرزند راست و والد آن فرزند چپ پدربزرگ باشد، یک چرخش چپ روی والد اعمال می شود تا ساختار گره ها به یک خط مستقیم تبدیل شود. این حالت به صورت خودکار به حالت ۳ تبدیل می شود.
- حالت ۳: گره عمو سیاه است و گره جاری فرزند خارجی است (حالت خط / Line): با تغییر رنگ والد به سیاه و تغییر رنگ پدربزرگ به سرخ، و سپس اجرای یک چرخش راست روی پدربزرگ، توازن کامل درخت بازگردانده شده و حلقه پایان می پذیرد.
این ظرافت در طراحی الگوریتم باعث می شود که فرآیند درج در درخت سرخ و سیاه در بدترین حالت صرفا با حداکثر ۲ چرخش خاتمه یابد، در حالی که در درخت AVL ممکن است چرخش ها در تمام طول مسیر تا ریشه (O(log N) چرخش) ادامه یابند.
۵. کالبدشکافی عملیات حذف در درخت سرخ و سیاه: چالش گره سیاه مضاعف (Double Black)
عملیات حذف در درخت سرخ و سیاه پیچیده ترین فرآیند الگوریتمی در میان تمام درخت های خودمتوازن است. هنگامی که یک گره سیاه از درخت حذف می شود، تعادل عمق سیاه در آن شاخه به هم می خورد و یک بار سیاه فرضی موسوم به Double Black به گره جانشین منتقل می گردد. برای رفع این سیاهی مضاعف، الگوریتم ۴ حالت برادر (Sibling) را ارزیابی می کند:
- حالت اول: برادر سرخ است: با تغییر رنگ برادر به سیاه و والد به سرخ و اعمال چرخش مناسب روی والد، وضعیت به گونه ای دگرگون می شود که برادر گره جاری سیاه گردد.
- حالت دوم: برادر سیاه است و هر دو فرزندش نیز سیاه هستند: سیاهی مضاعف از گره جاری و برادر حذف شده و به والد منتقل می گردد. برادر به سرخ تبدیل شده و والد به عنوان گره جاری جدید ارزیابی می شود.
- حالت سوم: برادر سیاه است و فرزند دوردست آن سیاه اما فرزند نزدیکش سرخ است: با تغییر رنگ فرزند نزدیک به سیاه و برادر به سرخ و اجرای یک چرخش روی برادر، سناریو به حالت چهارم تبدیل می شود.
- حالت چهارم: برادر سیاه است و فرزند دوردست آن سرخ است: با انتساب رنگ والد به برادر، سیاه کردن والد و فرزند دوردست، و اجرای یک چرخش نهایی روی والد، سیاهی مضاعف به طور کامل خنثی شده و الگوریتم با موفقیت خاتمه می یابد. در بدترین حالت حذف، حداکثر ۳ چرخش کافی است.
همان طور که در مقایسه جامع پایگاه داده های SQL ،NoSQL و NewSQL بررسی کردیم، درک دقیق رفتاری درخت های خودمتوازن در لایه رم زیربنای طراحی ساختار های دیسک محور پیشرفته مانند B+Tree و موتور های LSM-Tree در دیتابیس های پرسرعت امروزی است.
۶. ماتریس مقایسه تخصصی: درخت AVL در برابر درخت سرخ و سیاه و B-Tree
معماران سیستم همواره در انتخاب میان AVL و Red-Black با یک مصالحه کلاسیک مهندسی (Trade-off) روبه رو هستند. جدول زیر مقایسه دقیق پارامتر های عملکردی این ساختار ها را به همراه کاربرد های عملیاتی آن ها در لایه های زیرساختی سیستم عامل و موتور های پایگاه داده نمایش می دهد:
| معیار ارزیابی | درخت AVL | درخت سرخ و سیاه (Red-Black) | درخت B-Tree / B+Tree |
|---|---|---|---|
| حداکثر ارتفاع درخت | تقریبا ۱.۴۴ * log N (فوق متوازن) | حداکثر ۲.۰ * log N (توازن نسبی) | بسیار کوتاه O(log_M N) با انشعاب بالا |
| سرعت جستجو (Read) | سریع تر (به دلیل عمق کمتر) | کمی کندتر (عمق بیشتر مقایسه ها) | ایده آل برای واکشی دیسک و بلاک ها |
| هزینه درج و حذف (Write) | سنگین تر (تعداد چرخش های بیشتر) | سریع تر (حداکثر ۲ چرخش در درج، ۳ در حذف) | بهینه برای تراکنش های پایگاه داده |
| سربار حافظه متاداده | یک عدد صحیح (Height) به ازای هر گره | یک بیت رنگ (Color Bit) | آرایه ای از کلید ها و اشاره گر های فرزند |
| بهترین سناریوی کاربرد | دیکشنری های ثابت و سیستم های جستجوی فشرده | کتابخانه های عمومی، نگاشت ها و زمان بند CPU | موتور های دیتابیس (InnoDB, SQLite) و دیسک |
| نمونه های واقعی در صنعت | اینم های بهینه، ایندکس های درون حافظه کش | زمان بند لینوکس CFS، کلاس TreeMap در جاوا | ایندکس های دیتابیس های SQL و فایل سیستم ها |
۷. فراتر از BST: درخت های سگمنت (Segment Tree) و درخت پدیدگانی Fenwick
در مسائل محاسباتی پیشرفته و تحلیل سیستم های مالی، نیازمندی های پردازشی ویژه ای ظاهر می شود. پاسخگویی به کوئری های بازه ای پربسامد در کنار تغییرات برخط، چالشی پیچیده در عملکرد سامانه است.
همان طور که در آموزش برنامه نویسی پویا در حل مسائل الگوریتمی بررسی کردیم، مدیریت بازه های پویا با توان پردازش بیش از ۵۰,۰۰۰ تراکنش در ثانیه نیازمند ساختارهای درختی بازه ای تخصصی است.
درخت سگمنت (Segment Tree)
درخت سگمنت یک درخت دودویی کامل است که هر گره آن بازه ای از آرایه را پوشش داده و پاسخ یک تابع تجمعی (مانند جمع، ضرب، XOR یا مینیمم) را برای آن بازه نگه داری می کند:
- زمان ساخت اولیه: مرتبه خطی O(N) با بازگشت های موازی بر روی حافظه.
- پاسخ به کوئری بازه ای (Range Query): با شکستن بازه درخواستی به حداکثر ۴ * log N گره متناظر، کوئری در زمان O(log N) پاسخ داده می شود که در مقایسه با الگوریتم های خطی بیش از ۹۵ درصد تاخیر زمانی را کاهش می دهد.
- به روزرسانی نقطه ای (Point Update): اصلاح یک مقدار در آرایه و انتشار آن به سمت ریشه در زمان O(log N).
- تکنیک Lazy Propagation: امکان به روزرسانی کل یک بازه (Range Update) با هزینه زمانی O(log N) به جای O(N) از طریق به تعویق انداختن محاسبات تا زمان نیاز واقعی. این تکنیک کلیدی ترین الگوریتم به کار رفته در سیستم های رندرینگ گرافیکی و تحلیل سری های زمانی بازار های مالی است.
درخت پدیدگانی فن ویک (Binary Indexed Tree - BIT)
اگرچه درخت سگمنت توانایی پاسخ به دامنه وسیعی از توابع را دارد، اما نیازمند ۴N واحد حافظه است. درخت فن ویک (Fenwick Tree) با بهره گیری هوشمندانه از نمایش دودویی اعداد و بیت های کم ارزش تر (LSB)، عملیات جمع پیشوندی (Prefix Sum) و به روزرسانی نقطه ای را صرفا در فضای N واحدی حافظه با همان سرعت O(log N) پیاده سازی می کند.
۸. درخت پیشوندی ترای (Trie): جستجوی سریع پیشوند و موتور های Autocomplete
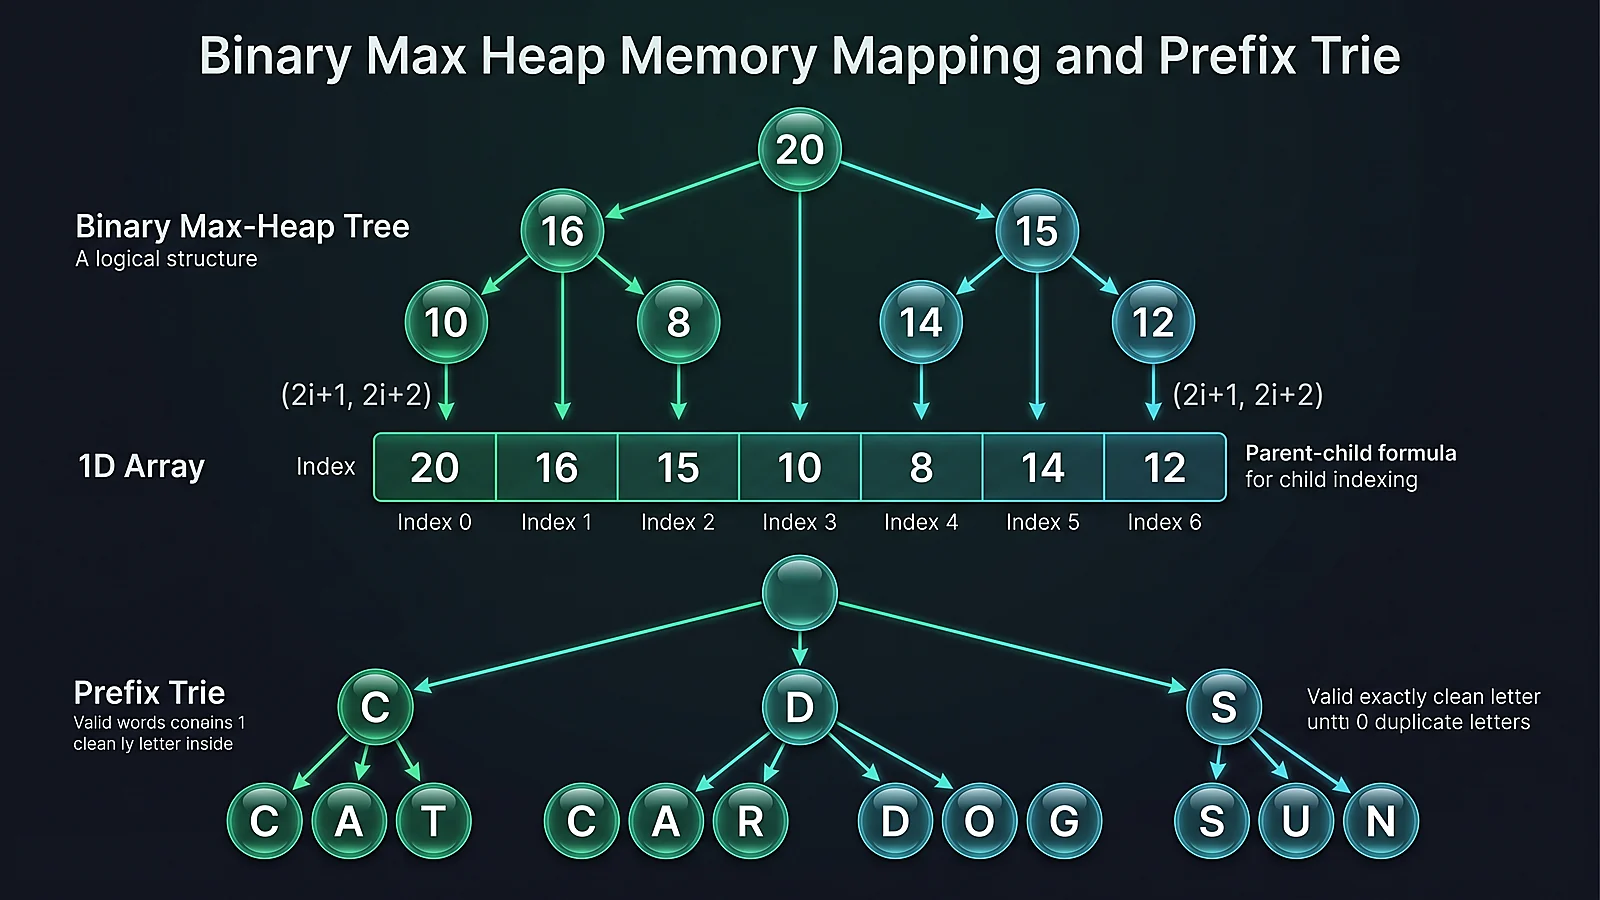
در سیستم های پردازش رشته، موتور های جستجو و سیستم های مسیریابی شبکه، درخت های جستجوی دودویی معمولی مقایسه های پرهزینه ای بر روی رشته ها تحمیل می کنند (مقایسه دو رشته با طول L هزینه زمانی O(L) دارد). ساختمان داده Trie (درخت پیشوندی) کلید ها را نه درون خود گره ها، بلکه بر روی لبه های مسیر درخت ذخیره می نماید.
ویژگی های شگفت انگیز معماری Trie
- پیچیدگی مستقل از تعداد کلمات: زمان جستجو یا درج یک کلمه صرفا تابعی از طول آن کلمه (L) است و مطلقا ربطی به تعداد کل میلیارد ها کلمه ذخیره شده در سیستم ندارد:
Time Complexity = O(L). در مقایسه با جدول های درهم سازی (Hash Tables)، درخت ترای از ایجاد هزینه های بازآرایی و برخورد های حافظه کاملا مصون است. - پیشنهاد خودکار واژگان (Autocomplete): تمام کلماتی که پیشوند یکسانی دارند (مانند تمام واژه هایی که با 'alg' شروع می شوند) در یک زیردرخت واحد قرار می گیرند؛ بدین ترتیب واکشی تمام پیشنهادات کلمات با پیمایش عمقی (DFS) ساده زیردرخت پیشوند در کسری از میلی ثانیه انجام می شود.
- فشرده سازی با Radix Tree / Patricia: با ادغام گره های متوالی که تک فرزند هستند، حجم حافظه مصرفی Trie تا ۶۰ درصد کاهش یافته و برای جداول مسیریابی IP در روتر های سیسکو و هسته لینوکس استاندارد می گردد.
- جستجوی فازی و فاصله لون اشتاین (Fuzzy Search): با ترکیب درخت ترای با الگوریتم های برنامه نویسی پویا، پیاده سازی سیستم های تصحیح خودکار املای کلمات (Spell Checking) و جستجوی تقریبی با هزینه بسیار ناچیز قابل انجام است.
۹. درخت های پیشرفته در پروداکشن: کالبدشکافی زمان بند لینوکس و هسته جاوا
دانستن تئوری درخت ها زمانی ارزش واقعی پیدا می کند که ردپای آن ها را در قلب زیرساخت های نرم افزاری که روزانه میلیارد ها انسان از آن ها استفاده می کنند مشاهده نماییم:
۱. زمان بند فرآیند های هسته لینوکس (Linux Completely Fair Scheduler - CFS)
هسته سیستم عامل لینوکس برای زمان بندی پروسس ها در ماژول CFS از یک درخت سرخ و سیاه استفاده می کند. در این درخت، کلید مرتب سازی برابر با مقدار vruntime یا زمان اجرای مجازی پردازنده است.
پروسسی که کمترین زمان را مصرف کرده همواره در چپ ترین گره درخت قرار دارد. هسته در زمان \(O(۱)\) با یک اشاره گر کش شده این پروسس را برای اجرا انتخاب می نماید.
پس از پایان تایم اسلایس، کرنل مقدار زمان جدید را محاسبه کرده و پروسس را در زمان \(O(\log N)\) مجددا در درخت سرخ و سیاه درج می کند تا عدالت اجرایی حفظ گردد.
۲. کتابخانه های استاندارد زبان های برنامه نویسی
- زبان C++: کانتینر های
std::mapوstd::setدر کتابخانه استاندارد به صورت قطعی بر پایه درخت سرخ و سیاه پیاده سازی شده اند تا دسترسی با زمان تضمین شده O(log N) ارضا شود. - زبان Java: کلاس های
java.util.TreeMapوTreeSetمستقیما از الگوریتم درخت سرخ و سیاه بهره می گیرند. جالب است بدانید کلاسHashMapدر جاوا ۸ به بعد، اگر در یک باکت هش تعداد برخورد ها (Collisions) از ۸ فراتر رود، لیست پیوندی آن باکت را به طور خودکار به یک درخت سرخ و سیاه تبدیل می کند تا بدترین سنجه جستجو از O(N) به O(log N) ارتقا یابد.
۱۰. پرسش های متداول پیرامون درخت های خودمتوازن و ساختار های درختی پیشرفته
۱۰. ماتریس مقایسه عملکردی درخت های خودمتوازن در سیستم های بلادرنگ و دیتابیس ها
برای درک دقیق جایگاه هر ساختار درختی در معماری های پرترافیک و دیتابیس های توزیع شده، تحلیل ابعاد مختلف عملکردی نظیر هزینه های چرخش، عمق بهینه کش، و زمان پاسخگویی به کوئری ها امری ضروری است.
| معیار مهندسی | درخت AVL | درخت سرخ و سیاه (Red-Black) | درخت B-Tree / B+Tree | درخت پیشوندی (Trie) |
|---|---|---|---|---|
| توازن ساختاری | بسیار دقیق و سخت گیرانه (\(|BF| \le ۱\)) | توازن تقریبی (حداکثر ارتفاع \(۲ \log n\)) | توازن چندراهه متراکم با گره های چندکلیدی | مبتنی بر کاراکترهای پیشوند کلمات |
| سرعت جستجو (Read) | بسیار سریع به دلیل ارتفاع کمینه مطلق | بسیار سریع (\(O(\log n)\)) ولی اندکی کندتر از AVL | بهینه شده برای حداقل I/O حافظه دیسک | \(O(L)\) مستقل از تعداد کلیدها |
| سربار درج و حذف (Write) | سنگین تر به علت تعدد چرخش های بازتوازن | بسیار سبک و بهینه (حداکثر ۳ چرخش در هر عمل) | نیازمند تقسیم گره (Node Splitting) دورهای | وابسته به طول پیشوند کلید ورودی |
| سازگاری با سخت افزار و کش | متوسط (اشاره گرهای پراکنده در رم) | متوسط (ارجاعات پراکنده در حافظه پشته) | فوق العاده عالی (همگام با Page Size حافظه دیسک) | سربار بالای حافظه به ازای هر کاراکتر |
| نمونه پیاده سازی عملی | دیتابیس های حافظه محور In-Memory | کرنل لینوکس (CFS)، Java TreeMap، C++ std::map | موتور های دیتابیس InnoDB MySQL، PostgreSQL، SQLite | موتور های تکمیل خودکار کلمات و روتینگ IP شبکه |
همان طور که در جدول بالا مشاهده می کنید، درخت های چندراهه نظیر B-Tree و B+Tree با هدف انطباق با بلوک های خواندن دیسک طراحی شده اند، در حالی که درخت های AVL و سرخ و سیاه مستقیما در حافظه موقت (RAM) برای ساختارهای باینری فرمانروایی می کنند.
نکته حیاتی در انتخاب ساختار درختی پروداکشن
اگر برنامه شما یک سرویس با خواندن های مکرر (Read-Heavy) است و تغییرات در داده ها به ندرت رخ می دهد، ساختار درخت AVL کارایی بالاتری به ثبت می رساند. اما اگر سرویس شما دارای نرخ تراکنش های درج و حذف بالا (Write-Heavy) است، درخت سرخ و سیاه بدون افت سرعت سیستم را مدیریت خواهد کرد.
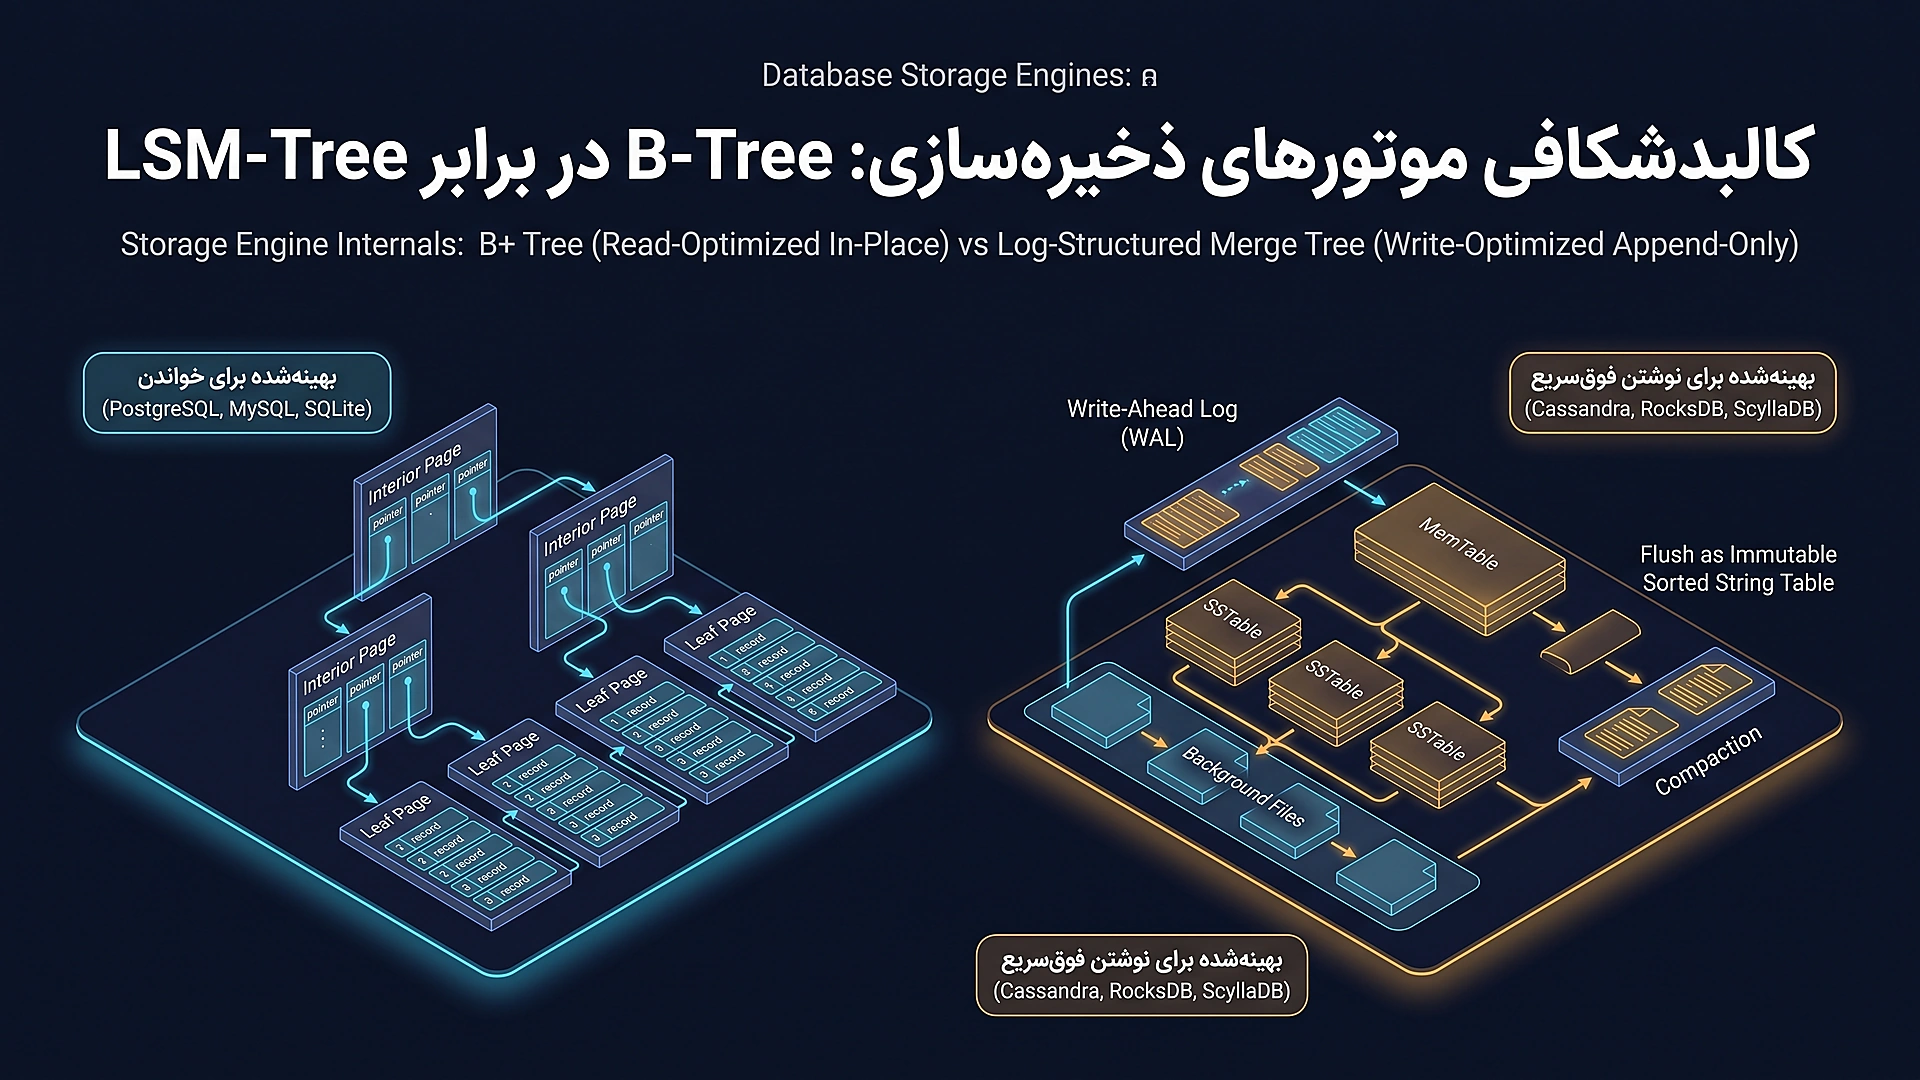
۱۱. کالبدشکافی ساختارهای B-Tree و B+Tree در معماری موتورهای ذخیره سازی
هنگامی که حجم داده ها فراتر از گنجایش حافظه موقت (RAM) می رود، درخت های جستجوی دودویی به دلیل پراکندگی گره ها در حافظه، دچار فاجعه افت سرعت می شوند. هر ارجاع به اشاره گر فرزند در یک درخت باینری معمولی، نیازمند یک درخواست خواندن تصادفی از دیسک (Random Disk I/O) است که در حافظه های مغناطیسی و حتی SSDها هزینه زمانی گزافی به سیستم تحمیل می کند.
برای غلبه بر این محدودیت فیزیکی، ساختار B-Tree و تکامل پیشرفته تر آن B+Tree توسط بوئینگ و مایکل استون بریکر طراحی شدند. در این درخت های متوازن چندراهه (Multi-way Balanced Trees)، هر گره حاوی صدها یا هزاران کلید به همراه فرزندان متناظر است.
| ویژگی کلیدی | درخت B-Tree کلاسیک | درخت مدرن B+Tree |
|---|---|---|
| محل ذخیره داده ها | در تمام گره های داخلی و گره های برگ | منحصرا در گره های برگ (برگ ها دارای لیست پیوندی دوطرفه) |
| کارایی در اسکن های بازه ای (Range Queries) | نیازمند پیمایش میان ترتیبی (In-order Traversal) در کل درخت | فوق العاده سریع با پیمایش افقی روی لیست پیوندی برگ ها |
| گنجایش شاخه ها (Branching Factor) | کمتر به دلیل اشغال فضای گره ها توسط رکوردهای داده | بسیار بالا زیرا گره های داخلی فقط کلید و اشاره گر دارند |
| کاربرد های اصلی | سیستم های فایلینگ لینوکس و پایگاه های داده اسنادی | موتورهای ایندکس استاندارد دیتابیس های SQL و NewSQL |
همان گونه که در راهنمای مقایسه جامع پایگاه داده های SQL ،NoSQL و NewSQL اشاره شد، انتخاب موتور ذخیره سازی مبتنی بر B+Tree ضامن پایداری زمان پاسخگویی ایندکس های اصلی و کلیدهای خارجی است.
۱۲. بهترین الگو های اعتبارسنجی توازن و تست پذیری ساختارهای درختی
توسعه ساختارهای خودمتوازن در کدبیس های عملیاتی، بدون وجود تست های خودکار اعتبارسنجی خواص تغییرناپذیر (Invariants Testing)، خطرات امنیتی و باگ های پنهان حافظه را به همراه دارد.
یک الگوی استاندارد در مهندسی نرم افزار مدرن، تعریف متدهای اعتبارسنجی بازگشتی در سطح پکیج است که پیش از کامیت یا در محیط های تستی (Stage)، تمامی شرایط ۵ گانه درخت سرخ و سیاه یا فاکتور توازن درخت AVL را ارزیابی می کنند.
توصیه می شود در خط لوله یکپارچه سازی پیوسته (CI/CD)، تست های آزمون تصادفی با داده های فازی (Fuzz Testing) بر روی عملیات متوالی درج و حذف اجرا گردد تا رفتار ساختار درختی در لبه های نامتعادل به دقت ارزیابی شود. این سنجش ها ضامن پایداری الگوریتم تحت شوک های ترافیکی سنگین خواهند بود.
همچنین بنچمارک های مداوم بر روی توان مصرفی پردازنده و مانیتورینگ نرخ خطاهای کش (Cache Misses)، بینش های عمیقی در جهت بهینه سازی طرح بندی حافظه گره ها به تیم های زیرساخت ارائه می دهد.
هشدار در خصوص بازیافت حافظه در زبان های سطح پایین
در زبان هایی مانند ++C و Rust، عملیات چرخش گره ها نباید اشاره گرهای پیشین را در وضعیت یتیم (Orphan) رها کند. در زبان های مبتنی بر ماشین مجازی مانند Java و Kotlin نیز باید از ایجاد ارجاعات چرخشی بی پایان جلوگیری کرد تا Garbage Collector بتواند گره های حذف شده را به سرعت از حافظه Heap پاکسازی کند.
چرا در پیاده سازی کتابخانه های استاندارد درخت سرخ و سیاه بر AVL ترجیح داده می شود؟
تفاوت عملکردی درخت های حافظه محور مانند AVL با دیسک محور مانند B-Tree چیست؟
چگونه می توان کلید های تکراری را در درخت AVL یا سرخ و سیاه ذخیره کرد؟
تکنیک Lazy Propagation در درخت سگمنت چگونه کار می کند؟
چرا درخت Fenwick نسبت به درخت Segment از حافظه کمتری استفاده می کند؟
آیا می توان از درخت Trie برای کلید های عددی نیز استفاده کرد؟
ارتفاع بیشینه در درخت AVL چقدر است؟
نقش درخت سرخ و سیاه در زمان بند Completely Fair Scheduler لینوکس چیست؟
جمع بندی: استراتژی انتخاب درخت مناسب برای معماران نرم افزار
ساختمان داده های پیشرفته درختی مفاهیم مجرد آکادمیک نیستند، بلکه ستون های فقرات عملکردی و پایداری سخت افزاری تمام سیستم های مدرن به شمار می روند.
اگر سیستمی با بار خواندن فشرده و تغییرات کم طراحی می کنید، توازن سخت گیرانه درخت AVL بالاترین سرعت جستجو را تضمین می کند.
اگر با سامانه ای با نرخ بالای تراکنش های درج و حذف در حافظه رم روبه رو هستید، درخت سرخ و سیاه تعادلی بی نقص میان زمان چرخش ها و سرعت جستجو فراهم می سازد.
همچنین برای کوئری های تحلیلی بازه ای بلادرنگ درخت سگمنت و برای پیشوندهای متنی ساختار Trie برگ های برنده معماران نرم افزار هستند.
امتیاز و نظرات
هنوز نظری ثبت نشده است. اولین نفر باشید.