
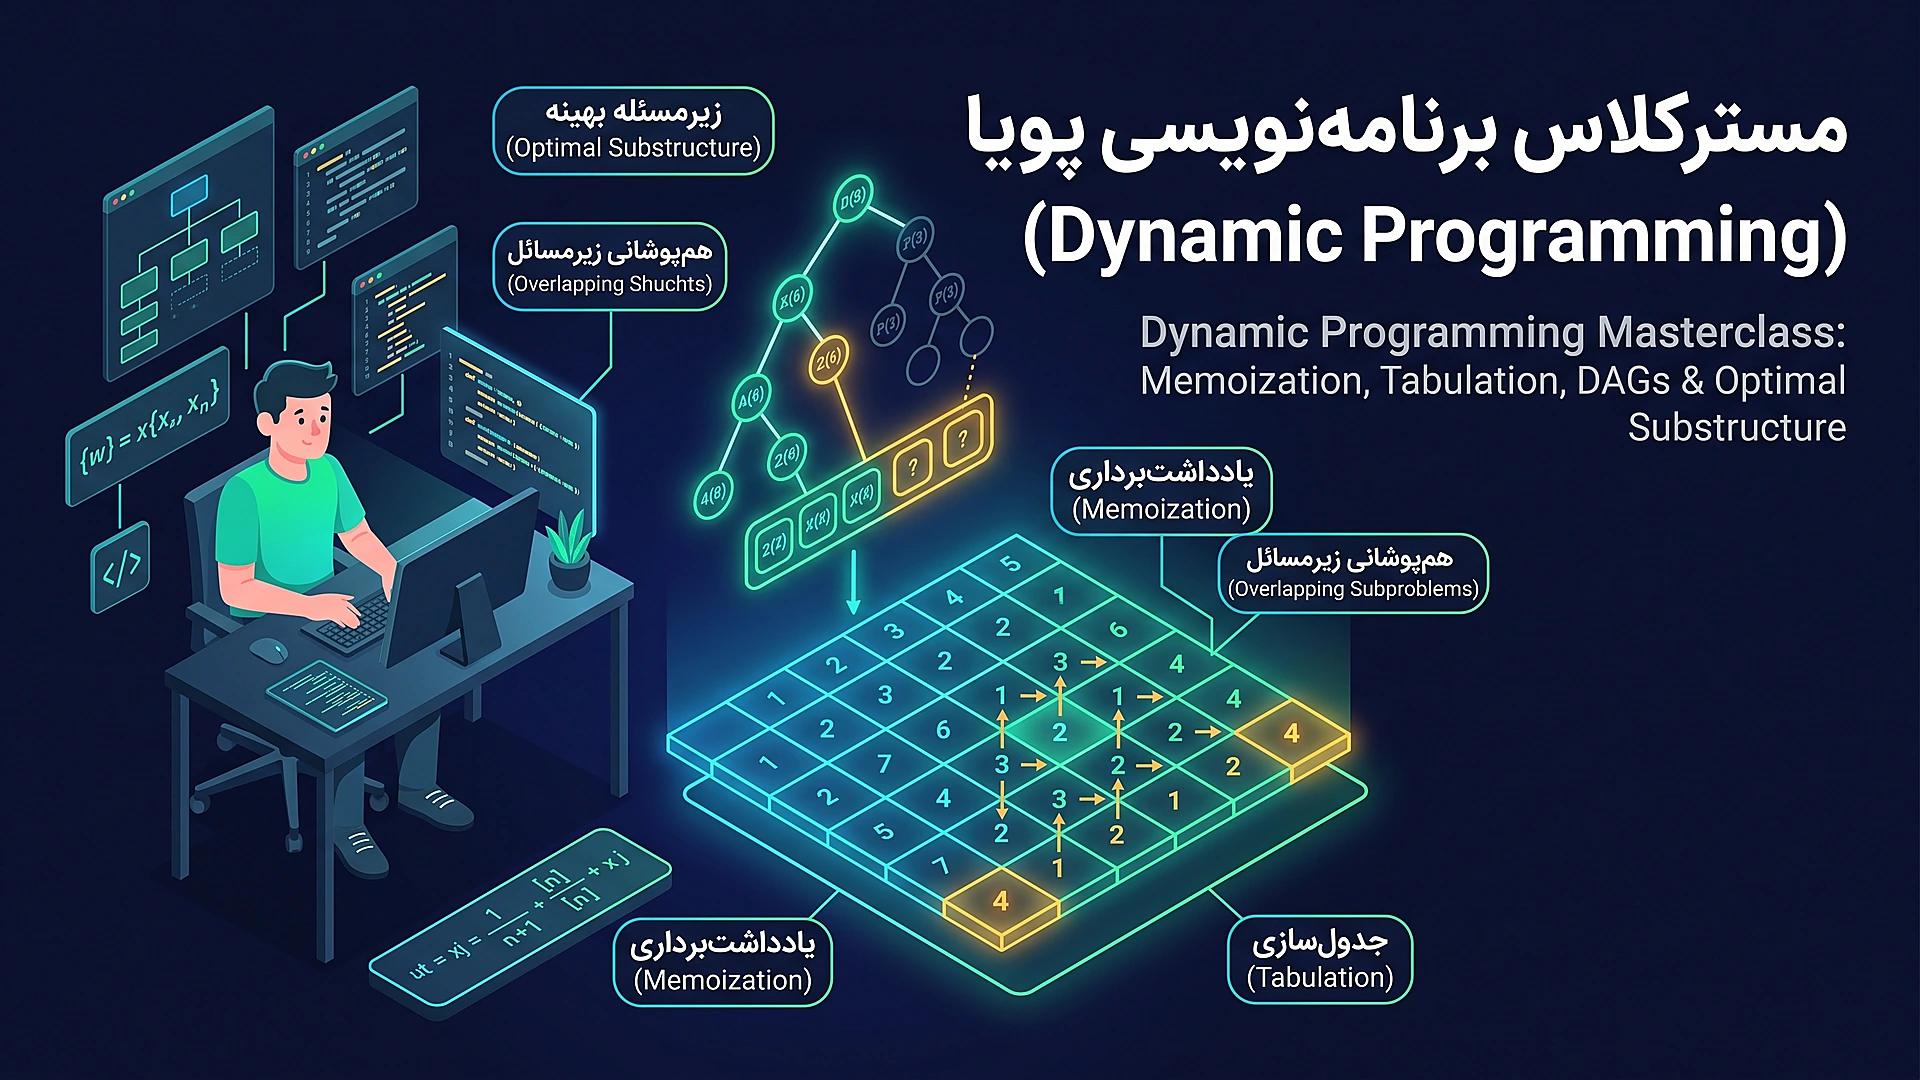
در میان تمام تکنیکها، الگوها و پارادایمهای طراحی الگوریتم در تاریخ علوم رایانه، برنامهنویسی پویا (Dynamic Programming) جایگاهی استثنایی، باشکوه و در عین حال چالشبرانگیز دارد. بسیاری از مهندسان نرمافزار، توسعهدهندگان سیستم و علاقهمندان به مصاحبههای استخدامی شرکتهای بزرگ فناوری نظیر گوگل، متا و آمازون، برنامهنویسی پویا را مرز نهایی بلوغ در تفکر محاسباتی قلمداد میکنند. علت این جایگاه ویژه در این واقعیت نهفته است که مسائلی با پیچیدگی محاسباتی هولناک نمایی نظیر O(۲ⁿ) یا O(n!) که حل آنها با روشهای جستجوی خام نیازمند سپری شدن میلیاردها سال بر روی سریعترین ابررایانهها است، با استفاده از بینش ریاضی برنامهنویسی پویا به الگوریتمهایی بسیار سبک، چشمنواز و چندجملهای نظیر O(n) یا O(n²) تبدیل میشوند. این مقاله به عنوان یک مرجع جامع، علمی و عملی، مبانی فلسفی، پایههای نظری ریاضی، تکنیکهای بالا به پایین و پایین به بالا بر مبنای تحلیل پیچیدگی الگوریتمها و نماد Big-O، الگوهای کلاسیک و روشهای پیشرفته کاهش ابعاد حافظه را به صورت عمیق و کالبدشکافانه مورد واکاوی قرار میدهد.
پیدایش تاریخی و راز نامگذاری برنامه نویسی پویا
برای هر مهندس کنجکاو، همواره این پرسش وجود دارد که چرا این پارادایم «برنامهنویسی پویا» نام گرفته است؟ آیا این اصطلاح به زبانهای برنامهنویسی پویا در مقابل ایستا اشاره دارد؟ پاسخ منفی است. ریشه این واژه به اوایل دهه ۱۹۵۰ میلادی و تلاشهای ریاضیدان نامدار آمریکایی، ریچارد بلمن (Richard Bellman) در موسسه پژوهشی RAND بازمیگردد.
در آن سالها، بلمن بر روی پروژههای تصمیمگیری چندمرحلهای برای صنایع دفاعی و هوافضا کار میکرد. واژه «برنامهنویسی» (Programming) در ادبیات نظامی و ریاضی آن برهه تاریخی، به معنای نوشتن کدهای باینری یا دستورات ماشین نبود؛ بلکه دقیقاً به معنای «برنامهریزی، زمانبندی جداول و بهینهسازی مسیرها» (Optimization & Scheduling) اطلاق میشد. بلمن واژه «پویا» (Dynamic) را به این دلیل به آن افزود که میخواست فرآیندهای تغییرپذیر در طول زمان و تصمیمگیریهای پیدرپی را مدلسازی کند. خود بلمن در زندگینامه خود با شوخطبعی اشاره میکند که از این ترکیب استفاده کرد تا اهمیت پروژهاش را در نگاه سناتورها و مدیران بودجه دولتی پررنگ نشان دهد؛ زیرا کسی نمیتوانست با واژهای به جذابیت و ابهت «برنامهنویسی پویا» مخالفت کند!
اما ورای این داستان تاریخی، در مهندسی نرمافزار امروز، برنامهنویسی پویا یعنی: «خرد کردن یک مسئله مرکب به مجموعهای از زیرمسئلههای سادهتر، حل کردن هر زیرمسئله فقط برای یک مرتبه، ذخیره پاسخ در حافظه کش، و سپس بازاستفاده از آن در تمام محاسبات بعدی». این اصل ساده اما بنیادین، پایه تمام جهشهای بازدهی در سیستمهای روتینگ اینترنت، هوش مصنوعی، گرافیک کامپیوتری و پایگاههای داده امروزی است.
دو رکن الزامی و خطکش تصمیمگیری برای بهکارگیری تکنیک پویا
یک اشتباه مهلک در میان توسعهدهندگان مبتدی این است که سعی میکنند برای هر مسئله بهینهسازی از برنامهنویسی پویا استفاده نمایند. برنامهنویسی پویا یک عصای جادویی همهمنظوره نیست؛ بلکه ساختار مسئله باید واجد دو ویژگی اکید ریاضی باشد. اگر هر یک از این دو شرط برقرار نباشد، پیادهسازی DP یا با شکست مواجه میشود یا اساساً بیمعنی خواهد بود:
رکن اول: زیرساختار بهینه (Optimal Substructure)
یک مسئله دارای «زیرساختار بهینه» است اگر و تنها اگر راهحل بهینه سراسری آن در ابعاد کلان، مستقیماً از ترکیب راهحلهای بهینه زیرمسئلههای کوچکتر تشکیل شده باشد. به زبان ریاضی، اگر بخواهیم کوتاهترین مسیر میان شهر مبدا A و شهر مقصد C را پیدا کنیم و بدانیم این مسیر از نقطه میانی B عبور میکند، مسیر منتخب الزاماً باید حاوی کوتاهترین مسیر از A به B و کوتاهترین مسیر از B به C باشد. اگر مسیر کوتاهتری از A به B وجود داشت، میتوانستیم آن را جایگزین کرده و طول کل مسیر تا C را کوتاهتر کنیم که این امر با فرض اولیه در تضاد است.
در مقابل، مسائلی وجود دارند که فاقد زیرساختار بهینه هستند؛ به عنوان مثال مسئله «طولانیترین مسیر ساده بدون دور در یک گراف». راهحل طولانیترین مسیر از A به C لزوماً از پیوند دادن طولانیترین مسیرهای میانی به دست نمیآید، چرا که انتخاب مسیر طولانی میان A و B ممکن است تمام گرههای میانی را مصرف کرده و اتصالی برای رسیدن به C باقی نگذارد.
رکن دوم: زیرمسئلههای همپوشان (Overlapping Subproblems)
این شرط همان چیزی است که برنامهنویسی پویا را از الگوریتمهای سنتی تقسیم و حل (Divide and Conquer) متمایز میسازد. در الگوریتمهایی نظیر مرتبسازی ادغامی (Merge Sort)، مسئله به دو نیمه تقسیم میشود؛ این دو نیمه کاملاً مستقل از یکدیگرند و هیچ نقطه مشترکی با هم ندارند. اما در مسائلی نظیر دنباله فیبوناچی، کولهپشتی، یا کوتاهترین مسیر، اگر ساختار فراخوانیهای بازگشتی را به صورت یک درخت ترسیم نمایید، متوجه خواهید شد که گرههای دقیقا یکسان در شاخههای گوناگون درخت صدها، هزاران یا میلیاردها بار تکرار میشوند!
برنامهنویسی پویا از این تکرارها استفاده حداکثری برده و با ساخت یک «حافظه میانی»، کارایی را به بالاترین سقف ممکن میرساند.
کالبدشکافی دو پارادایم بنیادین: بالا به پایین در برابر پایین به بالا
در معماری کدهای مبتنی بر برنامهنویسی پویا و تفکیک لایههای الگوریتمی منطبق با اصول معماری تمیز، دو استراتژی بنیادین برای پیمایش فضای حالات و پر کردن حافظه وجود دارد. درک عمیق رفتار موتور زمان اجرای سیستم، ردپای حافظه کالاستک، و کارایی کش پردازنده در این دو روش، تفاوت میان یک مهندس سیستم ارشد و یک برنامهنویس عادی را آشکار میسازد.
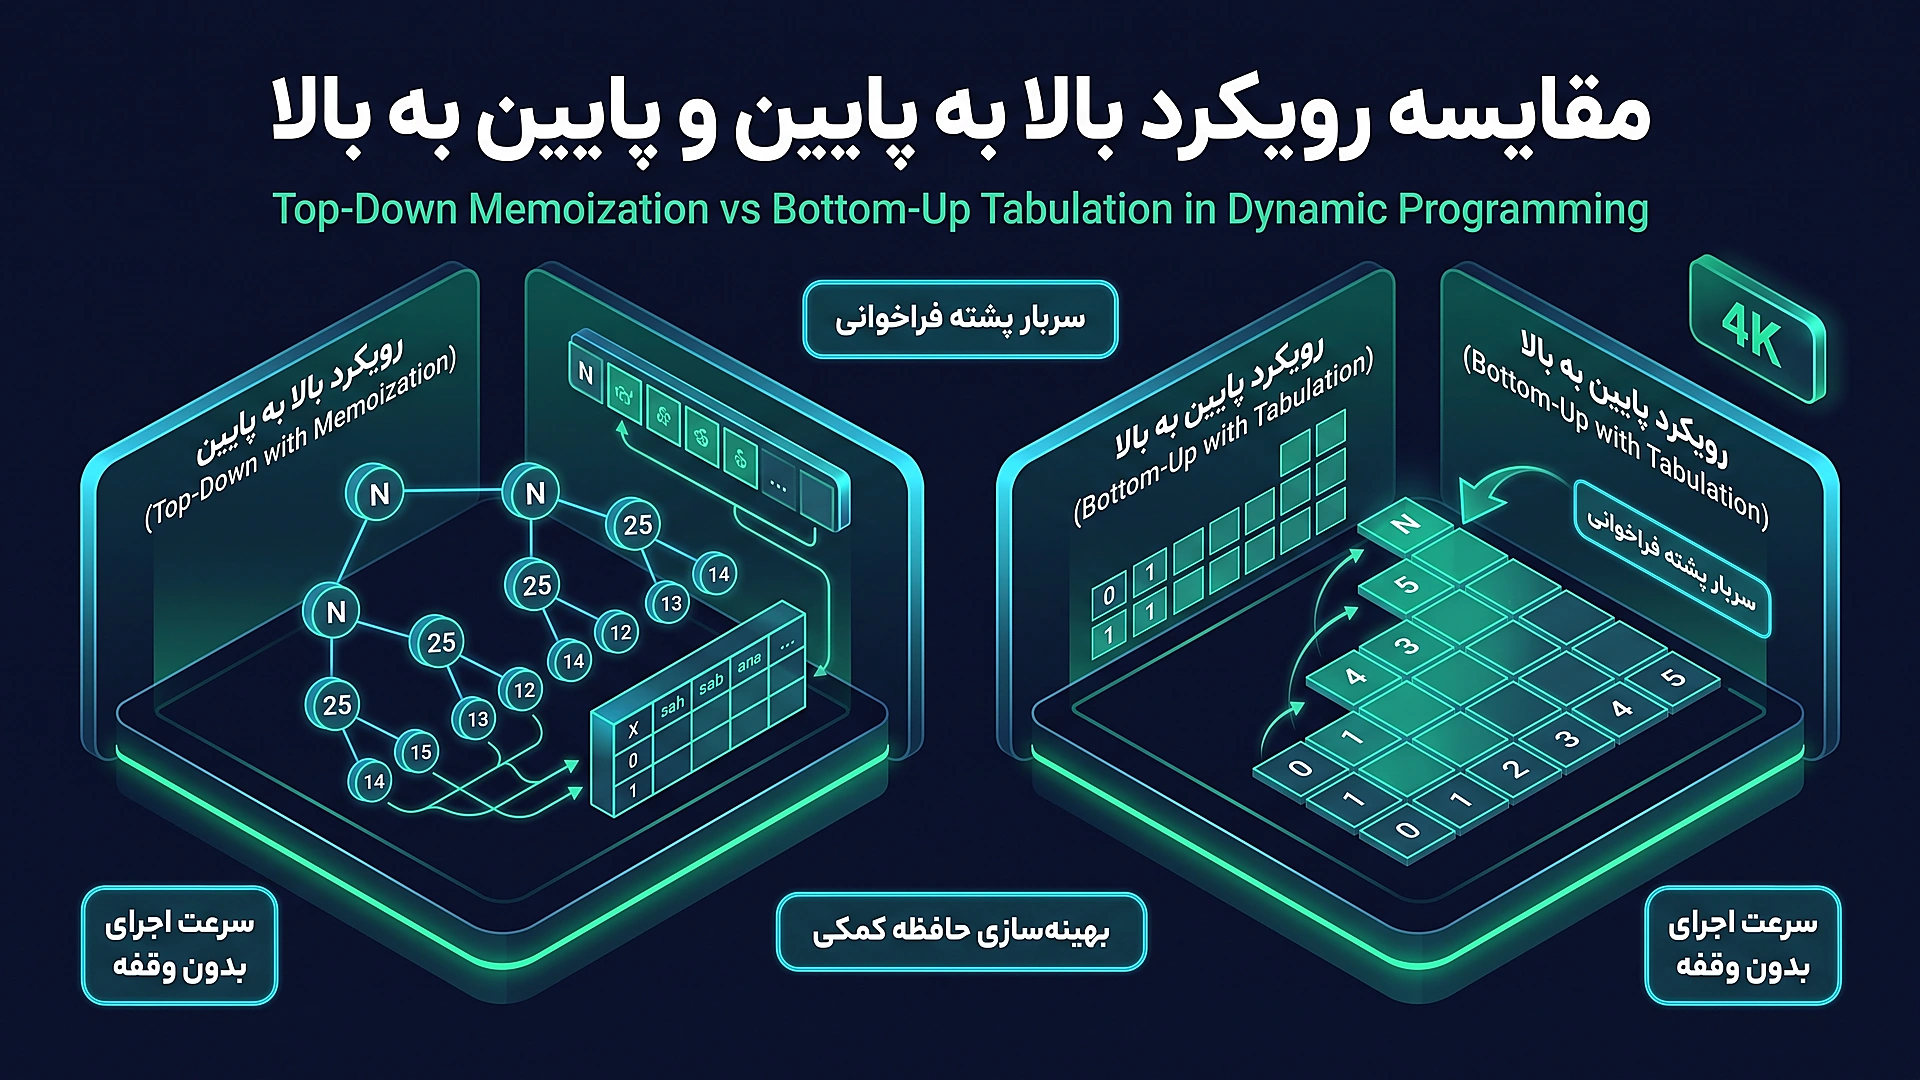
رویکرد بالا به پایین (Top-Down) با مکانیزم ذخیرهسازی نتایج (Memoization)
در این پارادایم، تفکر ما کاملاً منطبق بر منطق ریاضی طبیعی و شهودی مسئله است. ما حل مسئله را از حالت نهایی و بزرگ آغاز میکنیم و آن را در قالب یک تابع بازگشتی فراخوانی مینماییم. برای جلوگیری از محاسبات مجدد، یک جدول یا جدول درهمسازی (Hash Map) ایجاد میکنیم. قبل از اینکه تابع شروع به انجام محاسبات سنگین نماید، ابتدا این جدول را بررسی میکند. اگر نتیجه زیرمسئله مورد نظر در جدول حاضر بود، بلافاصله آن را بدون معطلی و در زمان ثابت O(۱) بازمیگرداند؛ در غیر این صورت، محاسبه را انجام داده و پیش از بازگشت، نتیجه را در جدول مینویسد.
مزیت استراتژیک Memoization: در این روش، ما فقط و فقط زیرمسئلههایی را محاسبه میکنیم که برای رسیدن به پاسخ نهایی قطبنمای الگوریتم به آنها احتیاج دارد. اگر در یک مسئله بسیار بزرگ با فضای حالات عظیم، تنها بخش اندکی از حالات در مسیر حل قرار گیرند، روش بالا به پایین بسیار سریعتر عمل میکند چرا که حالات بیهوده هرگز لمس نمیشوند.
چالشهای پنهان Memoization: هر فراخوانی تابع بازگشتی، یک فریم جدید در پشته فراخوانی سیستم (System Call Stack) ایجاد میکند که حافظه اضافی مصرف مینماید. در زبانهایی نظیر پایتون با محدودیت عمق بازگشت پیشفرض (Recursion Limit)، برای ورودیهای در مقیاس چند هزار با خطای RecursionError: maximum recursion depth exceeded مواجه خواهید شد. علاوه بر این، به دلیل پرشهای متوالی اشارهگر حافظه، خطوط حافظه کش پردازنده (CPU Cache Lines) به مراتب دچار تخریب یا Cache Miss میشوند.
رویکرد پایین به بالا (Bottom-Up) با متد جدولبندی (Tabulation)
در رویکرد پایین به بالا، بازگشت سیستم کاملاً دور انداخته میشود. ما مسئله را با معکوس کردن جهت تفکر حل میکنیم؛ یعنی ابتدا پایهایترین و کوچکترین زیرمسئلهها را حل کرده و پاسخ آنها را در یک ساختار داده پیوسته نظیر آرایه یا ماتریس قرار میدهیم. سپس با استفاده از حلقههای ترتیبی (Iterative Loops)، هر خانه جدید جدول را بر مبنای ترکیبی از خانههایی که در مراحل پیشین به طور کامل حل و مستقر شدهاند، پر میکنیم.
مزیتهای بیرقیب Tabulation:
- حذف کامل خطر سرریز پشته (Zero Stack Overhead): به دلیل استفاده از حلقههای تکرار، هیچ فریمی در پشته ذخیره نمیشود و میتوان برای میلیونها مرحله بدون ذرهای نگرانی از کرش کردن برنامه محاسبات را پیش برد.
- حداکثر بهرهوری از سختافزار (Spatial Locality & Cache Hits): دادهها در خانههای مجاور حافظه رم قرار دارند؛ کنترلر حافظه پردازنده به صورت خودکار بلاکهای بعدی را به کش سطح ۱ و ۲ میآورد و سرعت پردازش را تا چندین برابر در مقایسه با درختهای بازگشتی افزایش میدهد.
- امکان فشردهسازی فضا (Space Optimization): چون فرآیند ترتیبی است، اغلب میتوان ردیفهای قدیمیتر را که دیگر نقشی در محاسبات بعدی ندارند از رم پاک کرد یا جدول را به یک آرایه تکبعدی کاهش داد.
بررسی تجربی بر روی دنباله فیبوناچی
دنباله فیبوناچی با رابطه ریاضی F(n) = F(n-۱) + F(n-۲) و شروط پایه F(۰)=۰ و F(۱)=۱، شفافترین آزمایشگاه برای درک این پارادایمها است. کد زیر نسخه بازگشتی همراه با کش حافظه (Memoization) را نشان میدهد:
from typing import Dict

def fibonacci_memo(n: int, memo: Dict[int, int] = None) -> int:
    """محاسبه دنباله فیبوناچی به روش بالا به پایین همراه با Memoization (O(n) زمان و O(n) فضا)"""
    if memo is None:
        memo = {}
    if n in memo:
        return memo[n]
    if n <= 1:
        return n
    memo[n] = fibonacci_memo(n - 1, memo) + fibonacci_memo(n - 2, memo)
    return memo[n]
پیچیدگی زمانی این تابع از حالت نمایی O(۲ⁿ) به حالت خطی دقیق O(n) تقلیل یافته است؛ اما هنوز پیچیدگی فضایی آن به دلیل پشته بازگشت و دیکشنری O(n) است. حال همان مسئله را با الگوی جدولبندی پایین به بالا بازنویسی میکنیم:
def fibonacci_tabulation(n: int) -> int:
"""پیادهسازی پایین به بالا (Tabulation) با بردار خطی حافظه - حذف کامل کالاستک"""
if n <= 1:
return n
dp = [0] * (n + 1)
dp[0], dp[1] = 0, 1
for i in range(2, n + 1):
dp[i] = dp[i - 1] + dp[i - 2]
return dp[n]اکنون به اوج ظرافت مهندسی نگاه کنید: اگر دقت کنیم، برای محاسبه جمله iام فیبوناچی، ما به کل آرایه نیازی نداریم! ما فقط و فقط به دو جمله قبلی یعنی F(i-۱) و F(i-۲) احتیاج داریم. با استفاده از این بینش، میتوان کل آرایه را دور انداخت و با نگهداری دو متغیر ساده، مصرف حافظه را به مرتبه ثابت O(۱) رساند:
def fibonacci_space_optimized(n: int) -> int:
"""بهینهسازی فضا به مرتبه حافظه ثابت O(1) با تکنیک بافر لغزان"""
if n <= 1:
return n
prev2, prev1 = 0, 1
for _ in range(2, n + 1):
current = prev1 + prev2
prev2 = prev1
prev1 = current
return prev1چارچوب ۵ مرحلهای سیستماتیک برای حل هر مسئله برنامه نویسی پویا
بسیاری از توسعهدهندگان هنگامی که با یک صورت مسئله ناآشنا در پلتفرمهای ارزیابی فنی مواجه میشوند، بدون داشتن نقشه راه شروع به نوشتن کدهای درهمپیچیده میکنند. برای غلبه بر این سردرگمی، ما یک متدولوژی ۵ مرحلهای را تدوین کردهایم که مانند یک الگوریتم شفاف، ذهن مهندس را تا رسیدن به پاسخ بهینه هدایت مینماید:
- تعریف سمانتیک حالت (State Formulation): متغیرهایی را شناسایی کنید که وضعیت یکتا و بدون ابهام زیرمسئله را توصیف میکنند. مثلاً در مسئله جستجوی ماتریس، آیا حالت فقط مختصات سطر و ستون (i, j) است یا زمان باقیمانده نیز باید جزئی از حالت باشد؟ تعداد متغیرهای حالت، ابعاد جدول DP شما (یکبعدی، دوبعدی یا nبعدی) را مشخص میکند.
- فرمولهسازی رابطه انتقال حالت (State Transition Equation): کشف کنید که پاسخ یک حالت چگونه به صورت ریاضی از روی حالات پیشین تولید میشود. در این مرحله باید گزینههای پیش روی سیستم را تحلیل کنید (برداشتن یا برنداشتن یک آیتم، حرکت به راست یا پایین، تعویض یا حفظ یک کاراکتر).
- تعیین دقیق شرایط مرزی و مقداردهی اولیه (Base Cases): مرزهای جدول را مقداردهی کنید. اگر شرایط مرزی نادرست باشند یا حالات نامعتبر به جای بینهایت مثبت یا منفی با صفر مقداردهی شوند، کل محاسبات بعدی مسموم شده و با خطاهای منطقی مواجه خواهید شد.
- ترسیم نظم توپولوژیکی پر شدن جدول (Computation Order): مشخص کنید جهت حلقههای تکرار برای محاسبه خانهها باید چگونه باشد. اگر خانه dp[i][j] به مقادیر سطر قبل و ستون قبل وابسته است، باید پیمایش از چپ به راست و بالا به پایین انجام گیرد.
- بازسازی مسیر تصمیمگیری و استخراج راهحل (Reconstruction): اگر مسئله علاوه بر مقدار عددی بهینه، ترتیب گزینههای انتخابشده را نیز طلب میکند، با پیمایش معکوس جدول (Backtracking) مسیر طیشده را بازیابی نمایید.
کالبدشکافی عمیق مسئله کلاسیک کولهپشتی صفر و یک (۰/۱ Knapsack)
مسئله کولهپشتی صفر و یک سنگ بنای درک بهینهسازی ترکیبیاتی و مسائل NP-Complete با ماهیت شبهپلینومیال (Pseudo-polynomial) است. صورت مسئله به ظاهر ساده است: دزدی وارد یک موزه شده و با n شیء قیمتی مواجه است. هر شیء دارای وزنی معین w[i] و ارزشی معین v[i] است. دزد کولهپشتیای به همراه دارد که حداکثر تا سقف وزن W را میتواند حمل کند. هدف پیدا کردن ترکیبی از اشیاء است که وزن مجموع آنها از W بیشتر نشود و ارزش مجموع به بالاترین حد ممکن برسد. واژه «صفر و یک» تاکیدی بر این اصل است که یا باید یک شیء را به طور کامل داخل کوله قرار داد (۱) یا آن را رها کرد (۰) و شکستن اشیاء مجاز نیست.
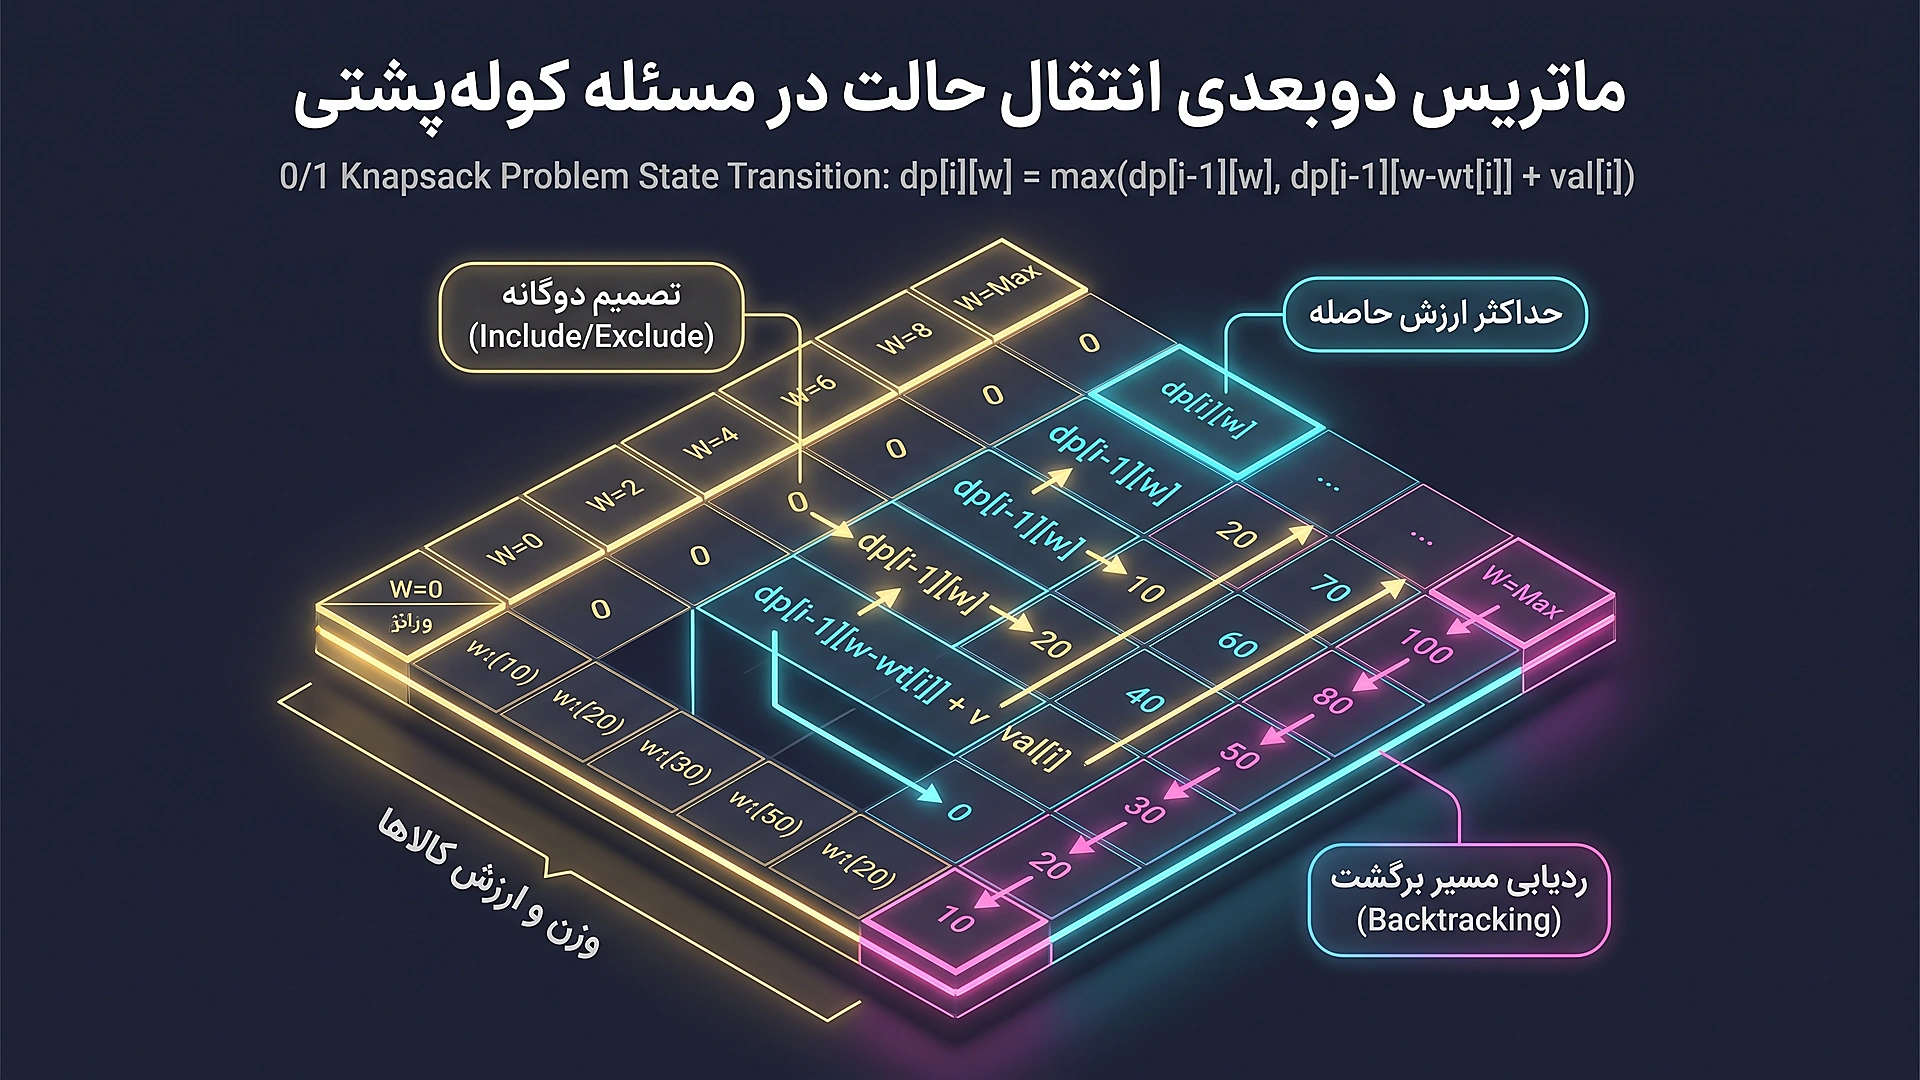
مدلسازی ریاضی ماتریس انتقال در کولهپشتی
جدول دوبعدی DP را به صورت dp[i][c] تعریف میکنیم که در آن:
- متغیر i (از ۰ تا n): در نظر گرفتن زیرمجموعهای شامل i آیتم اول.
- متغیر c (از ۰ تا W): ظرفیت مجاز فعلی کولهپشتی در این زیرمسئله.
- مقدار dp[i][c]: بیشترین ارزش قابل دستیابی با این i آیتم در ظرفیت c.
منطق انتقال حالت بر اساس یک دوراهی ساده استوار است:
۱. اگر وزن آیتم فعلی یعنی w[i-1] از ظرفیت فعلی c بیشتر باشد، اصلاً امکان گنجاندن این آیتم در کوله وجود ندارد؛ بنابراین بهترین ارزش دقیقاً برابر است با وضعیت بدون این آیتم:
dp[i][c] = dp[i-1][c]
۲. اما اگر وزن آیتم کمتر یا مساوی c باشد، ما دو حق انتخاب داریم و باید بیشینه آنها را انتخاب کنیم: یا آیتم را برنمیداریم (ارزش dp[i-۱][c])، یا آیتم را برمیداریم که در این صورت ارزش آن به بیشینه ارزش ظرفیت باقیمانده یعنی dp[i-1][c - w[i-1]] افزوده میشود:
dp[i][c] = max(dp[i-1][c], dp[i-1][c - w[i-1]] + v[i-1])
پیادهسازی کد پایتون استاندارد این ماتریس به شکل زیر است:
from typing import List
def knapsack_01_tabular(weights: List[int], values: List[int], capacity: int) -> int:
"""حل مسئله کولهپشتی صفر و یک با ماتریس دوبعدی انتقال حالت O(n·W)"""
n = len(weights)
dp = [[0] * (capacity + 1) for _ in range(n + 1)]
for i in range(1, n + 1):
w, v = weights[i - 1], values[i - 1]
for c in range(1, capacity + 1):
if w <= c:
dp[i][c] = max(dp[i - 1][c], dp[i - 1][c - w] + v)
else:
dp[i][c] = dp[i - 1][c]
return dp[n][capacity]پیچیدگی زمانی این الگوریتم O(n · W) و پیچیدگی فضایی آن نیز O(n · W) است. با توجه به اینکه W یک عدد عددی است و اندازه ورودی بیتهای آن log(W) میباشد، این الگوریتم در ادبیات پیچیدگی به عنوان شبهپلینومیال (Pseudo-polynomial Time) طبقهبندی میشود.
جادوی بهینهسازی حافظه: تقلیل ابعاد به یک بردار خطی O(W)
یکی از زیباترین دستاوردهای مهندسی الگوریتم، بهینهسازی فضایی کولهپشتی صفر و یک است. وقتی به رابطه بالا نگاه میکنیم، میبینیم که برای ساخت سطر iام، تنها و فقط به سطر قبلی یعنی i-۱ نیاز داریم. اگر بخواهیم کل ماتریس را با یک آرایه تکبعدی جایگزین کنیم، با یک چالش الگوریتمی مواجه میشویم: اگر حلقه ظرفیت c را از چپ به راست (صعودی) بپیماییم، مقادیری که در ستونهای اول سطر جاری تغییر میکنند، در محاسبات ستونهای جلوتر همان سطر اثر میگذارند؛ یعنی یک آیتم ممکن است چند بار انتخاب شود!
راهکار هوشمندانه: پیمایش ظرفیت c را به صورت معکوس (Descending از W به سمت وزن آیتم) انجام میدهیم. چون مقادیر ستونهای کوچکتر هنوز دستنخورده و متعلق به گام قبلی هستند، هر آیتم حداکثر یک بار اعمال میشود:
from typing import List
def knapsack_01_space_optimized(weights: List[int], values: List[int], capacity: int) -> int:
"""بهینهسازی فضا به آرایه خطی O(W) با تکنیک پیمایش معکوس ظرفیت"""
dp = [0] * (capacity + 1)
for w, v in zip(weights, values):
for c in range(capacity, w - 1, -1):
dp[c] = max(dp[c], dp[c - w] + v)
return dp[capacity]ردهبندی الگو های کلاسیک برنامه نویسی پویا در مهندسی نرمافزار
تقریباً تمام مسائل مطرح در مسابقات بینالمللی الگوریتم و پروژههای مقیاس وسیع، نسخههای تغییریافتهای از ۵ الگوی اصلی زیر هستند. شناخت عمیق این الگوها شالوده تسلط شما را تشکیل میدهد:
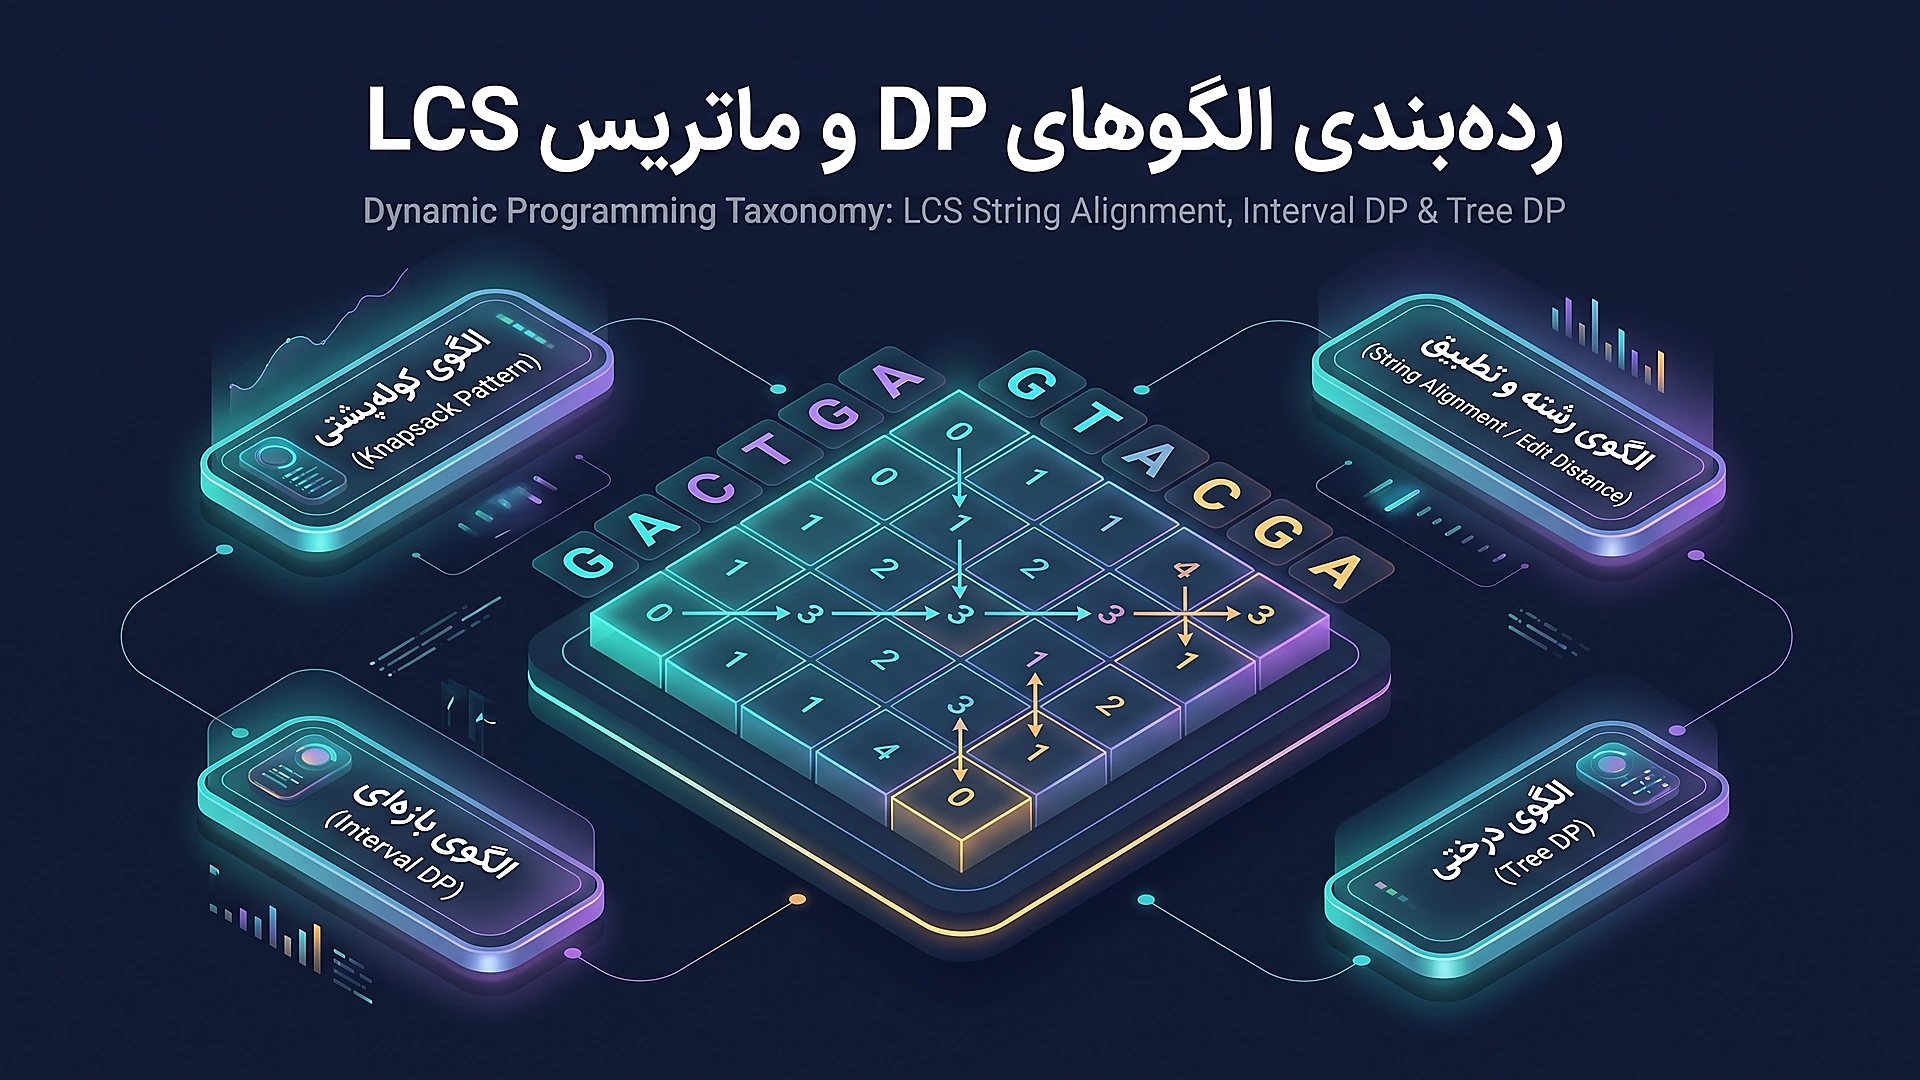
الگوی بلندترین زیردنباله مشترک (Longest Common Subsequence - LCS)
این الگو کاربردی شگفتانگیز در ابزارهای کنترل نسخه نظیر دستور diff در سیستم کنترل نسخه گیت (Git)، الگوریتمهای همترازسازی توالیهای DNA و پروتئینها در بیوانفورماتیک، و سیستمهای تلفیق داده دارد. در این مسئله، به دنبال طولانیترین زیردنبالهای هستیم که کاراکترهای آن بدون تغییر ترتیب در هر دو رشته ظاهر شوند (نیازی نیست کاراکترها در رشته اصلی پشت سر هم باشند).
def longest_common_subsequence(s1: str, s2: str) -> int:
"""الگوریتم LCS مورد استفاده در گیت دیف و تحلیل توالیهای ژنتیکی"""
m, n = len(s1), len(s2)
dp = [[0] * (n + 1) for _ in range(m + 1)]
for i in range(1, m + 1):
for j in range(1, n + 1):
if s1[i - 1] == s2[j - 1]:
dp[i][j] = 1 + dp[i - 1][j - 1]
else:
dp[i][j] = max(dp[i - 1][j], dp[i][j - 1])
return dp[m][n]الگوی فاصله ویرایش لووناشتاین (Edit Distance)
این الگوریتم زیربنای موتورهای تصحیح خودکار کلمات (Spell Checkers)، سیستمهای پردازش زبان طبیعی (NLP) و اعتبارسنجی شباهت ژنومها است. هدف پیدا کردن حداقل تعداد عملیات شامل «درج (Insert)»، «حذف (Delete)» و «جایگزینی (Replace)» برای تبدیل رشته اول به رشته دوم است:
def min_edit_distance(word1: str, word2: str) -> int:
"""الگوریتم فاصله ویرایش لووناشتاین (Levenshtein Distance)"""
m, n = len(word1), len(word2)
dp = [[0] * (n + 1) for _ in range(m + 1)]
for i in range(m + 1): dp[i][0] = i
for j in range(n + 1): dp[0][j] = j
for i in range(1, m + 1):
for j in range(1, n + 1):
if word1[i - 1] == word2[j - 1]:
dp[i][j] = dp[i - 1][j - 1]
else:
dp[i][j] = 1 + min(dp[i - 1][j], dp[i][j - 1], dp[i - 1][j - 1])
return dp[m][n]الگوی مسئله تعویض سکه (Coin Change Problem)
مسئله تعویض سکه نشان میدهد که چرا روشهای حریصانه (Greedy) در سیستمهای مالی و بانکی ناکافی هستند. اگر واحدهای ارزی شما شامل سکههای ۱، ۳ و ۴ تومانی باشد و بخواهید مبلغ ۶ تومان را با کمترین تعداد سکه بپردازید، الگوریتم حریصانه بزرگترین سکه یعنی ۴ را برمیدارد و سپس دو سکه ۱ تومانی انتخاب میکند (مجموعاً ۳ سکه). اما الگوریتم برنامهنویسی پویا کشف میکند که پاسخ بهینه استفاده از دو سکه ۳ تومانی (مجموعاً ۲ سکه) است:
from typing import List
def coin_change_min_coins(coins: List[int], amount: int) -> int:
"""کمینه تعداد سکهها برای ساخت مبلغ مشخص با پردازش مرزی ایمن"""
dp = [float('inf')] * (amount + 1)
dp[0] = 0
for coin in coins:
for x in range(coin, amount + 1):
dp[x] = min(dp[x], dp[x - coin] + 1)
return dp[amount] if dp[amount] != float('inf') else -1الگوی زیرآرایه با بیشترین مجموع و الگوریتم کادانه (Kadane's Algorithm)
پیدا کردن زیرآرایه پیوستهای از یک بردار عددی (حاوی اعداد مثبت و منفی) که مجموع عناصر آن بیشترین مقدار ممکن باشد، یکی از کاربردیترین مسائل در تحلیل سریهای زمانی مالی و دادههای بورس است. الگوریتم کادانه در حقیقت یک برنامهنویسی پویای یکبعدی فشرده است که در زمان خطی O(n) و حافظه ثابت O(۱) اجرا میشود:
from typing import List

def max_subarray_kadane(nums: List[int]) -> int:
    """الگوریتم کادین برای بیشترین مجموع زیرآرایه با رویکرد پویای خطی O(n)"""
    max_so_far = current_max = nums[0]
    for x in nums[1:]:
        current_max = max(x, current_max + x)
        max_so_far = max(max_so_far, current_max)
    return max_so_far
راهبردهای مهندسی برای بهینهسازی حداکثری حافظه و زمان
هنگامی که یک سرویس پردازشی تحت ترافیک میلیونها تراکنش همزمان قرار دارد، تفاوت میان پیچیدگی فضایی O(n) و O(۱) میتواند مانع از انفجار مصرف حافظه سرور و بروز خطای Out Of Memory گردد.
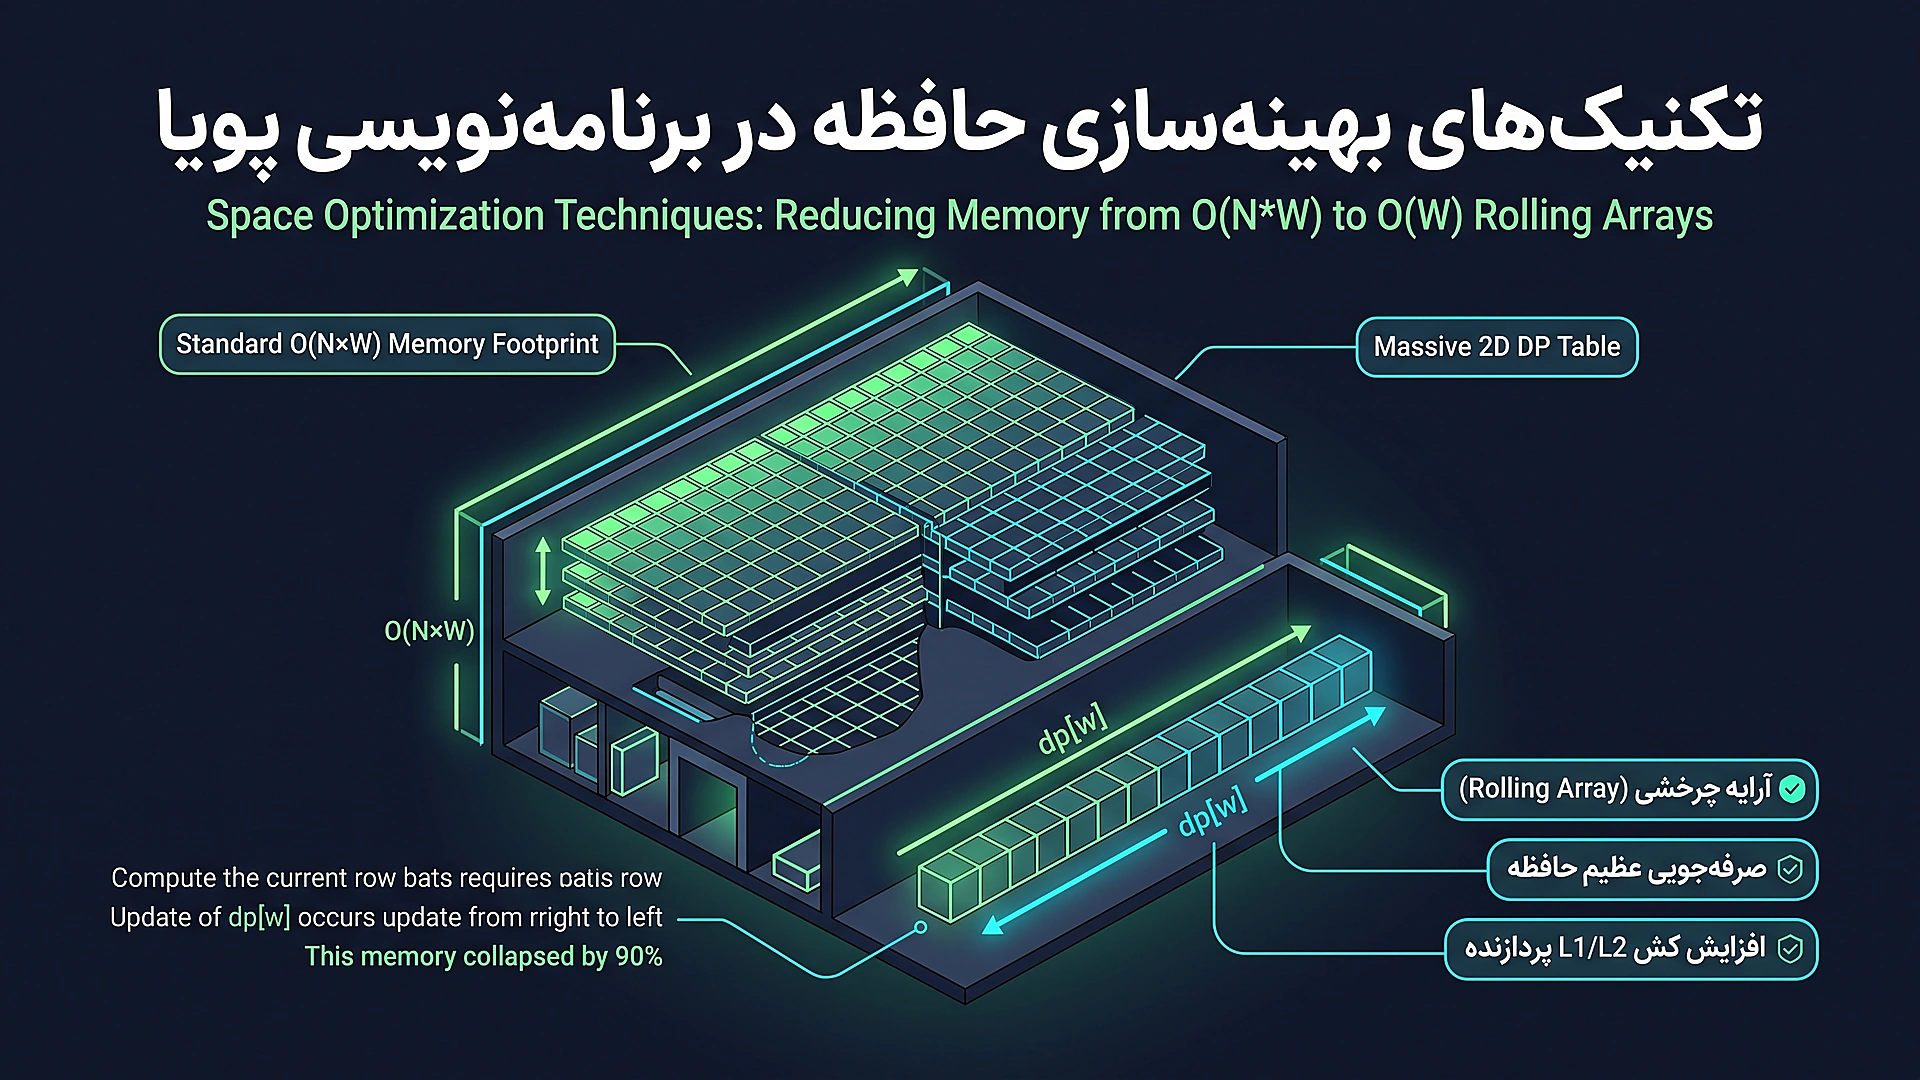
تکنیک بافر لغزان و پیمانه سطور (Rolling Array Technique)
اگر در یک ماتریس دو بعدی با ابعاد M × N، هر سطر تنها به سطر قبلی خود وابسته باشد، نیازی به تخصیص آرایه با M سطر نیست. کافی است آرایهای با ابعاد ۲ × N تعریف کنیم و اندیس سطر جاری را با i % 2 و سطر پیشین را با (i - 1) % 2 جایگزین کنیم. این تکنیک مصرف حافظه را از گیگابایت به کیلوبایت میرساند بدون آنکه منطق محاسباتی تغییر کند.
برنامه نویسی پویای فشردهشده با ماسک بیتی (Bitmask DP)
در مسائل انپی-سخت نظیر مسئله فروشنده دورهگرد (TSP) یا تخصیص بهینه تسکها به افراد، تعداد حالات به صورت زیرمجموعهها تعریف میشود. زمانی که تعداد اعضا کمتر از ۳۰ باشد، میتوان وضعیت دیده شدن یا نشدن هر عضو را درون بیتهای یک متغیر عددی ۳۲ بیتی (مانند integer) نگهداری کرد. چک کردن عضویت، اضافه کردن عضو و حذف عضو در این روش به کمک عملگرهای بیتی سختافزار نظیر AND و OR در تنها ۱ سیکل کلاک پردازنده انجام میشود.
ترفند پوش محدب و بهینهسازی شیب خط (Convex Hull Trick)
در مسائلی که رابطه انتقال حالت به صورت dp[i] = min(dp[j] + b[j] * a[i]) است، محاسبه کمینه در حالت عادی نیازمند یک حلقه داخلی O(n) است که پیچیدگی کل را به O(n²) میرساند. اما با مشاهده اینکه عبارت b[j] * x + dp[j] معادله یک خط راست با شیب b[j] است، میتوان با نگهداری پوش محدب پایینی این خطوط به کمک ساختار دادههای هندسی، بهترین انتقال را در زمان O(log n) یا حتی زمان استهلاکی O(۱) پیدا کرد که پیچیدگی کل را به O(n log n) کاهش میدهد.
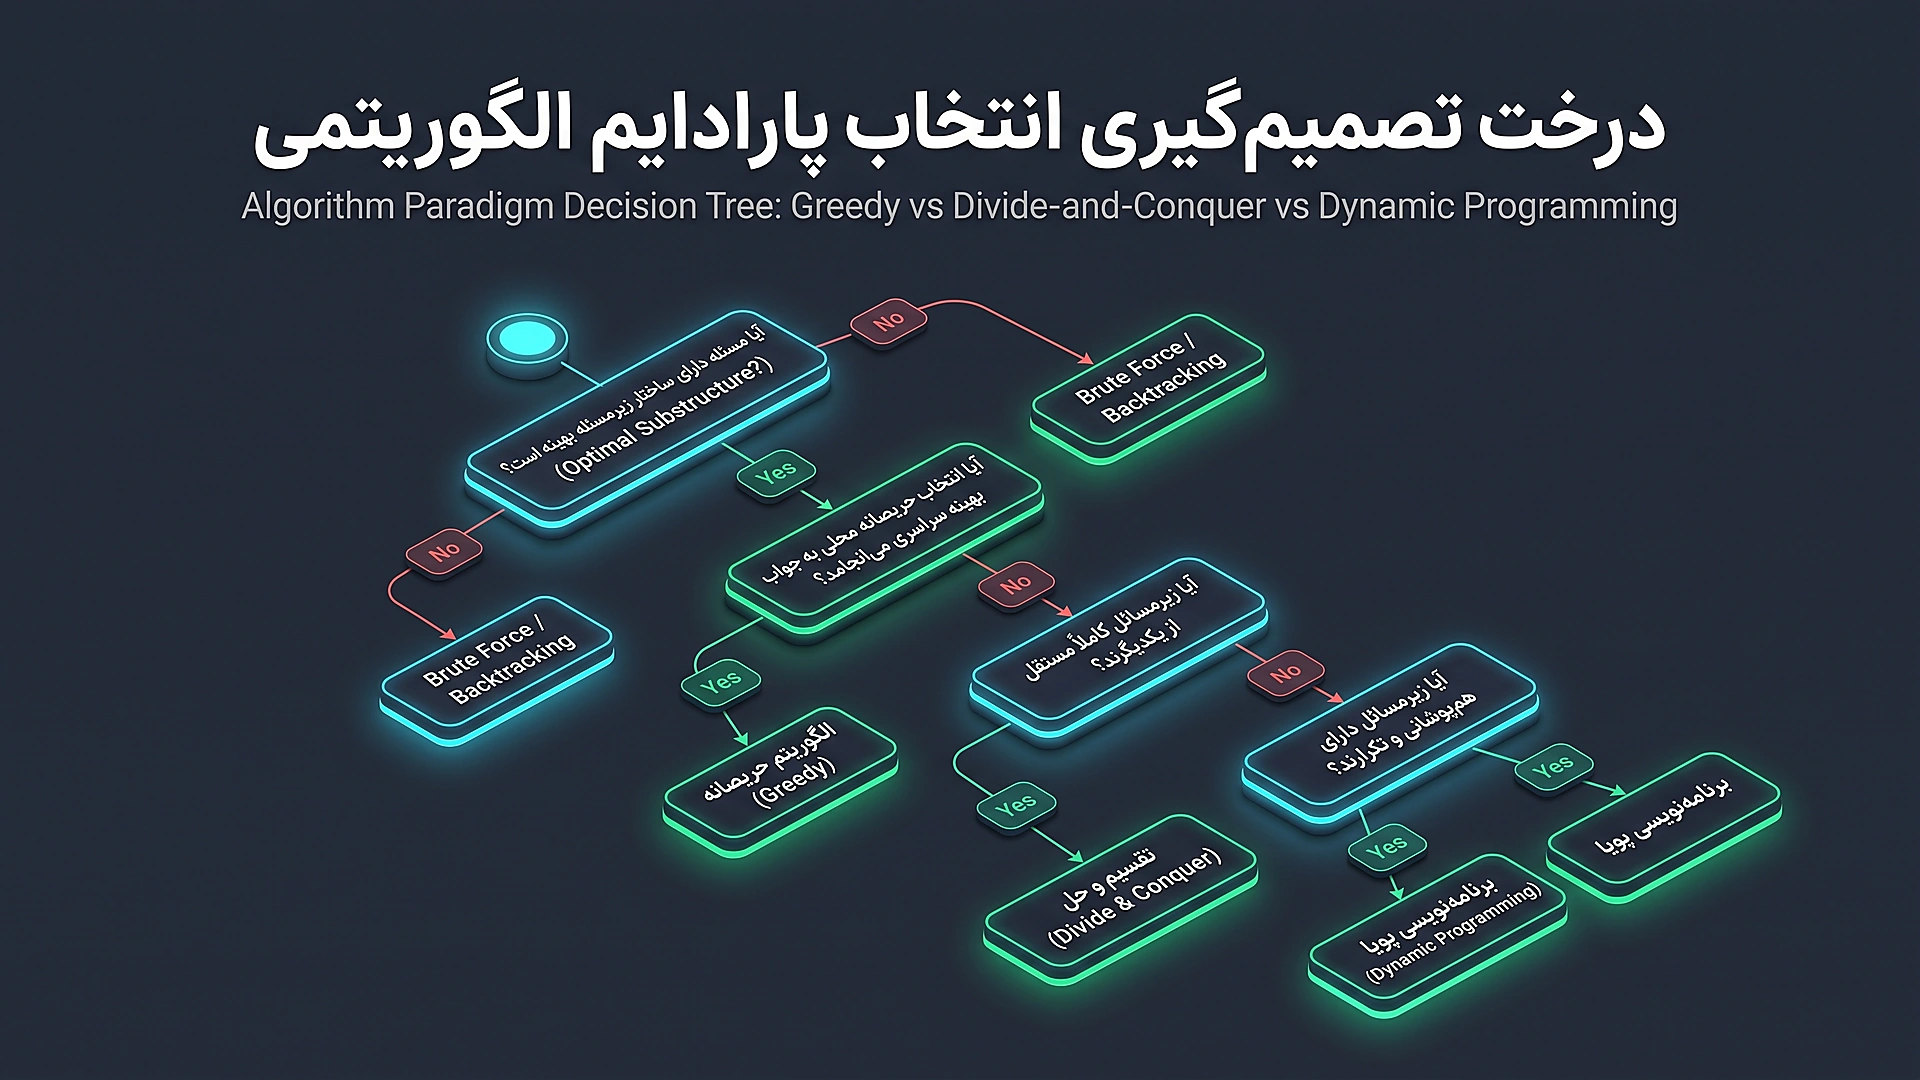
درخت تصمیمگیری برای انتخاب استراتژی الگوریتمی
چگونه در یک مصاحبه کاری پرفشار یا در حین بازطراحی یک سرویس گلوگاهی، در کمتر از دو دقیقه تشخیص دهیم که آیا مسئله نیازمند برنامهنویسی پویا است یا راهکارهای سادهتری وجود دارد؟ از فلوچارت تصمیمگیری زیر پیروی نمایید:
جدول جامع مقایسه الگوها، روابط بازگشتی و پیچیدگیها
این جدول خلاصه کاربردی، یک کارت مرجع سریع برای مرور قبل از آزمونهای مهندسی یا مستندسازی سیستمها است:
| الگو و مسئله | رابطه بازگشتی هسته | پیچیدگی زمانی | پیچیدگی فضایی بهینه | حوزه کلیدی کاربرد |
|---|---|---|---|---|
| دنباله فیبوناچی | F(n) = F(n-۱) + F(n-۲) | O(n) | O(۱) | مدلسازی رشد، تحلیل بازگشت |
| کولهپشتی ۰/۱ | max(dp[c], dp[c-w] + v) | O(n · W) | O(W) | تخصیص بودجه و سرور ابری |
| زیردنباله مشترک (LCS) | ۱ + dp[i-۱][j-۱] یا max(چپ, بالا) | O(m · n) | O(min(m, n)) | گیت دیف، بیوانفورماتیک DNA |
| فاصله ویرایش (Edit Dist) | ۱ + min(حذف, درج, تغییر) | O(m · n) | O(min(m, n)) | غلطیاب خودکار، مقایسه متنی |
| تعویض سکه (Coin Change) | min(dp[i], dp[i-coin] + ۱) | O(n · Amount) | O(Amount) | سیستمهای پرداخت و خودپردازها |
| بیشترین مجموع (Kadane) | max(num, current_max + num) | O(n) | O(۱) | تحلیل بازار بورس، پردازش تصویر |
کالبدشکافی خطاهای مهلک و الگو های ضدطراحی در برنامه نویسی پویا
پیادهسازی برنامهنویسی پویا در کدهای پروداکشن شرکتهای بزرگ، نیازمند تسلط بر خطاهایی است که در نگاه نخست در محیطهای توسعه محلی (Local) بروز نمیکنند اما زیر بار ترافیک یا دادههای حجیم، کل سرویس را ساقط مینمایند:
تله اول: سرریز حافظه استک در مقادیر ورودی بزرگ (Recursion Depth Exceeded)
هنگام استفاده از رویکرد بالا به پایین (Memoization)، هر فراخوانی بازگشتی یک فریم جدید در کالاستک نخ سیستمعامل (Thread Stack) ثبت میکند. در زبانهایی نظیر پایتون با سقف پیشفرض ۱۰۰۰ فراخوانی بازگشتی، یا در موتور V۸ نودجیاس و C++، اگر عمق بازگشت به دهها هزار برسد، با خطای سهمگین RecursionError یا Segmentation Fault: Stack Overflow روبرو خواهید شد. در سرویسهای پردازشی با مقیاس بالا، اگر عمق حالات زیاد است، الزاماً باید به رویکرد پایین به بالا (Tabulation) مهاجرت کنید که در آن حافظه در پشته (Heap) تخصیص مییابد و هیچ سرباری روی کالاستک ندارد.
تله دوم: محاسبه حالات نامعتبر و مسمومیت شروط مرزی (State Contamination)
در مسائلی مانند حداقل سکه (Coin Change) که به دنبال کمینه حالات ممکن هستیم، اگر برای حالتهای غیرممکن به جای یک مقدار نشانه بینهایت بزرگ از صفر استفاده کنید، عملگر min(dp[x], dp[x - coin] + 1) مقدار صفر را به عنوان بهترین پاسخ برداشته و تمام خانههای بعدی جدول با صفر آلوده میشوند. در مقابل، اگر از sys.maxsize در پایتون استفاده میکنید، باید مراقب باشید که جمع کردن آن با عدد ۱ در زبانهایی نظیر C++ یا Java سبب سرریز عدد صحیح (Integer Overflow) و تبدیل آن به یک عدد منفی بزرگ نشود!
تله سوم: نادیدهگرفتن پیمانه اعداد بزرگ در مسائل ترکیبیاتی (Large Modulo Arithmetic)
در مسائلی که از شما میخواهند «تعداد روشهای ممکن» برای رسیدن به یک وضعیت را بشمارید (نظیر مسیرهای یکتا در جدول یا چیدن کاشیها)، تعداد حالات به صورت نمایی رشد کرده و به سرعت از سقف اعداد صحیح ۶۴ بیتی فراتر میرود. در این سناریوها همواره باید در تکتک مراحل جمعبندی، باقیمانده بر پیمانه عدد اول بزرگ (معمولاً 10^9 + 7) را اعمال فرمایید:
dp[i] = (dp[i - 1] + dp[i - 2]) % 1000000007
نتیجهگیری و نقشه راه تسلط پایدار بر تفکر الگوریتمی
برنامهنویسی پویا صرفاً مهارتی برای پشت سر گذاشتن مصاحبههای استخدامی شرکتهای بزرگ نیست؛ بلکه یک سبک تفکر نظاممند در مهندسی نرمافزار است. این نگرش به شما میآموزد که هرگز با مسائل بزرگ و گیجکننده به عنوان یک توده غیرقابل هضم روبهرو نشوید، بلکه آنها را به حالات کوچکتر تفکیک کرده، نتایج تلاشهای قبلی را هوشمندانه ذخیره نمایید و پاسخ کلی را به شیوهای ظریف و قدرتمند بسازید.
برای نهادینهسازی این دانش، پیشنهاد عملی ما این است که تمرینهای خود را از مسائل ساده تکبعدی نظیر بالارفتن از پلهها (Climbing Stairs) و مسئله خانه دزد (House Robber) آغاز کنید. پس از تسلط کامل بر این موارد، به سراغ مسائل دوبعدی نظیر مسیرهای یکتا در ماتریس (Unique Paths) و کولهپشتی صفر و یک بروید. در گام نهایی، الگوهای رشتهای مانند LCS و Edit Distance و مسائل بهینهسازی بازهای را در برنامهنویسی روزمره خود تمرین کنید. هرگز معادلات انتقال حالت را حفظ نکنید؛ مفهوم معنایی هر خانه از حافظه را تجسم کنید تا هر مسئله نوظهوری را به سادگی مهار نمایید.
امتیاز و نظرات
هنوز نظری ثبت نشده است. اولین نفر باشید.