
الگوریتم هیبریدی TimSort در پایتون و جاوا
در دنیای واقعی، داده ها به ندرت کاملاً تصادفی هستند؛ کاربران معمولاً داده هایی را برای مرتب سازی میفرستند که بخشهایی از آن از قبل مرتب شده است. برای بهرهبرداری از این ویژگی، مهندس نرم افزار تیم پیترز (Tim Peters) در سال ۲۰۰۲ الگوریتم هیبریدی TimSort را طراحی کرد که ترکیبی شاهکار از MergeSort و InsertionSort است.
الگوریتم TimSort بخش های از قبل مرتبشده داده ها را (که به آن ها Run گفته میشود) شناسایی میکند. برای بخش های کوچک، از سرعت بالای InsertionSort بهره میگیرد و سپس این بخش ها را با منطق بهینهشده MergeSort با یکدیگر ترکیب مینماید. نتیجه شگفتانگیز است: اگر داده ها از قبل مرتب باشند، زمان اجرای TimSort به O(n) خطی کاهش مییابد؛ و در بدترین حالت نیز هرگز از O(n log n) فراتر نمیرود. به همین دلیل، موتورهای رسمی پایتون (تابع sort)، جاوا (برای اشیاء)، کاتلین، اندروید و موتور V۸ جاوااسکریپت همگی از TimSort به عنوان الگوریتم پیشفرض استفاده میکنند.
پایداری الگوریتم و مرتب سازی درجا
در انتخاب الگوریتم برای سیستم های تجاری، دو شاخص کیفی حیاتی وجود دارند:
- پایداری الگوریتم (Stability): یک الگوریتم مرتب سازی پایدار است اگر ترتیب اولیه عناصری که کلید مقایسهای یکسان دارند را تغییر ندهد. به عنوان مثال، اگر لیستی از مشتریان را ابتدا بر اساس «نام» سورت کرده باشید و سپس بر اساس «شهر» سورت کنید، یک الگوریتم پایدار (مانند TimSort یا MergeSort) ترتیب الفبایی اسامی افراد در هر شهر را حفظ میکند؛ در حالی که یک الگوریتم ناپایدار (مانند QuickSort معمولی یا HeapSort) ترتیب قبلی را در هم میریزد.
- مرتب سازی درجا (In-Place): الگوریتمهایی که نیازی به کپی کردن داده ها در بافر جدید ندارند و تنها با جابجایی خانه ها در همان آرایه ورودی کار میکنند (مانند QuickSort و HeapSort با حافظه کمکی O(۱) یا O(log n)). در سیستم های تعبیهشده یا اپلیکیشن های موبایل با محدودیت شدید حافظه، مرتب سازی درجا یک ضرورت غیرقابل مذاکره است.
تحلیل حافظه، پشته فراخوانی و سخت افزار
بسیاری از برنامه نویسان چنان درگیر کاهش ثانیه ها و زمان اجرای CPU میشوند که از بعد دوم و به همان اندازه حیاتی غافل میمانند: پیچیدگی حافظه یا فضای مصرفی (Space Complexity). در معماری های ابری، هزینه های ناشی از پر شدن حافظه رم و خطاهای Out-Of-Memory (OOM) بسیار مخربتر از کندی چند میلیثانیهای پردازنده است:
تفاوت حافظه کمکی و پشته فراخوانی بازگشتی
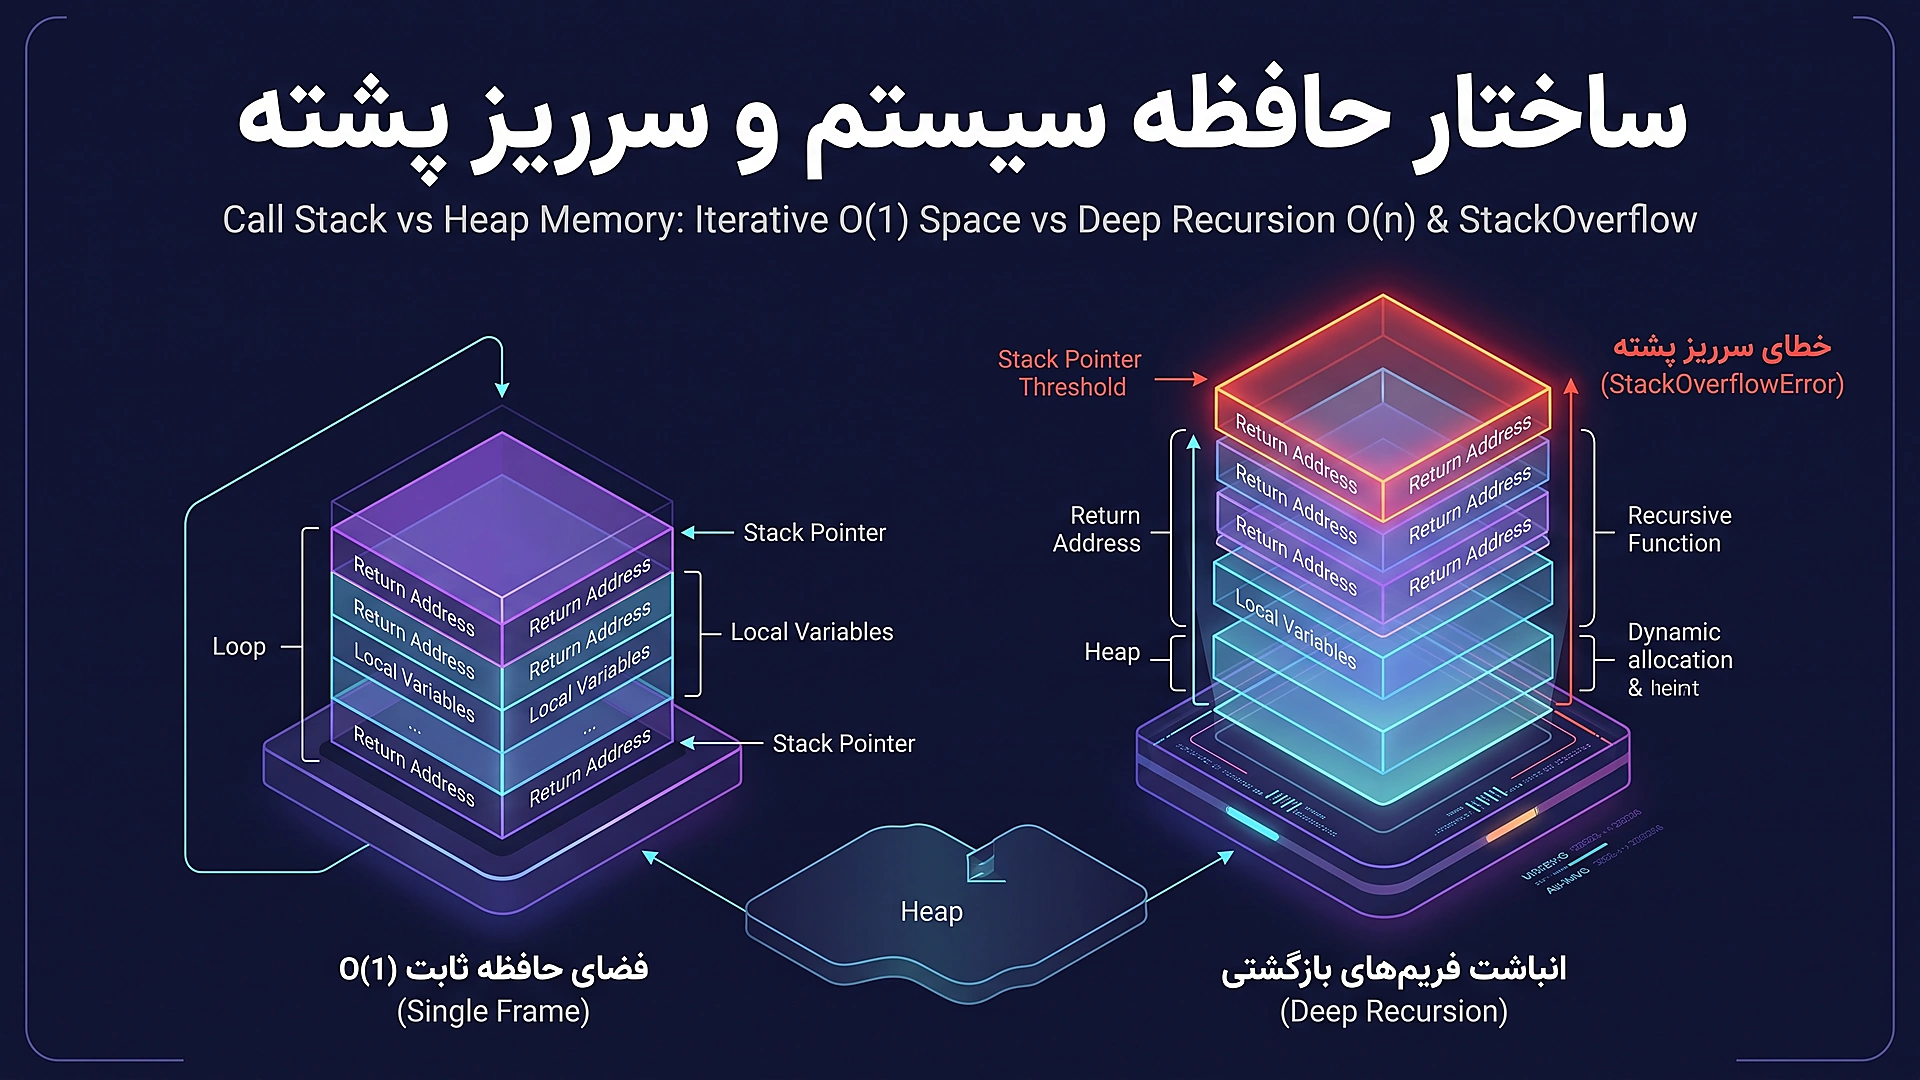
پیچیدگی حافظه کل یک الگوریتم از دو بخش تشکیل میشود: حافظه ورودی (Input Space) و حافظه کمکی (Auxiliary Space). هنگام تحلیل نماد Big-O برای حافظه، تمرکز اصلی ما بر روی حافظه کمکی است؛ یعنی حافظه اضافهای که الگوریتم برای پیشبرد پردازش به سیستمعامل تحمیل میکند.
یک خطای متداول این است که برخی تصور میکنند اگر در یک تابع بازگشتی، آرایه یا لیست جدیدی تعریف نشود، مصرف حافظه کمکی O(۱) است! این یک اشتباه مهلک است. هر بار که تابعی فراخوانی میشود، سیستمعامل یک فریم پشته (Stack Frame) جدید شامل آدرس بازگشت (Return Address)، آرگومان های ورودی و متغیرهای محلی را روی پشته نخ (Thread Stack) پوش میکند. اگر یک تابع بازگشتی تا عمق N پیش برود، دقیقاً O(N) حافظه پشته مصرف خواهد کرد.
خطر سرریز پشته در الگوریتم های بازگشتی
اندازه پشته نخ ها در سیستمعامل های سروری معمولاً عددی ثابت و محدود (بین ۱ تا ۸ مگابایت) است. اگر الگوریتمی با عمق بازگشتی بالا روی یک ورودی با اندازه صدهزار اجرا شود، پشته حافظه ظرف چند میلیثانیه لبریز شده و خطای مشهور java.lang.StackOverflowError یا Segmentation Fault در C++ رخ میدهد که پروسس را بلافاصله بدون هیچ فرصتی برای بازیابی ساقط مینماید.
به همین دلیل، در کدهای با قابلیت اطمینان بالا (High-Reliability Systems)، توابع بازگشتی باید یا به فرمت تکرارپذیر (Iterative) با حلقه های کنترلشده بازنویسی شوند، یا از کامپایلرهایی استفاده شود که از بهینه سازی فراخوانی دم (Tail-Call Optimization - TCO) پشتیبانی میکنند تا فریم قبلی پشته بدون ایجاد فریم جدید بازیافت گردد. کد زیر شیوه ردیابی و تفاوت مصرف پشته را به نمایش میگذارد:
import sys
def iterative_fibonacci(n: int) -> int:
"""
پیاده سازی تکرارپذیر فیبوناچی:
حافظه کمکی O(۱) با استفاده از دو متغیر ثبات پردازنده.
"""
if n <= ۱:
return n
a, b = ۰, ۱
for _ in range(۲, n + ۱):
a, b = b, a + b
return b
def recursive_depth_tracker(depth: int, max_depth: int):
"""
ردیابی مصرف پشته فراخوانی (Call Stack) در فراخوانی های بازگشتی عمیق:
مرتبه حافظه خطی O(n) به دلیل نگه داری Stack Frameها.
"""
if depth > max_depth:
return
# تخمین حجم هر استک فریم در پایتون ۶۴ بیتی
if depth % ۲۰۰ == ۰:
print(f"عمق فراخوانی: {depth:۴d} | مصرف حافظه پشته: ~{depth * ۴۸ / ۱۰۲۴:.۱f} کیلوبایت")
return recursive_depth_tracker(depth + ۱, max_depth)
print(f"سقف پیشفرض پشته در مفسر پایتون: {sys.getrecursionlimit()} فریم")
recursive_depth_tracker(۱, ۸۰۰)
تحلیل استهلاکی و رفتار آرایه های پویا
در بسیاری از ساختارهای داده، یک عملیات خاص ممکن است در ۹۹٪ مواقع بینهایت سریع (O(۱)) باشد، اما در یک درصد مواقع به دلیل نیاز به بازآرایی ساختار، به شدت کند و پرهزینه (O(n)) شود. اگر بخواهیم با دید سنتی بدترین حالت قضاوت کنیم، باید برچسب O(n) به کل عملیات بزنیم که تصویری ناعادلانه و گمراهکننده از بازدهی سیستم ارائه میدهد. برای حل این چالش، علم کامپیوتر تکنیک تحلیل استهلاکی (Amortized Analysis) را ابداع کرده است.
استراتژی دو برابر شدن هندسی ظرفیت
آرایه های پویا (مانند ArrayList در جاوا، vector در C++، و list در پایتون) را در نظر بگیرید. این ساختارها در لایه زیرین خود یک آرایه فیزیکی با ظرفیت ثابت دارند. وقتی عنصری را append میکنید، در خانه خالی بعدی قرار میگیرد که مرتبه O(۱) دارد. اما وقتی ظرفیت آرایه پر شد، سیستم باید:
- یک بافر جدید در حافظه با ظرفیت بیشتر تخصیص دهد.
- تمام N عنصر قبلی را یکییکی به بافر جدید کپی کند (هزینه O(n)).
- حافظه بافر قدیمی را آزاد نماید.
تفاوت میان یک معمار ارشد و یک برنامه نویس عادی در نحوه انتخاب استراتژی افزایش ظرفیت است:
- افزایش خطی ظرفیت (+K): اگر هر بار ظرفیت را با یک عدد ثابت (مثلاً ۱۰ خانه) افزایش دهیم، برای درج N عنصر باید به دفعات متوالی آرایه را کپی کنیم. مجموع کل عملیات کپی برابر میشود با مجموع یک تصاعد حسابی که مرتبه کل آن O(n²) فاجعهبار خواهد بود!
- دو برابر شدن هندسی (×۲ یا ×۱.۵): اگر هر بار ظرفیت فعلی را دو برابر کنیم، فواصل میان عملیات های سنگین کپی به صورت تصاعدی بیشتر و بیشتر میشود. در این حالت، هزینه کپی سنگین گذشته روی تمام درج های سریع آینده سرشکن (Amortized) میشود.
روش حسابداری و اثبات هزینه O(۱) در درج
در روش حسابداری تحلیل استهلاکی، فرض میکنیم برای هر عملیات درج ساده ۱ سکه انرژی مصرف میشود اما ما ۳ سکه پرداخت میکنیم: ۱ سکه برای درج فعلی، ۱ سکه پسانداز برای جابجایی خودش در بازتخصیص بعدی، و ۱ سکه پسانداز برای یکی از عناصر قدیمی که پسانداز ندارد. بدین ترتیب، وقتی زمان عملیات سنگین بازتخصیص فرا میرسد، مخزن پساندازها دقیقاً هزینه جابجایی را پوشش میدهد؛ بدون اینکه بار اضافهای به سیستم وارد شود.
بنابراین، هزینه استهلاکی درج در آرایه پویا با استراتژی رشد هندسی به صورت قطعی O(۱) Amortized اثبات میشود. در اسکریپت شبیه ساز زیر، اختلاف نجومی بین افزایش هندسی و افزایش خطی ظرفیت را به صورت عددی مشاهده میکنید:
class DynamicArray:
"""
کلاس شبیه ساز آرایه پویا جهت اثبات هزینه استهلاکی:
استراتژی دو برابر شدن هندسی در برابر افزایش ظرفیت خطی.
"""
def __init__(self, strategy: str = "double"):
self.capacity = ۱
self.length = ۰
self.data = [None] * self.capacity
self.strategy = strategy
self.total_copy_ops = ۰
def append(self, val):
if self.length == self.capacity:
old_cap = self.capacity
if self.strategy == "double":
self.capacity *= ۲
elif self.strategy == "linear":
self.capacity += ۵۰
new_data = [None] * self.capacity
for i in range(self.length):
new_data[i] = self.data[i]
self.total_copy_ops += ۱
self.data = new_data
self.data[self.length] = val
self.length += ۱
def run_amortization_demo(elements: int = ۵۰_۰۰۰):
arr_geom = DynamicArray(strategy="double")
for i in range(elements):
arr_geom.append(i)
arr_linear = DynamicArray(strategy="linear")
for i in range(elements):
arr_linear.append(i)
print(f"بنچمارک درج {elements:,} عنصر در آرایه پویا:")
print(f" استراتژی هندسی (O(۱) استهلاکی): {arr_geom.total_copy_ops:,} عملیات کپی کل")
print(f" استراتژی خطی (O(n) فاجعهبار): {arr_linear.total_copy_ops:,} عملیات کپی کل")
print(f" اختلاف فاجعهبار: استراتژی خطی {arr_linear.total_copy_ops / arr_geom.total_copy_ops:.۱f} برابر کپی بیشتر!")
run_amortization_demo(۵۰_۰۰۰)
تکنیک های بهینه سازی پروداکشن
هدف نهایی از یادگیری نظریه Big-O، توانایی بازنویسی و ریفکتور کدهای پروداکشن به منظور کاهش چشمگیر مصرف منابع سرور و ارتقای توان گذردهی (Throughput) سیستم است. در این بخش، الگو های مهندسی کلیدی برای تقلیل پیچیدگی از O(n²) به O(n) را بررسی میکنیم:
الگوی دو اشاره گر و پنجره لغزان
در مسائلی که با آرایه ها و رشته ها سر و کار دارند (مانند یافتن زیرآرایه با بیشترین حاصلجمع، جفت عناصر با فاصله معین، یا معکوس سازی داده ها)، رویکرد ناپخته معمولاً استفاده از دو حلقه تودرتوی for است که مرتبه زمانی O(n²) ایجاد میکند.
الگوی دو اشارهگر (Two Pointers) و پنجره لغزان (Sliding Window) به شما اجازه میدهد تنها با یک بار پیمایش آرایه (یک اشارهگر از ابتدا و یک اشارهگر از انتها، یا دو اشارهگر همجهت با فواصل متغیر)، همان مسئله را در زمان خطی O(n) و با حافظه کمکی O(۱) حل کنید. این الگو صدها برابر بار کاری پردازنده را کاهش میدهد.
تبدیل جستجوهای تودرتو به مپ با یک گذر
یکی از رایجترین سناریوهای افت کارایی در سرویس هایی وب، جستجوی همبستگی میان دو لیست است؛ به عنوان مثال تطبیق لیست تراکنش های بانکی با لیست کاربران. اگر برای هر تراکنش، کل لیست کاربران با یک حلقه جستجو شود، پیچیدگی O(M × N) خواهد بود که با صد هزار رکورد، سرور را متوقف میکند.
الگوی بهینه این است که ابتدا یک بار لیست کاربران پیمایش شده و در یک جدول درهم سازی (Hash Map) با کلید شناسه کاربر ایندکس شود (هزینه O(N) زمان و O(N) فضا). سپس در گذر دوم، لیست تراکنش ها پیمایش شده و برای هر تراکنش، کاربر در زمان O(۱) از مپ استخراج گردد. زمان کل پردازش از O(M × N) به O(M + N) سقوط میکند که به معنای جهش عملکردی در حد هزاران برابر است.
def two_sum_brute_force(nums: list[int], target: int):
"""الگوی مبتدی با حلقه های تودرتو: مرتبه فاجعهبار O(n²)"""
count = ۰
for i in range(len(nums)):
for j in range(i + ۱, len(nums)):
count += ۱
if nums[i] + nums[j] == target:
return (i, j), count
return None, count
def two_sum_hash_optimal(nums: list[int], target: int):
"""الگوی بهینه مهندسی با جدول درهم سازی: مرتبه خطی O(n) زمان و O(n) حافظه"""
seen = {}
count = ۰
for idx, val in enumerate(nums):
count += ۱
complement = target - val
if complement in seen:
return (seen[complement], idx), count
seen[val] = idx
return None, count
sample = list(range(۲۰_۰۰۰))
tgt = ۱۹_۹۹۹ + ۱۹_۹۹۸ # بدترین حالت در انتهای لیست
_, ops_brute = two_sum_brute_force(sample, tgt)
_, ops_opt = two_sum_hash_optimal(sample, tgt)
print("یافتن جفت با حاصلجمع هدف در ۲۰,۰۰۰ عنصر:")
print(f" حلقه های تودرتو O(n²): {ops_brute:,} مقایسه سنگین")
print(f" جدول درهم سازی O(n): {ops_opt:,} عملیات تکگذر ({ops_brute // ops_opt:,} برابر سریعتر!)")
ایندکس های ترکیبی در پایگاه های داده رابطه ای
در مهندسی بک اند و سیستم های سازمانی، بخش عمدهای از پیچیدگی های محاسباتی در لایه پایگاه داده رخ میدهد. وقتی کوئری فاقد ایندکس مناسب باشد، موتور پایگاه داده ناچار به انجام پویش کامل جدول (Full Table Scan) با مرتبه O(n) میشود. اگر جدول شامل ۱۰ میلیون رکورد باشد، این یعنی ۱۰ میلیون خواندن از دیسک، قفل شدن سطرها و افزایش نجومی زمان پاسخدهی (Latency).
با ایجاد ایندکس های درختی مناسب (B-Tree Composite Indexes)، جستجو به پیمایش درخت با مرتبه O(log n) تبدیل شده و تنها با ۳ الی ۴ واکشی صفحه از دیسک به پاسخ میرسد. در نمونه کد زیر با زبان کاتلین و در محیط JVM، این جهش خیرهکننده را شبیه سازی کردهایم:
import kotlin.system.measureTimeMillis

data class CustomerOrder(
    val orderId: Long,
    val userId: String,
    val amountCents: Long
)

fun main() {
    val totalRecords = ۱_۰۰۰_۰۰۰
    println("در حال شبیه سازی ۱,۰۰۰,۰۰۰ رکورد در حافظه JVM...")
    val orderTable = ArrayList<CustomerOrder>(totalRecords)
    val bTreeIndex = java.util.TreeMap<String, CustomerOrder>() // شبیه سازی ایندکس درختی متوازن B-Tree

    for (i in ۱..totalRecords) {
        val uid = "user_${i % ۲۵۰_۰۰۰}"
        val order = CustomerOrder(i.toLong(), uid, (۱۰۰..۵۰۰۰۰).random().toLong())
        orderTable.add(order)
        bTreeIndex[uid] = order
    }

    val targetUser = "user_۲۴۹۹۹۹"

    // ۱. پویش کامل جدول بدون ایندکس (Table Scan O(n))
    val tTableScan = measureTimeMillis {
        val match = orderTable.firstOrNull { it.userId == targetUser }
    }

    // ۲. جستجو در ایندکس درختی (B-Tree Index Lookup O(log n))
    val tIndexScan = measureTimeMillis {
        val match = bTreeIndex[targetUser]
    }

    println("نتایج مقایسه کوئری در مقیاس پروداکشن:")
    println("  پویش کامل جدول (Table Scan O(n)): ${tTableScan}ms")
    println("  جستجو با ایندکس درختی (Index O(log n)): ${tIndexScan}ms")
}
راهنمای تصمیم گیری و انتخاب الگوریتم مناسب
به عنوان یک مهندس نرم افزار، در آغاز طراحی هر ماژول یا حل هر چالش مهندسی، نیازمند یک چارچوب فکری منظم برای انتخاب ساختار داده و الگوریتم هستید. فلوچارت تصمیمگیری زیر، مسیر استاندارد این انتخاب را بر اساس محدودیت های زمانی، حافظه و ماهیت داده ها ترسیم میکند:
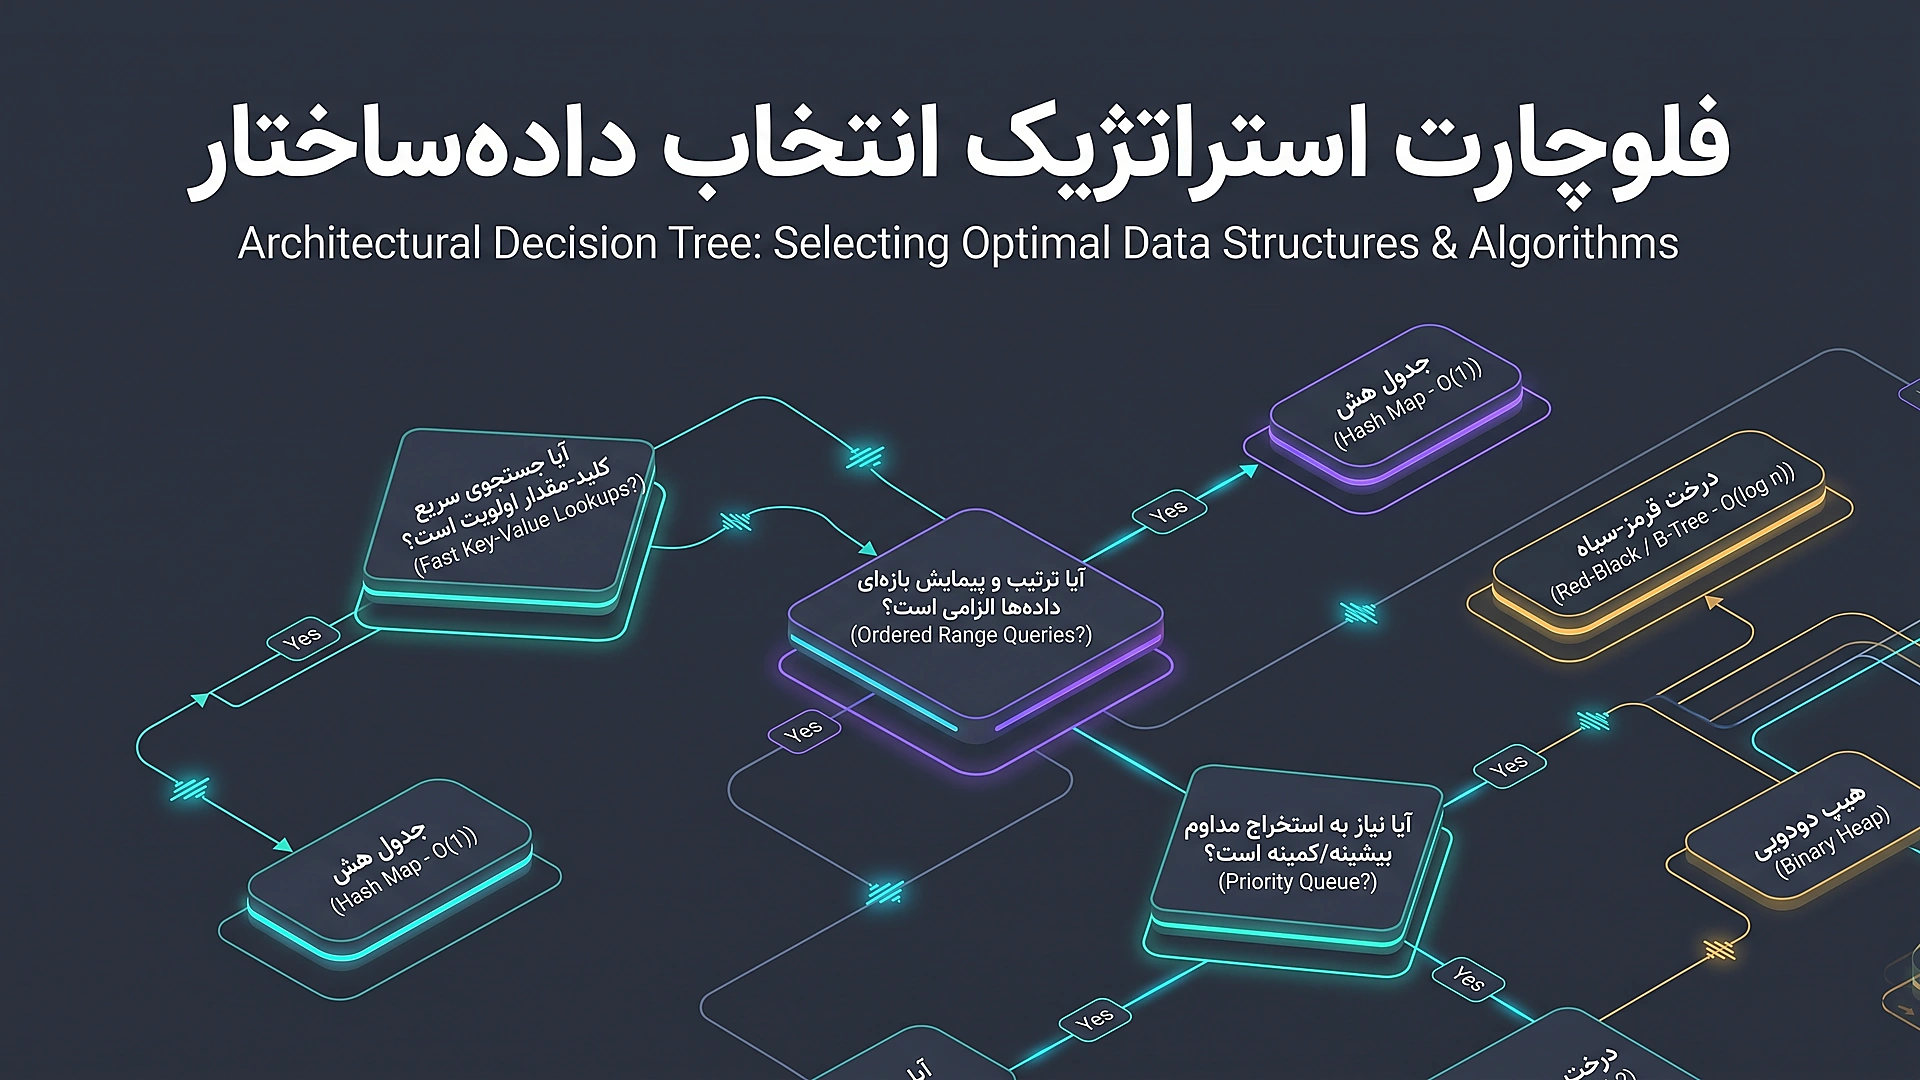
چک لیست انتخاب الگوریتم بر اساس محدودیت حافظه
هنگام مواجهه با یک مسئله مقیاس پذیری در پروداکشن، این ۵ پرسش کلیدی را پیش از کد نویسی از خود بپرسید:
- آیا حجم ورودی ثابت و محدود است یا نامتناهی رشد میکند؟ اگر داده ها هرگز از ۱۰۰ عنصر تجاوز نمیکنند، پیچیدگی O(n²) تفاوت محسوسی ایجاد نمیکند؛ اما اگر داده ها صعودی هستند، سقف معماری باید حتماً O(n log n) یا O(n) باشد.
- آیا داده ها از قبل مرتب شدهاند؟ در صورت مرتب بودن، الگوریتم های جستجوی دودویی O(log n) و دو اشارهگر O(۱) Space سریعترین گزینه ها هستند.
- بودجه حافظه رم چقدر است؟ آیا مجاز به استفاده از ساختارهای کمکی Hash Table با مصرف O(n) رم هستید یا باید عملیات کاملاً درجا (In-Place) با حافظه O(۱) اجرا شود؟
- آیا پایداری در مرتب سازی ضروری است؟ اگر برابری فیلدها نباید ترتیب اولیه را به هم بزند، از الگوریتم های پایداری چون TimSort و MergeSort استفاده کنید و از QuickSort ناپایدار اجتناب ورزید.
- رفتار کش سخت افزاری پردازنده چگونه است؟ آیا با ترجیح دادن آرایه های پیوسته میتوان از مزیت L۱/L۲ Cache Locality بهره مند شد و تاخیرها را به حداقل رساند؟
بایدها و نبایدهای بهینه سازی زودهنگام
دانشمند بزرگ کامپیوتر دونالد کنوت (Donald Knuth) جمله مشهوری دارد: «بهینه سازی زودهنگام، ریشه تمام بدی ها در برنامه نویسی است (Premature optimization is the root of all evil).» درک درست این گزاره برای مهندسان حیاتی است:
کنوت هرگز نمیگفت مرتبه Big-O را نادیده بگیرید و کدهای O(n²) شلخته بنویسید! منظور او این بود که وقت خود را صرف بهینه سازی های ریز مقیاس در بخشهایی از برنامه که تنها ۱٪ زمان سیستم را مصرف میکنند تلف نکنید. معماری بنیادین و طراحی الگوریتمی سیستم را همواره از ابتدا با معیارهای درست مقیاس پذیری Big-O پایهریزی کنید؛ اما بهینه سازی های خطبهخط، کشینگ های پیچیده و کدهای غیرخوانا را به زمانی موکول کنید که ابزار های پروفایلینگ (Profiling Tools) گلوگاه واقعی را در محیط تست فشار به شما نشان دهند.
نتیجه گیری و افق های نوین در تحلیل سیستم ها
تحلیل مجانبی و نماد Big-O، زبان مشترک تمامی مهندسان نرم افزار، معماران سیستم و دانشمندان داده در سراسر جهان است. این علم به ما امکان میدهد فراتر از محدودیت های سخت افزاری، سیستمعامل ها و زبان های برنامه نویسی موقت، قوانین حاکم بر رشد و رفتار نرم افزار را در مقیاس های بزرگ پیشبینی و مهار کنیم.
در دنیای امروز که داده ها با نرخ های چند ترابایتی جریان دارند و سیستم های هوش مصنوعی با میلیاردها پارامتر کار میکنند، درک ریاضی و سخت افزاری پیچیدگی زمان و حافظه دیگر تنها ابزاری برای گذراندن مصاحبه های فنی نیست؛ بلکه ستون اصلی ساخت سیستم های مقاوم، سریع، کمهزینه و مقیاس پذیر در برابر طوفان های ترافیکی دنیای واقعی است.
امتیاز و نظرات
هنوز نظری ثبت نشده است. اولین نفر باشید.