
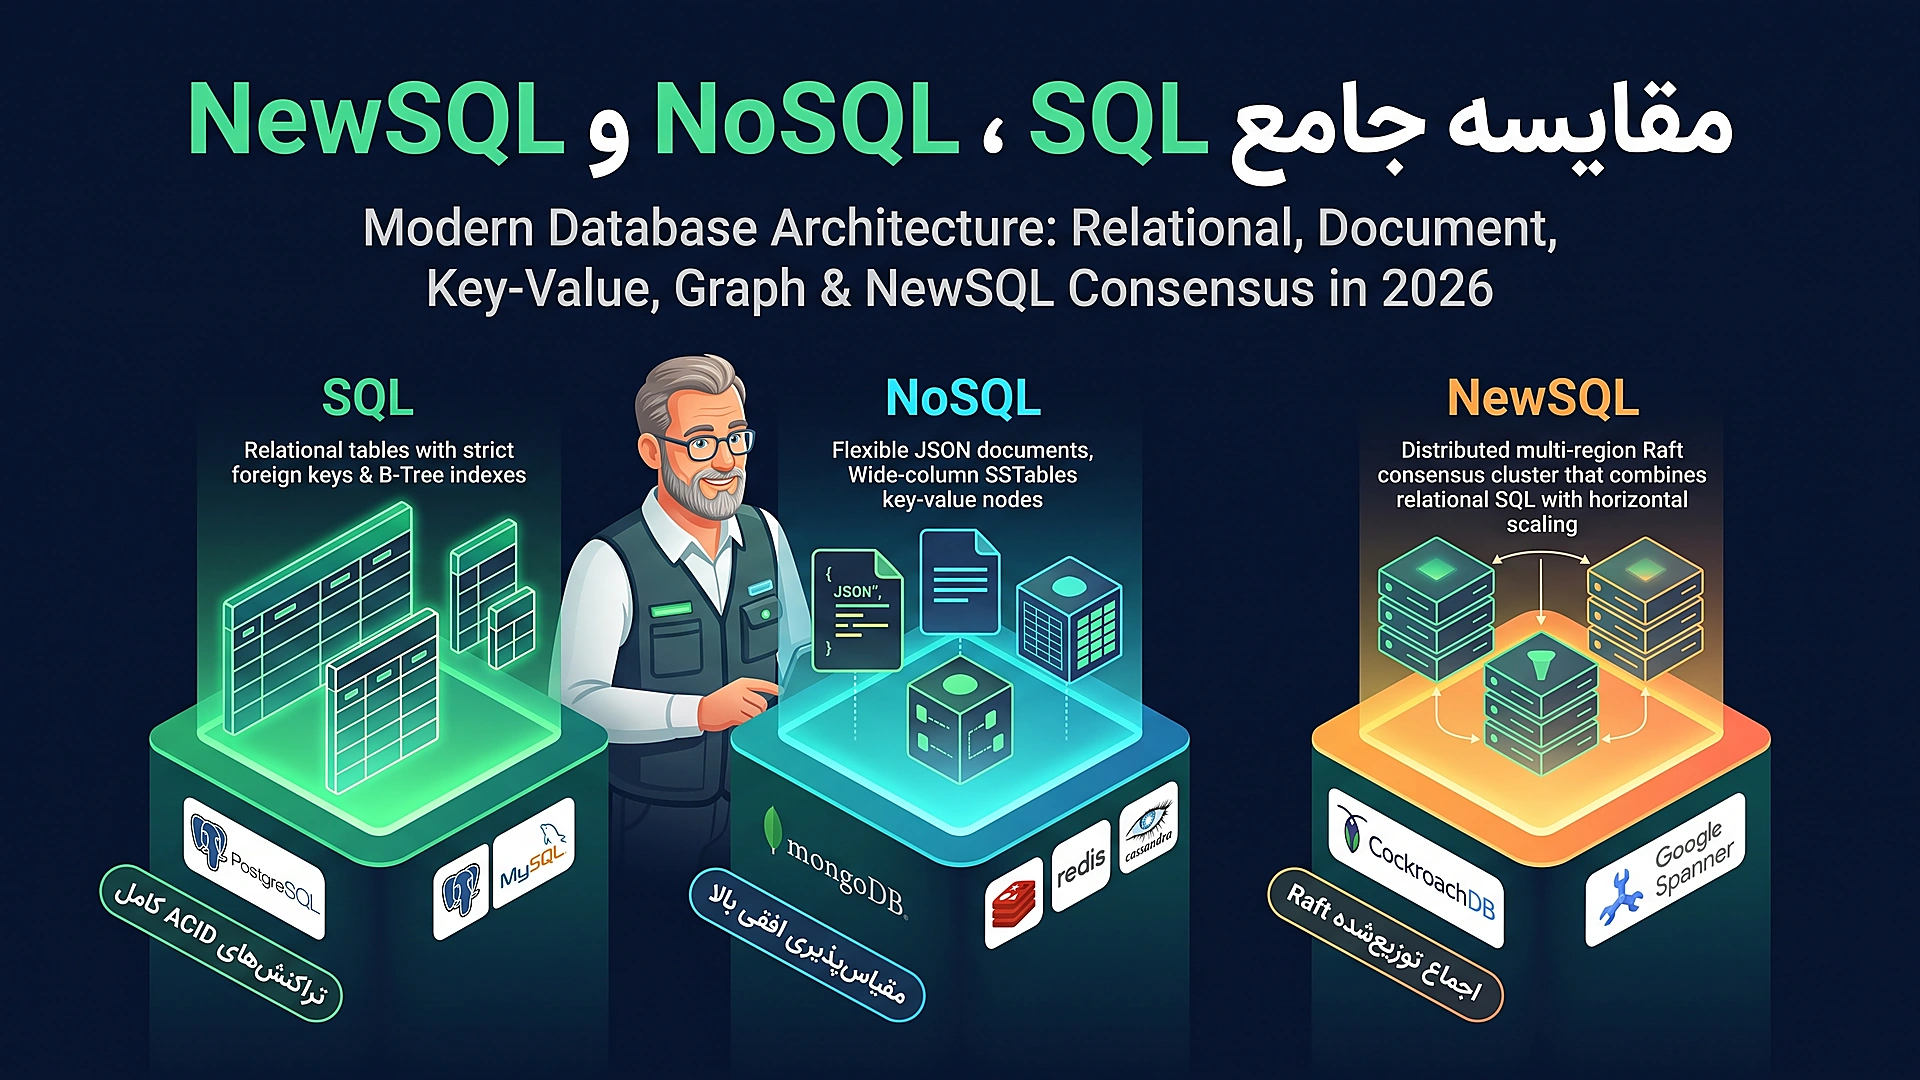
در جهان مهندسی نرمافزار معاصر، یکی از سرنوشتسازترین تصمیمات فنی در چرخه حیات هر محصول یا پلتفرم نرمافزاری، انتخاب پایگاه داده (Database Selection) است. این تصمیم نقشی بنیادین در تعیین سقف مقیاسپذیری (Scalability Ceiling)، پیچیدگی نگهداری، هزینههای زیرساختی و توانایی سیستم در ارائه پاسخهای کمتاخیر به میلیونها کاربر ایفا میکند. دوران حاکمیت تکقطبی پایگاه دادههای رابطهای (RDBMS) دهههاست که سپری شده و امروزه مهندسان سیستم با منظومهای متنوع از موتورهای رابطهای، غیررابطهای (NoSQL) و پایگاههای نوین توزیعشده (NewSQL) روبرو هستند.
همانطور که در راهنمای جامع طراحی سیستم (System Design) برای مقیاس میلیونی تشریح کردیم، طراحی یک سیستم توزیعشده تابآور مستلزم درک عمیق مصالحههای میان ذخیرهسازی، خواندن، نوشتن و مدلهای سازگاری داده است. یک انتخاب نادرست دیتابیس در مراحل اولیه توسعه، بدهی فنی سنگینی به بار میآورد که مهاجرت از آن در مراحل بعدی مقیاس، ماهها زمان و هزینههای هنگفت سازمانی خواهد طلبید.
۱. بحران ذخیرهسازی داده در عصر کلانداده و سیستم های توزیع شده
در دهههای ۱۹۸۰ و ۱۹۹۰ میلادی، معماری سیستمها غالباً متمرکز (Monolithic) بود. تمامی دادههای سازمان در قالب جداول مستطیلی با روابط کلید خارجی سختگیرانه (Foreign Keys) درون یک پایگاه داده رابطهای متمرکز مانند Oracle یا MySQL ذخیره میشدند. تضمینهای قاطع ACID خیال معماران را از بابت صحت اطلاعات راحت میکرد.
اما با ظهور عصر اینترنت، شبکههای اجتماعی، پلتفرمهای ابری و پردازش میلیاردها رویداد لحظهای در ثانیه، سیستمهای تکسروری به سقف فیزیکی توان پردازش (CPU) و پهنای باند دیسک برخورد کردند. نیاز به ذخیرهسازی حجمهای عظیم داده غیرساختاریافته (Unstructured Data)، توزیع جغرافیایی دادهها در چندین دیتاسنتر در سراسر جهان و نیاز به تاخیر پاسخگویی تکرقمی در مقیاس میلیثانیه، جرقهای برای بازنگری در اصول پنجاهساله پایگاه دادهها شد.
۲. کالبدشکافی لایه زیرین: موتورهای ذخیرهسازی B-Tree در برابر LSM-Tree
پیش از آنکه به تفاوتهای سطحی در نحوه کوئرینویسی یا اسکیما (Schema) بپردازیم، باید به عمیقترین لایه سختافزاری و نرمافزاری نگاه کنیم: موتور ذخیرهسازی (Storage Engine). هر پایگاه داده برای چیدمان بایتها روی حافظه رم و دیسک (SSD/NVMe) از یک ساختمان داده بنیادی استفاده میکند که به دو پارادایم اصلی تقسیم میشوند:
| معیار مقایسه | موتورهای مبتنی بر B-Tree / B+ Tree | موتورهای مبتنی بر LSM-Tree (Log-Structured Merge) |
|---|---|---|
| رویکرد بهروزرسانی داده | بهروزرسانی درجا (In-Place Update) با بازنویسی صفحات دیسک | فقط-افزودنی (Append-Only) با ساختار نامتغیر (Immutable) |
| عملکرد عملیات نوشتن (Write Throughput) | متوسط؛ به دلیل نیاز به جستجوی تصادفی محل صفحه در دیسک | بسیار بالا؛ تبدیل تمام نوشتنها به توالی ترتیبی روی حافظه و دیسک |
| عملکرد عملیات خواندن (Read Latency) | بسیار سریع و قابل پیشبینی با O(log N) به کمک پوینتر صفحات | متغیر؛ ممکن است نیاز به بررسی چندین SSTable و Bloom Filter باشد |
| فاکتور تقویت نوشتن (Write Amplification) | بالا (بازنویسی کل صفحه ۴ تا ۱۶ کیلوبایتی برای تغییر چند بایت) | متوسط تا بالا در جریان فرایند پسزمینه فشردهسازی (Compaction) |
| کاربرد و پیادهسازیهای شاخص | PostgreSQL, MySQL (InnoDB), SQLite, Oracle, SQL Server | Apache Cassandra, RocksDB, ScyllaDB, Google Bigtable, LevelDB |
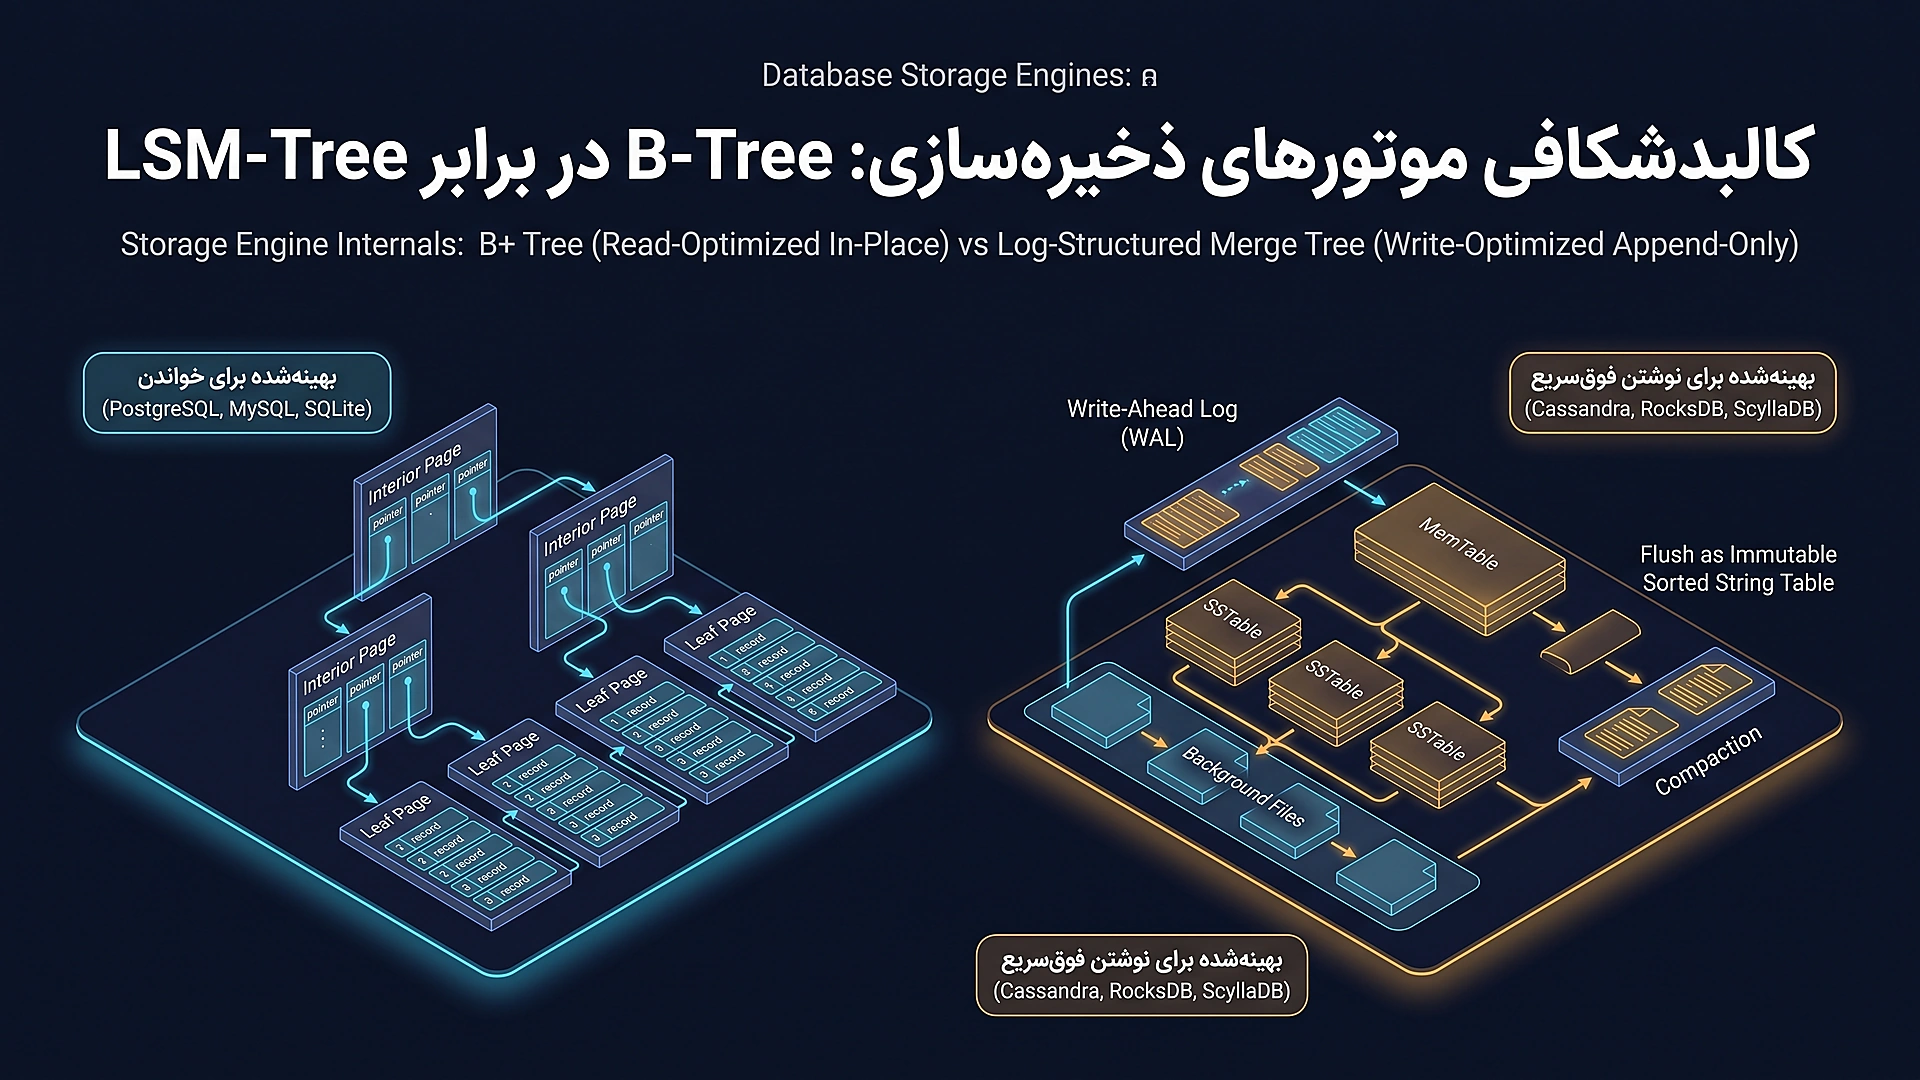
درختان B+ Tree: حاکمان خواندنهای تصادفی و دامنهای
در ساختار B+ Tree، دادهها در صفحاتی با اندازه مشخص (معمولاً ۸ یا ۱۶ کیلوبایت) سازماندهی میشوند. برگهای انتهایی درخت حاوی تمام رکوردها یا کلیدهای شاخص هستند و به صورت پیوندی دوطرفه به یکدیگر متصلاند که پیمایش دامنهای (Range Scans نظیر BETWEEN x AND y) را فوقالعاده سریع میسازد. با این حال، هنگام نوشتن داده جدید، سیستم باید ابتدا موقعیت دقیق را بیابد و صفحه را درجا بازنویسی کند؛ چنانچه صفحه پر شده باشد، رویداد پرهزینه Page Split رخ میدهد که سربار تصادفی دیسک را افزایش میدهد.
درختان LSM-Tree: سلاح مدرن برای نرخهای نوشتن جنونآمیز
در مقابل، LSM-Tree تمام عملیات نوشتن جدید را بلافاصله در دو نقطه ثبت میکند:
- لاگ پیشازنوشتن (Write-Ahead Log - WAL): نوشتن متوالی روی دیسک برای تضمین پایداری در صورت قطع برق.
- جدول حافظه (MemTable): یک ساختار درختی مرتب درون رم (نظیر Red-Black Tree یا SkipList).
هنگامی که حجم MemTable از آستانهای عبور کند، به عنوان یک فایل دیسکی غیرقابلتغییر و کامپکت به نام SSTable (Sorted String Table) روی دیسک تخلیه (Flush) میشود. جستجوها با استفاده از فیلترهای بلوم (Bloom Filters) به سرعت مشخص میکنند که آیا یک کلید درون یک فایل SSTable وجود دارد یا خیر. در پسزمینه، فرایندی به نام Compaction مداوماً فایلهای قدیمی را ادغام کرده و نسخههای منقضی یا حذفشده را پاکسازی میکند.
۳. پایگاه داده های رابطهای (SQL): نیم قرن پختگی، اقتدار و ثبات
پایگاههای داده رابطهای که بر پایه جبر رابطهای (Relational Algebra) ادگار کاد پایهگذاری شدهاند، پس از پنج دهه همچنان قلب تپنده اکثر تراکنشهای حساس تجاری جهان محسوب میشوند. اگر ساختار دادههای شما روشن، ارتباط میان موجودیتها متراکم و نیاز به صحت صددرصدی دادهها امری حیاتی است، هیچ راهحلی توان رقابت با پایگاههای رابطهای مدرن نظیر PostgreSQL را ندارد.
نقاط قوت برجسته پایگاه های داده SQL
- تضمینهای قطعی تراکنشهای ACID: اتمیک بودن، سازگاری پایدار، ایزولاسیون کامل و پایایی غیرقابلانکار.
- نرمالسازی دادهها (Data Normalization): پرهیز از افزونگی دادهها، جلوگیری از ناسازگاری اطلاعات و حفظ یکپارچگی ارجاعی (Referential Integrity).
- قدرت بیپایان در اتصالات چندجدولی (Complex JOINs): توانایی اجرای کوئریهای تحلیلی، گروهبندیهای پیچیده و فیلترهای چندلایه با بهینهسازهای بالغ (Cost-Based Query Optimizers).
- اکوسیستم عظیم و ابزارهای مانیتورینگ: درایورها، کتابخانههای نگاشت شیء-رابطه (ORM) و سیستمهای مدیریت تراکنش در تمام زبانهای برنامهنویسی.
محدودیتها و چالشهای ذاتی SQL در مقیاس بالا
چالش اصلی سیستمهای SQL سنتی، ماهیت طراحی اولیه آنها برای استقرار روی یک سرور منفرد است. هنگامی که پایگاه داده رابطهای نیازمند مقیاسپذیری فراتر از یک سرور شود:
- تکثیر خواندن (Read Replicas): اگرچه خواندنها به راحتی با افزودن رپلیکاها توزیع میشوند، اما تمام نوشتنها باید به نود Master فرستاده شوند که این نود دیر یا زود به یک گلوگاه سختافزاری بدل خواهد شد.
- تاخیر همگامسازی (Replication Lag): در رپلیکیشن ناهمگام، خواندن از رپلیکاها ممکن است دادههای قدیمی را نشان دهد که مفهوم خواندن پس از نوشتن (Read-Your-Own-Writes) را مختل میکند.
- سربار خردسازی داده (Sharding): قطعهقطعه کردن افقی یک پایگاه داده رابطهای نیازمند پیادهسازی منطق پیچیده در سطح اپلیکیشن است و اجرای کوئریهای حاوی JOIN میان شاردها عملاً عملکرد را فلج میکند.
۴. اکوسیستم پایگاه های داده NoSQL: کالبدشکافی چهار مدل داده اصلی
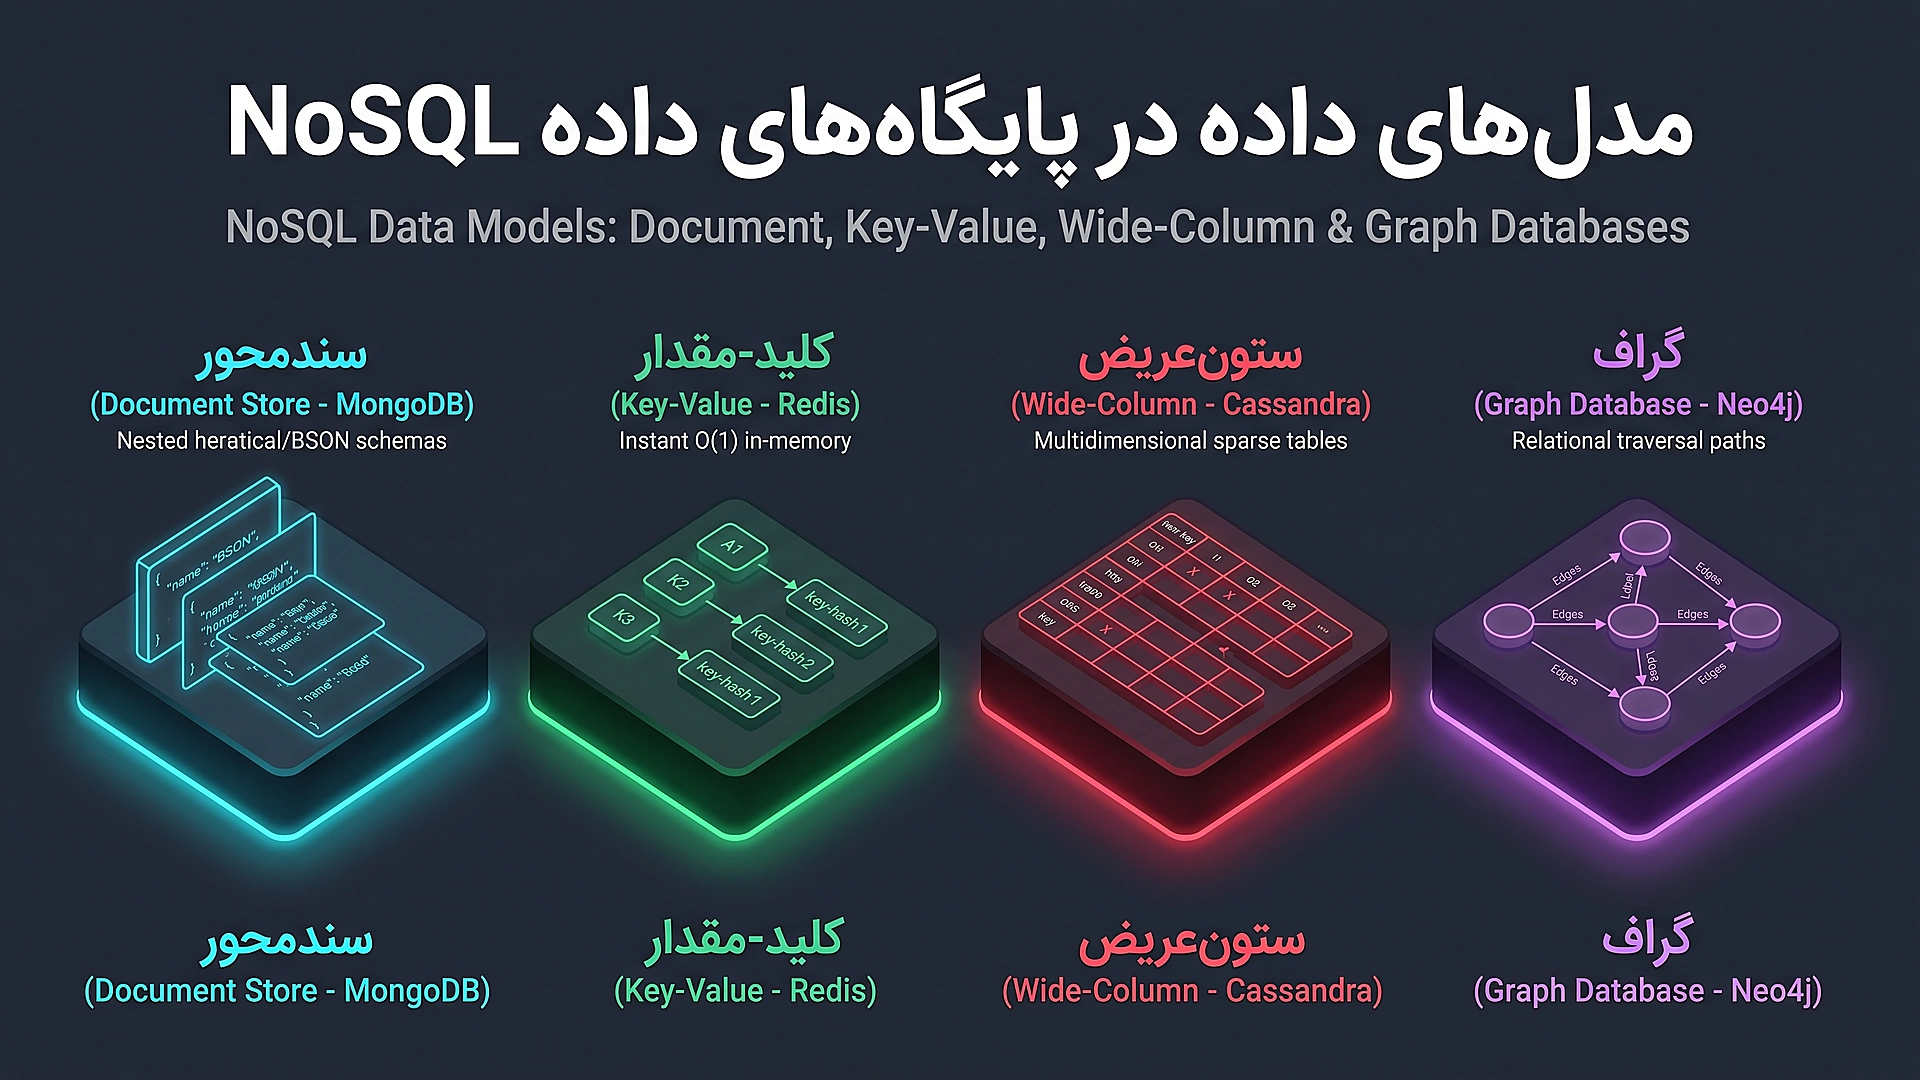
پایگاههای داده NoSQL نه برای نفی SQL، بلکه به عنوان پاسخی برای سناریوهایی متولد شدند که در آنها ساختار دادهها متغیر بود، یا نیاز به مقیاسپذیری افقی توزیعشده (Horizontal Scaling) اولویت مطلق داشت. این پایگاهها به چهار خانواده متمایز با کاربردهای کاملاً متفاوت بخشبندی میشوند:
۱. پایگاه های داده سندمحور (Document Stores)
دیتابیسهایی نظیر MongoDB و Couchbase دادهها را در قالب اسناد درختی با فرمت JSON یا BSON ذخیره میکنند. هر سند میتواند اسکیما و فیلدهای کاملاً متفاوتی نسبت به سند مجاور داشته باشد و ساختارهای تودرتو (Nested Arrays and Objects) را بدون نیاز به جدول واسط ذخیره کند.
// نمونه کوئری تجمیع (Aggregation Pipeline) در مونگو دیبی
db.orders.aggregate([
{ $match: { status: "COMPLETED", created_at: { $gte: ISODate("2026-01-01") } } },
{ $group: {
_id: "$customer_id",
total_spend: { $sum: "$total_amount" },
order_count: { $sum: 1 }
}
},
{ $sort: { total_spend: -1 } },
{ $limit: 10 }
]);
موارد کاربرد ایدهآل: سیستمهای مدیریت محتوا (CMS)، کاتالوگ محصولات با ویژگیهای پویای کالاها، پروفایل کاربران و پلتفرمهای تجارت الکترونیک با نیاز به توسعه چابک.
۲. پایگاه های داده کلید-مقدار (Key-Value Stores)
در این پارادایم که توسط Redis و Amazon DynamoDB نمایندگی میشود، پایگاه داده شبیه به یک هشمپ (Hash Table) غولپیکر با پیچیدگی زمانی \(O(۱)\) رفتار میکند. دادهها با یک کلید یکتا آدرسدهی میشوند و مقدار مرتبط میتواند از یک رشته متنی ساده تا ساختارهای پیچیده دادهای (Lists, Sets, Sorted Sets, Hashes) باشد.
موارد کاربرد ایدهآل: لایههای کش توزیعشده با تاخیر ساب-میلیثانیه، ذخیره نشستهای کاربری (Session Storage)، لیدربوردهای بلادرنگ و مدیریت سبد خرید موقت.
۳. پایگاه های داده ستونعریض (Wide-Column Stores)
معماری ستونعریض که مبتنی بر مقاله افسانهای Bigtable گوگل شکل گرفته و توسط Apache Cassandra و ScyllaDB به تکامل رسیده است، برای ذخیرهسازی پتابایتها داده با نرخ نوشتن نجومی در دهها کلاستر چندمنطقهای طراحی شده است. دادهها بر اساس یک کلید افراز (Partition Key) میان نودها توزیع میشوند و رکوردها شامل ستونهای پویا هستند.
-- نمونه تعریف جدول در آپاچی کاساندرا بر پایه الگوی دسترسی به داده
CREATE TABLE iot_sensor_telemetry (
    sensor_id uuid,
    bucket_date date,
    recorded_at timestamp,
    temperature double,
    humidity double,
    PRIMARY KEY ((sensor_id, bucket_date), recorded_at)
) WITH CLUSTERING ORDER BY (recorded_at DESC);
موارد کاربرد ایدهآل: دادههای سری زمانی (Time-Series)، تلمتری دستگاههای اینترنت اشیاء (IoT)، لاگهای سیستمی حجیم و رهگیری رویدادهای کلان در مقیاس جهانی.
۴. پایگاه های داده گراف (Graph Databases)
در شرایطی که ارتباطات و روابط میان موجودیتها از خود دادهها اهمیت بیشتری پیدا میکنند، سیستمهای سنتی برای پیمایش چند لایه نیاز به اتصالات خودارجاعی (Recursive Self-JOINs) سنگین و کشنده دارند. پایگاههای داده گراف نظیر Neo۴j از مفهوم شاخصگذاری بدون جدول (Index-Free Adjacency) استفاده میکنند؛ بدین معنا که هر گره پوینترهای مستقیمی به گرههای همسایه خود دارد و پیمایش میلیونها رابطه در میلیثانیه ممکن میشود.
موارد کاربرد ایدهآل: شبکههای اجتماعی (روابط دوستان و فالوورها)، موتورهای کشف کلاهبرداری بانکی (Fraud Detection)، گرافهای دانش (Knowledge Graphs) و موتورهای پیشنهاددهنده هوشمند.
۵. تقابل مدل های سازگاری: تضمینهای قاطع ACID در برابر آرامش تدریجی BASE
بزرگترین مرز مفهومی میان پایگاههای سنتی و مدرن، شیوه نگرش آنها به مقوله سازگاری دادهها در مقیاس سیستمهای توزیعشده است:
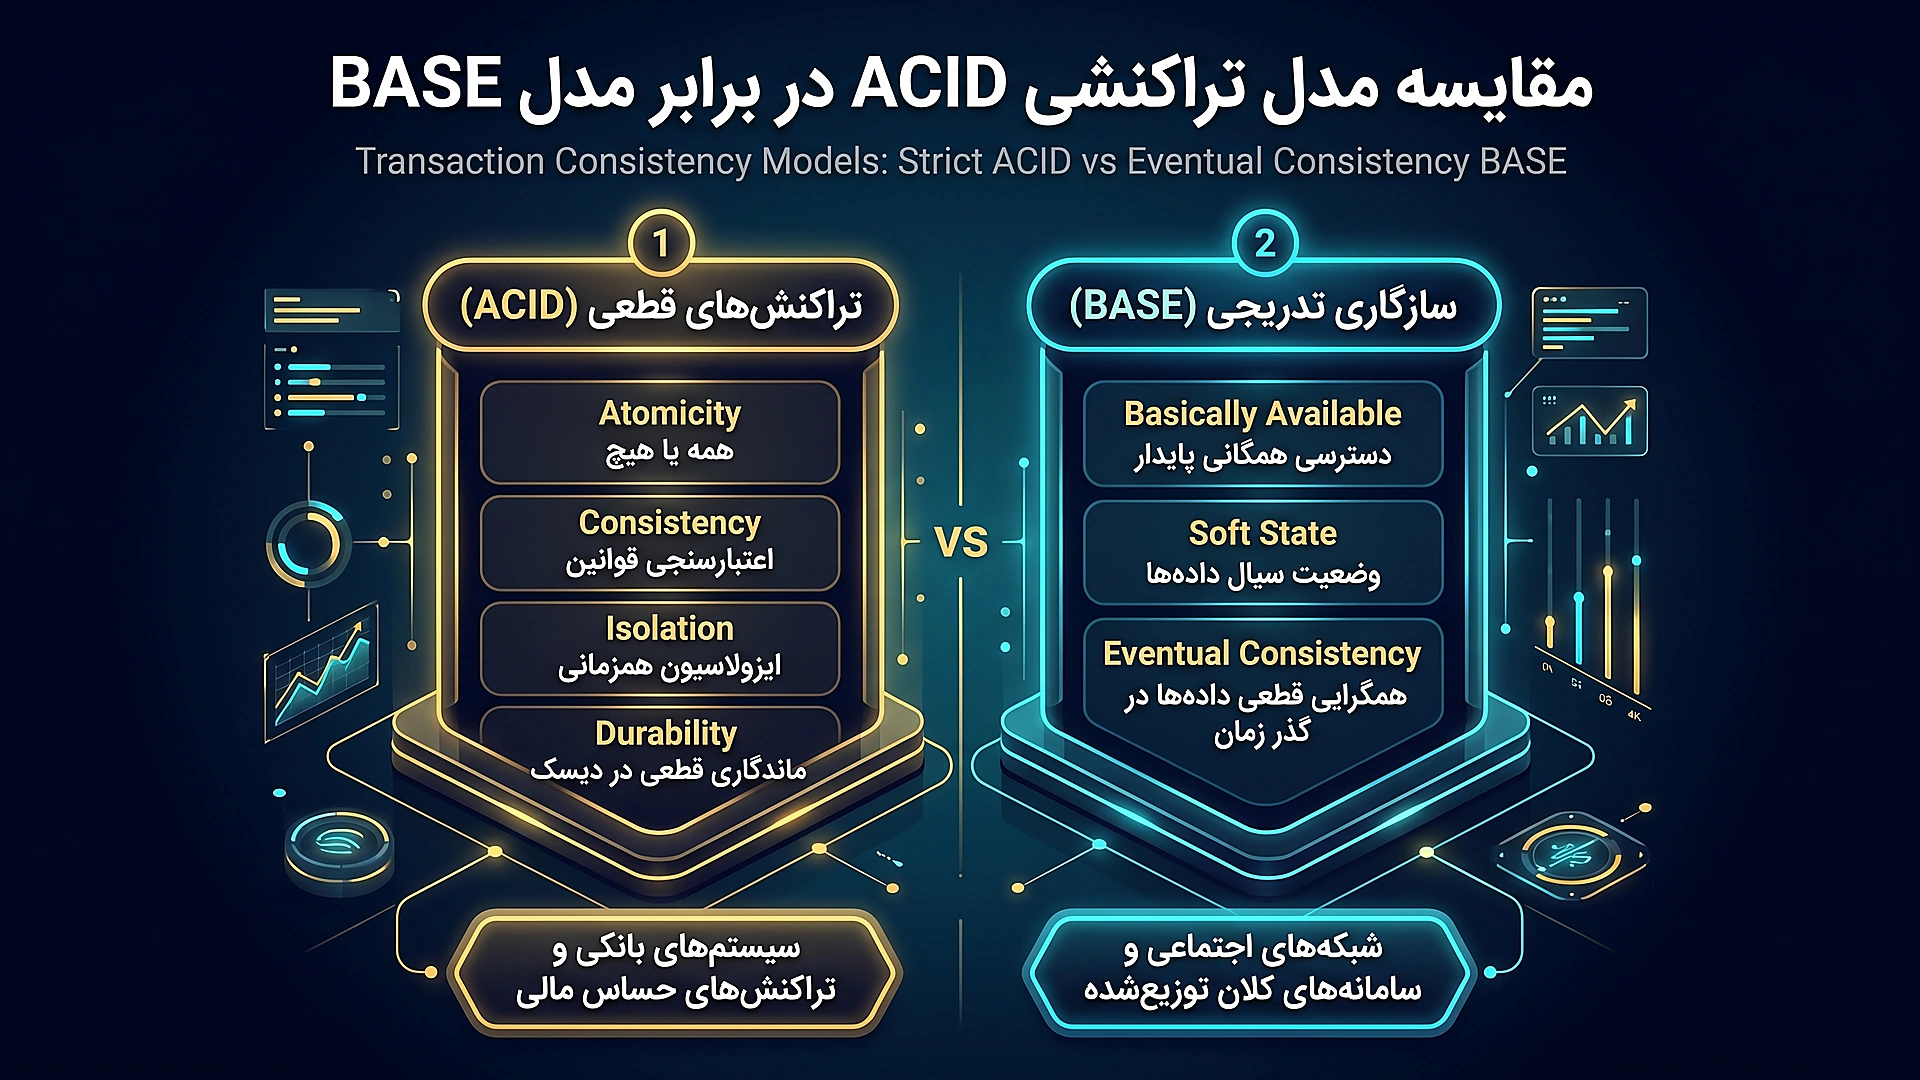
مدل سختگیرانه ACID
- Atomicity (اتمیک بودن): تمام دستورات درون یک تراکنش یا به طور کامل انجام میشوند یا در صورت بروز هرگونه خطا، هیچ تغییری پایدار نمیماند (All or Nothing).
- Consistency (سازگاری اعتباری): پایگاه داده پیش و پس از اجرای تراکنش باید در وضعیت معتبر و منطبق بر تمام قوانین تعریفشده (Foreign Keys, Constraints) باقی بماند.
- Isolation (ایزولاسیون همزمانی): تراکنشهای موازی نباید در کار یکدیگر تداخل ایجاد کنند. سطوح ایزولاسیون استاندارد از Read Uncommitted آغاز شده و تا سختگیرانهترین سطح یعنی Serializable ادامه مییابد.
- Durability (ماندگاری دیسکی): به محض تایید تراکنش، دادهها حتی در صورت قطعی ناگهانی برق سرور روی حافظه پایدار ماندگار هستند.
مدل انعطافپذیر BASE در سیستم های مقیاسبالا
همانگونه که در کتاب مرجع اصول طراحی سیستم های توزیع شده (DDIA) به تفصیل بررسی شده، در سیستمهای بسیار بزرگ پافشاری بر ایزولاسیون کامل هزینه عملکردی غیرقابلقبولی به همراه دارد. مدل BASE بر سه اصل استوار است:
- Basically Available: سیستم همواره تضمین میکند که به درخواستها پاسخ دهد، حتی اگر بخشی از نودها دچار نقص فنی باشند.
- Soft State: وضعیت دادهها ممکن است بدون مداخله کاربر و به دلیل نوسانات همگامسازی شبکه سیال باشد.
- Eventual Consistency (سازگاری نهایی): سیستم تضمین میکند که چنانچه ورودی جدیدی به سیستم ارسال نشود، به مرور زمان تمام نودهای توزیعشده با یکدیگر همگام شده و به یک وضعیت پایدار و یکسان خواهند رسید.
۶. طلوع پایگاه های داده NewSQL: ادغام دنیای رابطهای با مقیاس توزیع شده
سالها این باور در میان مهندسان رواج داشت که اگر خواهان مقیاسپذیری افقی هستید، چارهای جز تسلیم شدن در برابر NoSQL و پذیرش سازگاری نهایی ندارید؛ و اگر تراکنشهای ACID و کوئریهای قدرتمند SQL میخواهید، باید خود را به محدودیتهای سرورهای سنتی محدود کنید.
پایگاههای داده NewSQL برای درهم شکستن این دوگانه متولد شدند. شاهکارهایی نظیر Google Cloud Spanner، CockroachDB و YugabyteDB با بهرهگیری از پروتکلهای اجماع توزیعشده مدرن، هر دو مزیت را همزمان به ارمغان آوردهاند.
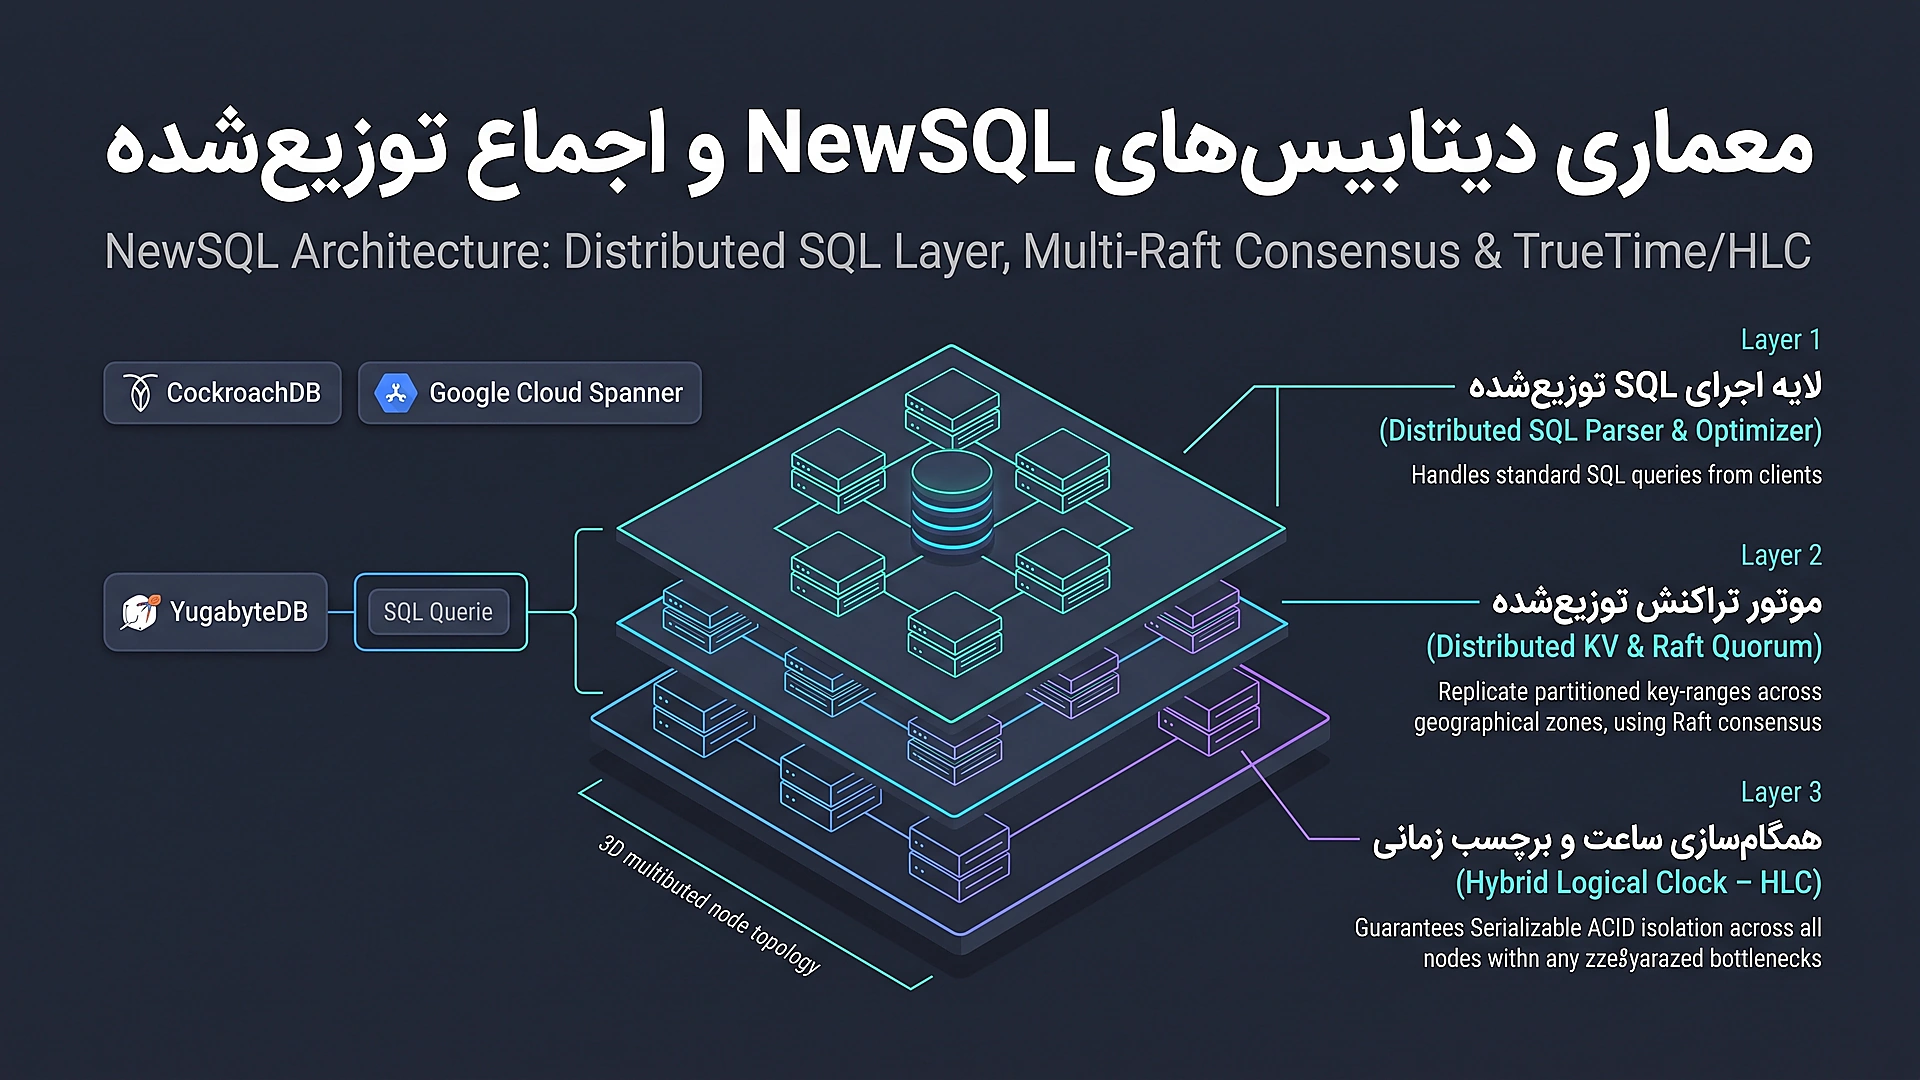
ارکان سهگانه معماری NewSQL
- تفکیک لایه محاسبات (Compute) از ذخیرهسازی (Storage): لایه بالایی یک تحلیلگر و بهینهساز SQL توزیعشده است که پروتکلهای استاندارد PostgreSQL را درک میکند. لایه پایینی یک موتور کلید-مقدار توزیعشده بر پایه LSM-Tree یا RocksDB است.
- اجماع بر مبنای پروتکل Raft (Multi-Raft Consensus): دادهها به رنجهای مشخصی افراز میشوند. هر رنج درون یک گروه مستقل از گرهها به روش پروتکل Raft تکثیر میشود. تا زمانی که اکثریت اعضای گروه (Quorum) آنلاین باشند، نوشتنها با تضمین قطعی ثبات انجام میشوند.
- مدیریت پیشرفته زمان و ساعتها (TrueTime و HLC): چالش بزرگ تراکنشهای توزیعشده، عدم قطعیت در ساعتهای فیزیکی سرورهاست. گوگل اسپانر با استفاده از ساعتهای اتمی و GPS در مراکز داده خود (فناوری TrueTime) و کوکراچدیبی با استفاده از ساعتهای منطقی هیبریدی (Hybrid Logical Clocks - HLC) ترتیبی دقیق و جهانی برای تراکنشهای ایزوله در سطح Serializable فراهم میآورند.
۷. ماتریس مقایسه جامع فناوریهای ذخیرهسازی داده در سال ۲۰۲۶
برای داشتن نگاهی یکپارچه و مقایسهای، جدول زیر ابعاد بنیادین هر یک از پارادایمهای اصلی را در کنار شاخصترین ابزارهای صنعت مقایسه میکند:
| دسته پایگاه داده | سیستمهای شاخص | مدل تراکنشی | مقیاسپذیری نوشتن | مقیاسپذیری خواندن | مهمترین مزیت | بزرگترین گلوگاه |
|---|---|---|---|---|---|---|
| رابطهای (RDBMS / SQL) | PostgreSQL, MySQL | ACID سرسختانه (Strict) | محدود به تکسرور عمودی | بالا با رپلیکاها | پختگی، اتصالات عمیق، یکپارچگی ارجاعی | محدودیت مقیاس نوشتن، هزینه بالای شاردینگ دستی |
| سندمحور (Document) | MongoDB, Couchbase | ACID تکسند / چندسند | خوب با شاردینگ خودکار | بسیار بالا با توزیع نودها | انعطاف در اسکیما، سازگاری ایدهآل با JSON | مصرف حافظه بالا، عدم کارایی در روابط عمیق |
| کلید-مقدار (Key-Value) | Redis, DynamoDB | ساده / تککلید | فوقالعاده بالا | کمنظیر (تاخیر کمتر از میلیثانیه) | سادهترین مدل داده، عملکرد درون حافظهای خیرهکننده | عدم امکان کوئریزدن روی فیلدهای داخلی مقدار |
| ستونعریض (Wide-Column) | Cassandra, ScyllaDB | سازگاری قابل تنظیم (Tunable BASE) | نجومی و بدون نقطه شکست منفرد | بالا بر اساس کلید افراز | پایداری بینظیر، تحمل خرابی مراکز داده کامل | دشواری در کوئرینویسی، عدم پشتیبانی از اتصالات |
| گراف (Graph) | Neo۴j, AWS Neptune | ACID در تراکنشهای گراف | متوسط | خوب در پیمایشهای عمقی | پیمایش روابط بسیار پیچیده چند لایه | سختی شاردینگ افقی گراف در کلاسترهای بزرگ |
| توزیعشده نوین (NewSQL) | CockroachDB, Spanner | توزیعشده کامل ACID | افقی و نامحدود | افقی و نامحدود | ترکیب قابلیت اطمینان SQL با توان مقیاس NoSQL | تاخیر بالاتر در نوشتن به دلیل اجماع Raft و هزینه زیرساخت |
۸. چارچوب تصمیمگیری استراتژیک: کدام پایگاه داده برای کسبوکار شما مناسب است؟
برای انتخاب صحیح، نباید از ابزار به سمت نیازمندی حرکت کنید؛ بلکه باید مشخصات حجم کاری (Workload Characteristics) خود را در قالب یک فلوچارت مهندسی ارزیابی نمایید:
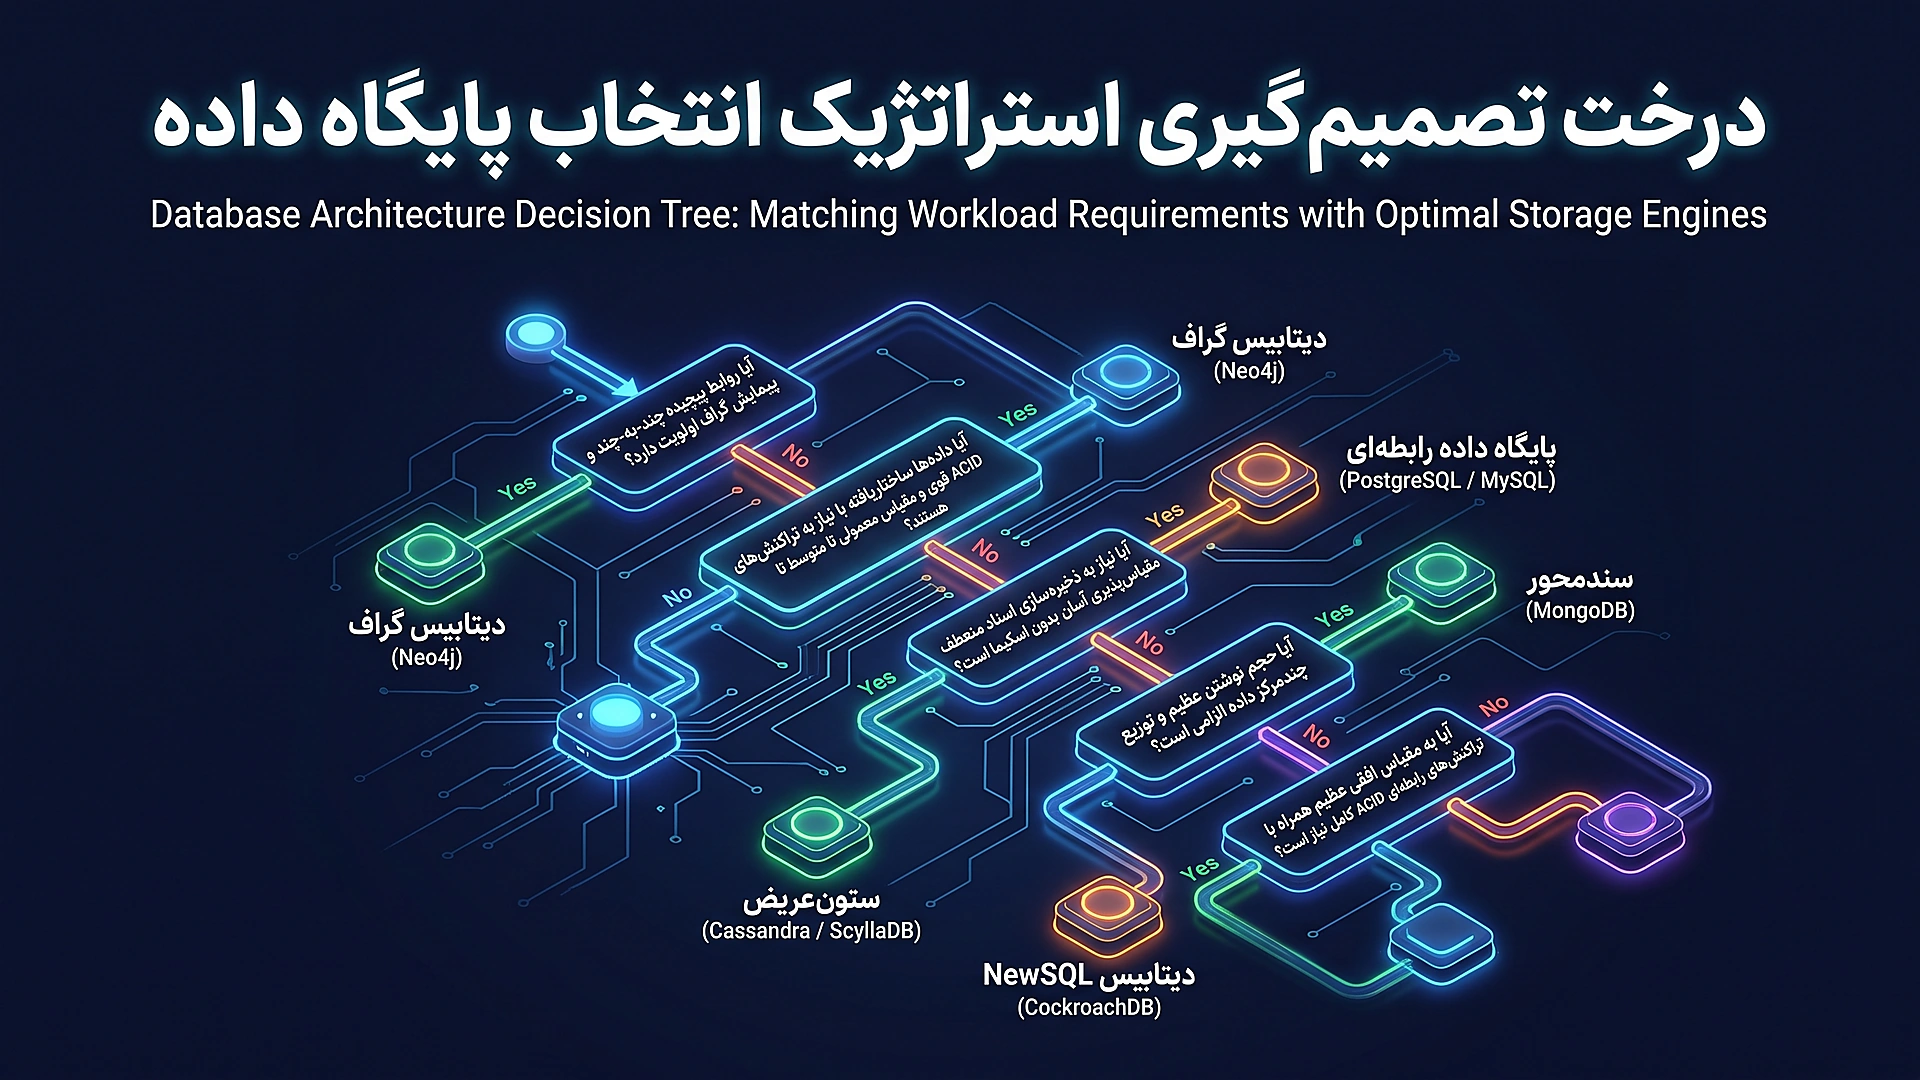
قوانین پنجگانه برای اتخاذ تصمیم نهایی
- قانون پیشفرض: همواره با PostgreSQL شروع کنید مگر آنکه دلیلی نقضکننده داشته باشید. برای بیش از ۹۰ درصد پروژههای استارتاپی و سازمانی، توان پایداری، پشتیبانی بینظیر از JSONB، اکوسیستم غنی و پلاگینهای مدرن (نظیر TimescaleDB برای دادههای سری زمانی و pgvector برای هوش مصنوعی) در پستگرس تمام نیازها را تا ترافیکهای بسیار سنگین پوشش میدهد.
- اگر نیازمند پردازش تراکنشهای مالی چندمرکزی در مقیاس بینالمللی هستید: به NewSQL روی آورید. هنگامی که کلاستر شما در چند قاره توزیع شده و قوانین بانکی اجازه حتی یک مورد عدم تطابق داده را نمیدهد، CockroachDB یا Google Spanner گزینههای بیرقیب هستند.
- اگر جریان نوشتن مداوم دادههای تلمتری و سنسورها فراتر از توان دیسک معمولی است: Apache Cassandra یا ScyllaDB را انتخاب کنید. ساختار بدون مستر (Masterless) و موتور LSM-Tree در این پایگاهها اجازه میدهد میلیونها لاگ و رویداد در ثانیه با ضریب اطمینان بالا ثبت شوند.
- اگر روابط میان موجودیتها ساختاری شبکهای و زنجیرهای دارد: پایگاه داده گراف تنها نجاتبخش شماست. هرگز سعی نکنید سیستمهای تشخیص تقلب یا شبکههای دوستی پیچیده را با اتصالات تو در توی پنججدولی در دیتابیس رابطهای حل کنید؛ Neo۴j برای این کار زاده شده است.
- معماری چندپایگاهی (Polyglot Persistence) را با هوشمندی به کار ببرید. در معماریهای میکروسرویس مدرن، لزومی ندارد تمام سازمان به یک پایگاه واحد متصل باشند. همانگونه که در راهنمای معماری رویداد محور با آپاچی کافکا توضیح دادیم، میتوان دادههای تراکنشی را در PostgreSQL ثبت کرد، رویدادها را با CDC به کافکا منتقل ساخت، موجودی و کش را در Redis نگه داشت و اسناد را برای جستجوی متنی به Elasticsearch سپرد.
نتیجهگیری و جمعبندی
انتخاب پایگاه داده یک مسابقه زیبایی در میان ابزارهای ترند روز نیست؛ بلکه یک هنر مهندسی در موازنهسازی دقیق میان مدل داده، تضمینهای تراکنشی، متریکهای کارایی و هزینههای عملیاتی است. هیچ راهحل جادویی یا یکتایی برای تمام مسائل وجود ندارد. معماران موفق کسانی هستند که نقاط قوت ذاتی موتورهای B-Tree و LSM-Tree را میشناسند، تفاوتهای فلسفی میان ACID و BASE را درک کردهاند و ابزار مناسب را برای حل گرههای کاری مشخص به خدمت میگیرند.
امتیاز و نظرات
هنوز نظری ثبت نشده است. اولین نفر باشید.