
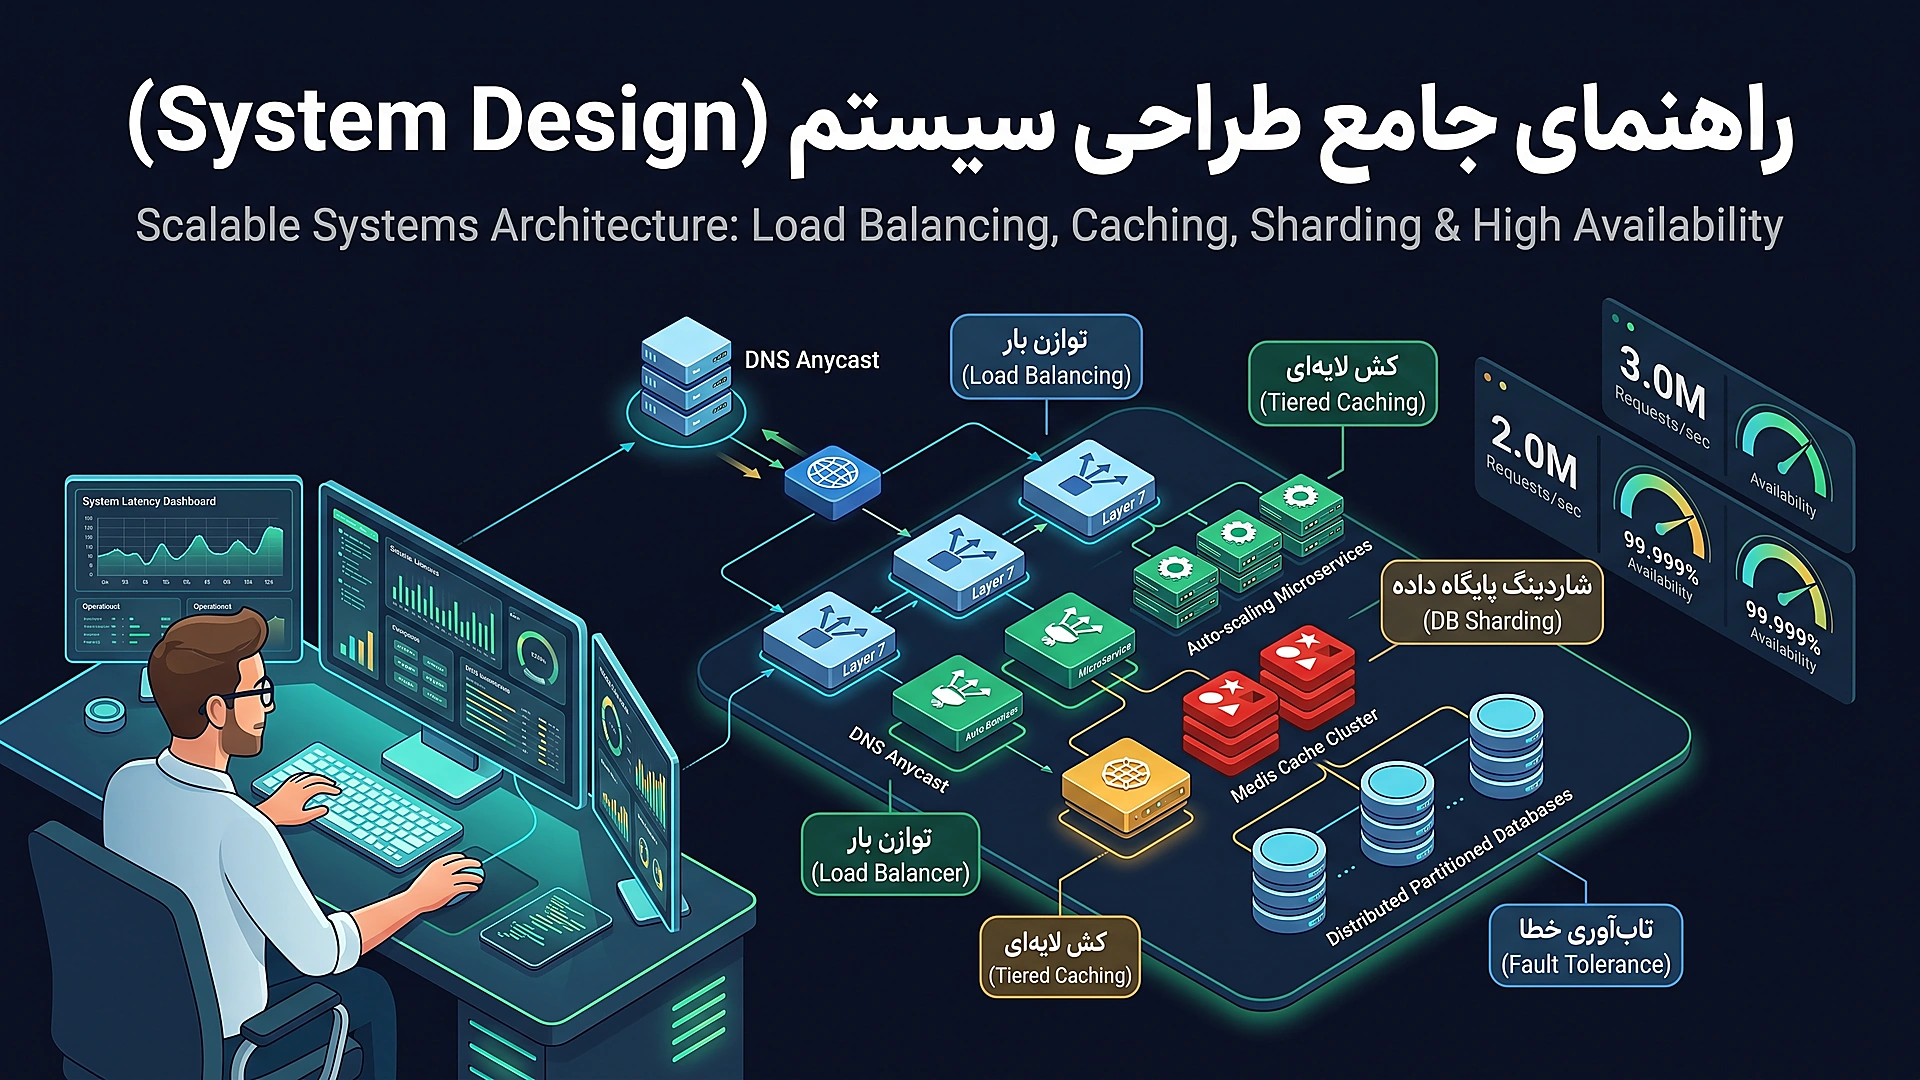
در چشمانداز مهندسی نرم افزار نوین، مرز میان یک برنامه نویس عادی و یک معمار سیستم ارشد (Senior/Staff Software Engineer) با میزان تسلط بر طراحی سیستم (System Design) سنجیده میشود. هنگامی که یک محصول نرم افزاری از چند هزار کاربر همزمان به مقیاس میلیون ها درخواست در ثانیه (RPS) میرسد، دیگر بهینه سازی الگوریتم های منفرد یا کد نویسی تمیز به تنهایی کارساز نیست؛ بلکه نحوه توزیع بار، توپولوژی پایگاه های داده، استراتژی های کشگذاری، تابآوری شبکه و ایزولاسیون خطاهاست که حیات سرویس را تضمین میکند.
همانطور که در راهنمای اصول طراحی معماری تمیز (Clean Architecture) تبیین کردیم، لایه بندی شفاف کدها در مقیاس یک تکسرویس الزامی است؛ اما در ابعاد سیستم های توزیع شده، قوانین حاکم بر شبکه، تاخیر، همگام سازی و دسترسی پذیری نیازمند دانشی فراتر از مرزهای زبان های برنامه نویسی است.
۱. چارچوب گام به گام برای تحلیل و پیاده سازی مسائل طراحی سیستم (The ۴-Step Framework)
یکی از بزرگترین اشتباهات مهندسان در مصاحبه های فنی شرکت های برتر فناوری یا پروژه هایی بزرگ صنعتی، پریدن مستقیم به سراغ راهحل ها و انتخاب ابزار ها (مانند استفاده شتابزده از کافکا یا ردیس) بدون شفاف سازی نیازمندی ها است. رویکرد مهندسی استاندارد مستلزم طی کردن ۴ مرحله نظام مند است:
گام نخست: شفاف سازی نیازمندی های تابعی و غیرتابعی (Requirements Clarification)
- نیازمندی های تابعی (Functional Requirements): سیستم چه کارهایی را دقیقاً باید انجام دهد؟ (به عنوان مثال: ارسال پیام، تولید شناسه کوتاه برای آدرس URL، جستجوی نزدیکترین راننده، مشاهده فید اخبار).
- نیازمندی های غیرتابعی (Non-Functional Requirements): متریک های کیفیت سامانه شامل تاخیر (Latency)، توان پردازشی (Throughput)، دسترس پذیری (Availability)، سازگاری (Consistency)، امنیت و انطباق با رگولاتوری چگونه تعریف میشوند؟
گام دوم: تخمین ظرفیت و ارزیابی ترافیک (Capacity Estimation & Back-of-the-Envelope Calculations)
پیش از رسم هرگونه دیاگرام، باید ارقام کلیدی سیستم با تقریب سرانگشتی محاسبه شوند:
- تعداد کاربران فعال روزانه (DAU): فرضاً ۱۰ میلیون کاربر فعال روزانه.
- محاسبه توان در ثانیه (RPS): میانگین و حداکثر بار ترافیکی (Peak Traffic). اگر هر کاربر روزانه ۱۰ درخواست ارسال کند، مجموع درخواست های روزانه ۱۰۰ میلیون بوده که به میانگین ۱۱۵۰ درخواست بر ثانیه و پیک ۵۰۰۰ تا ۱۰۰۰۰ در ثانیه میرسد.
- تخمین پهنای باند شبکه ورودی و خروجی (Ingress/Egress Bandwidth): حجم هر پیام ۵۰۰ بایت در ۱۰,۰۰۰ درخواست برابر با ۵ مگابایت در ثانیه ورودی.
- فضای ذخیره سازی داده ها (Storage for ۵ Years): ۱۰۰ میلیون پیام در روز × ۵۰۰ بایت = ۵۰ گیگابایت در روز، معادل ۱۸ ترابایت در سال و ۹۰ ترابایت در ۵ سال.
- تخمین حافظه رم برای لایه کش (Cache RAM): بر اساس قاعده سرانگشتی ۸۰/۲۰ پارتو، کشگذاری ۲۰٪ از ترافیک روزانه خواندن، پاسخگوی ۸۰٪ کوئری ها خواهد بود (۲۰٪ از ۵۰ گیگابایت = ۱۰ گیگابایت رم).
گام سوم: طراحی معماری سطح بالا (High-Level Architecture)
ترسیم کامپوننت های کلیدی شامل کلاینت، لودبالانسر، دروازه API (API Gateway)، سرویس هایی اپلیکیشن، لایه کش و پایگاه داده.
گام چهارم: ورود عمیق به گلوگاه ها و چالش های مقیاس (Deep Dive & Bottleneck Resolution)
بررسی نقاط شکست منفرد (Single Points of Failure)، همگام سازی تکرار داده ها، همزمانی و Race Conditions، پایش سلامت سیستم و استراتژی های بازیابی بحران (Disaster Recovery).
۲. مقیاس پذیری عمودی در برابر افقی (Vertical vs Horizontal Scalability)
در مقیاس پذیری عمودی (Scaling Up)، منابع سخت افزاری سرور (CPU و RAM) ارتقا مییابند. اگرچه این روش هیچ پیچیدگی نرم افزاری ایجاد نمیکند، اما دارای سقف سخت افزاری فیزیکی و هزینه تصاعدی است و ریسک خاموشی ناشی از خرابی سرور واحد (SPOF) را در بر دارد.
در نقطه مقابل، مقیاس پذیری افقی (Scaling Out) بنیاد سیستم های ابری و توزیع شده است که با افزودن گره های سروری ارزانقیمت به کلاستر محقق میشود. این رویکرد نیازمند پیاده سازی مکانیزم های توازن بار بدون حالت (Stateless Applications) و استفاده از ابزار های ارکستریشن مدرن نظیر کوبرنتیز است.
برای مطالعه عمیق نحوه ارکستریشن و مدیریت این گره های مقیاس پذیر در محیط های ابری، به مقاله مرجع راهنمای جامع کوبرنتیز و معماری کلاستر مراجعه فرمایید.
۳. لودبالانسینگ پیشرفته: کالبدشکافی لایه ۴ در برابر لایه ۷
لودبالانسرها دروازه ورود تمام ترافیک خارجی به کلاستر های محاسباتی هستند. برای انتخاب و پیکربندی صحیح، باید تفاوت بنیادین میان لودبالانسرهای لایه انتقال (Layer ۴) و لایه کاربرد (Layer ۷) مدل OSI را درک کرد:
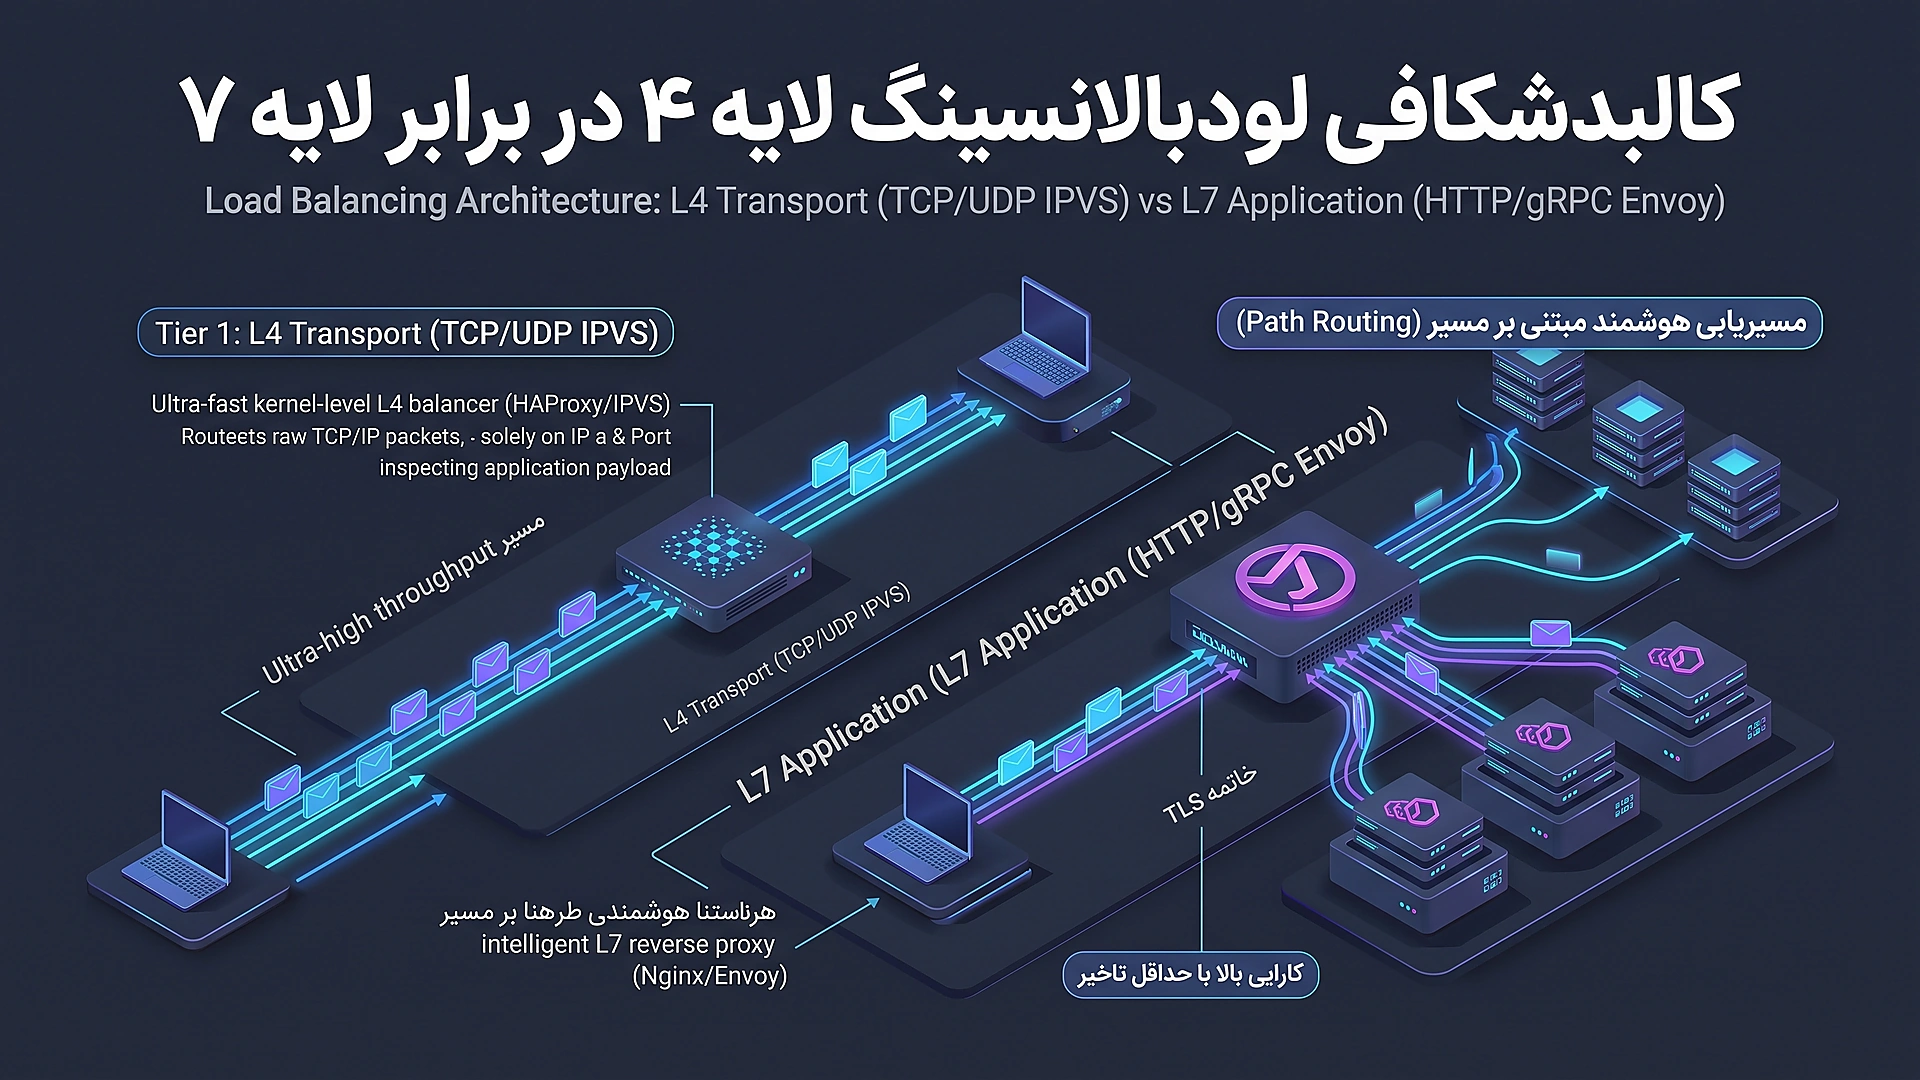
لودبالانسر لایه ۴ (L۴ - Transport Layer)
ابزار هایی نظیر IPVS (IP Virtual Server) در هسته لینوکس و HAProxy در مود TCP، بسته های شبکه را بدون باز کردن محتوای اپلیکیشن و صرفاً بر اساس آدرس IP مبدا/مقصد و پورت TCP/UDP مسیریابی میکنند. ویژگی های بارز L۴ عبارتند از:
- سرعت نجومی و مصرف ناچیز رم و پردازنده به دلیل عدم نیاز به کدگذاری یا ارزیابی رشته های متنی.
- ترافیک در سطح نشست TCP مدیریت میشود و اطلاعی از هدرهای HTTP یا کوکی ها ندارد.
- عدم توانایی در شکستن بار بر اساس مسیر آدرس (Path-based Routing).
لودبالانسر لایه ۷ (L۷ - Application Layer)
پروکسی های معکوس هوشمند نظیر Envoy Proxy و Nginx بسته های شبکه را در لایه اپلیکیشن پردازش میکنند. این ابزار ها امکانات حیاتی زیر را مهیا میسازند:
- خاتمه TLS/SSL (SSL Termination): بار محاسباتی رمزنگاری و اعتبارسنجی گواهینامه ها در لبه برداشته شده و ترافیک داخلی به صورت سبکتر جریان مییابد.
- مسیریابی بر اساس محتوا (Content-based Routing): هدایت درخواست های
/api/v1/ordersبه سرویس سفارشات و/api/v1/usersبه سرویس کاربران. - تزریق هدر و مانیتورینگ توزیع شده: درج شناسه های یکتا برای ردیابی توزیع شده (Trace ID) در سراسر سیستم های میکرو سرویسی.
الگوریتم های توزیع ترافیک (Traffic Distribution Algorithms)
# نمونه پیاده سازی الگوریتم Round Robin وزندار در زبان پایتون
class WeightedRoundRobin:
def __init__(self, servers):
# servers = [{'name': 'srv-1', 'weight': 5}, {'name': 'srv-2', 'weight': 2}]
self.servers = servers
self.current_index = -1
self.current_weight = 0
self.max_weight = max(s['weight'] for s in servers)
self.gcd_weight = self._gcd_weights([s['weight'] for s in servers])
def _gcd(self, a, b):
while b:
a, b = b, a % b
return a
def _gcd_weights(self, weights):
from functools import reduce
return reduce(self._gcd, weights)
def get_server(self):
while True:
self.current_index = (self.current_index + 1) % len(self.servers)
if self.current_index == 0:
self.current_weight -= self.gcd_weight
if self.current_weight = self.current_weight:
return self.servers[self.current_index]['name']
۴. الگو های کش گذاری توزیع شده (Distributed Caching Strategies)
دسترسی به حافظه موقت رم (RAM) در پایگاه های دادهای نظیر Redis تا ۱۰۰۰ برابر سریعتر از دیسک های SSD و پایگاه های داده سنتی است. با این حال، به کارگیری ناصحیح لایه کش منجر به تضاد داده ها (Data Inconsistency) و هدررفت شدید منابع میشود.
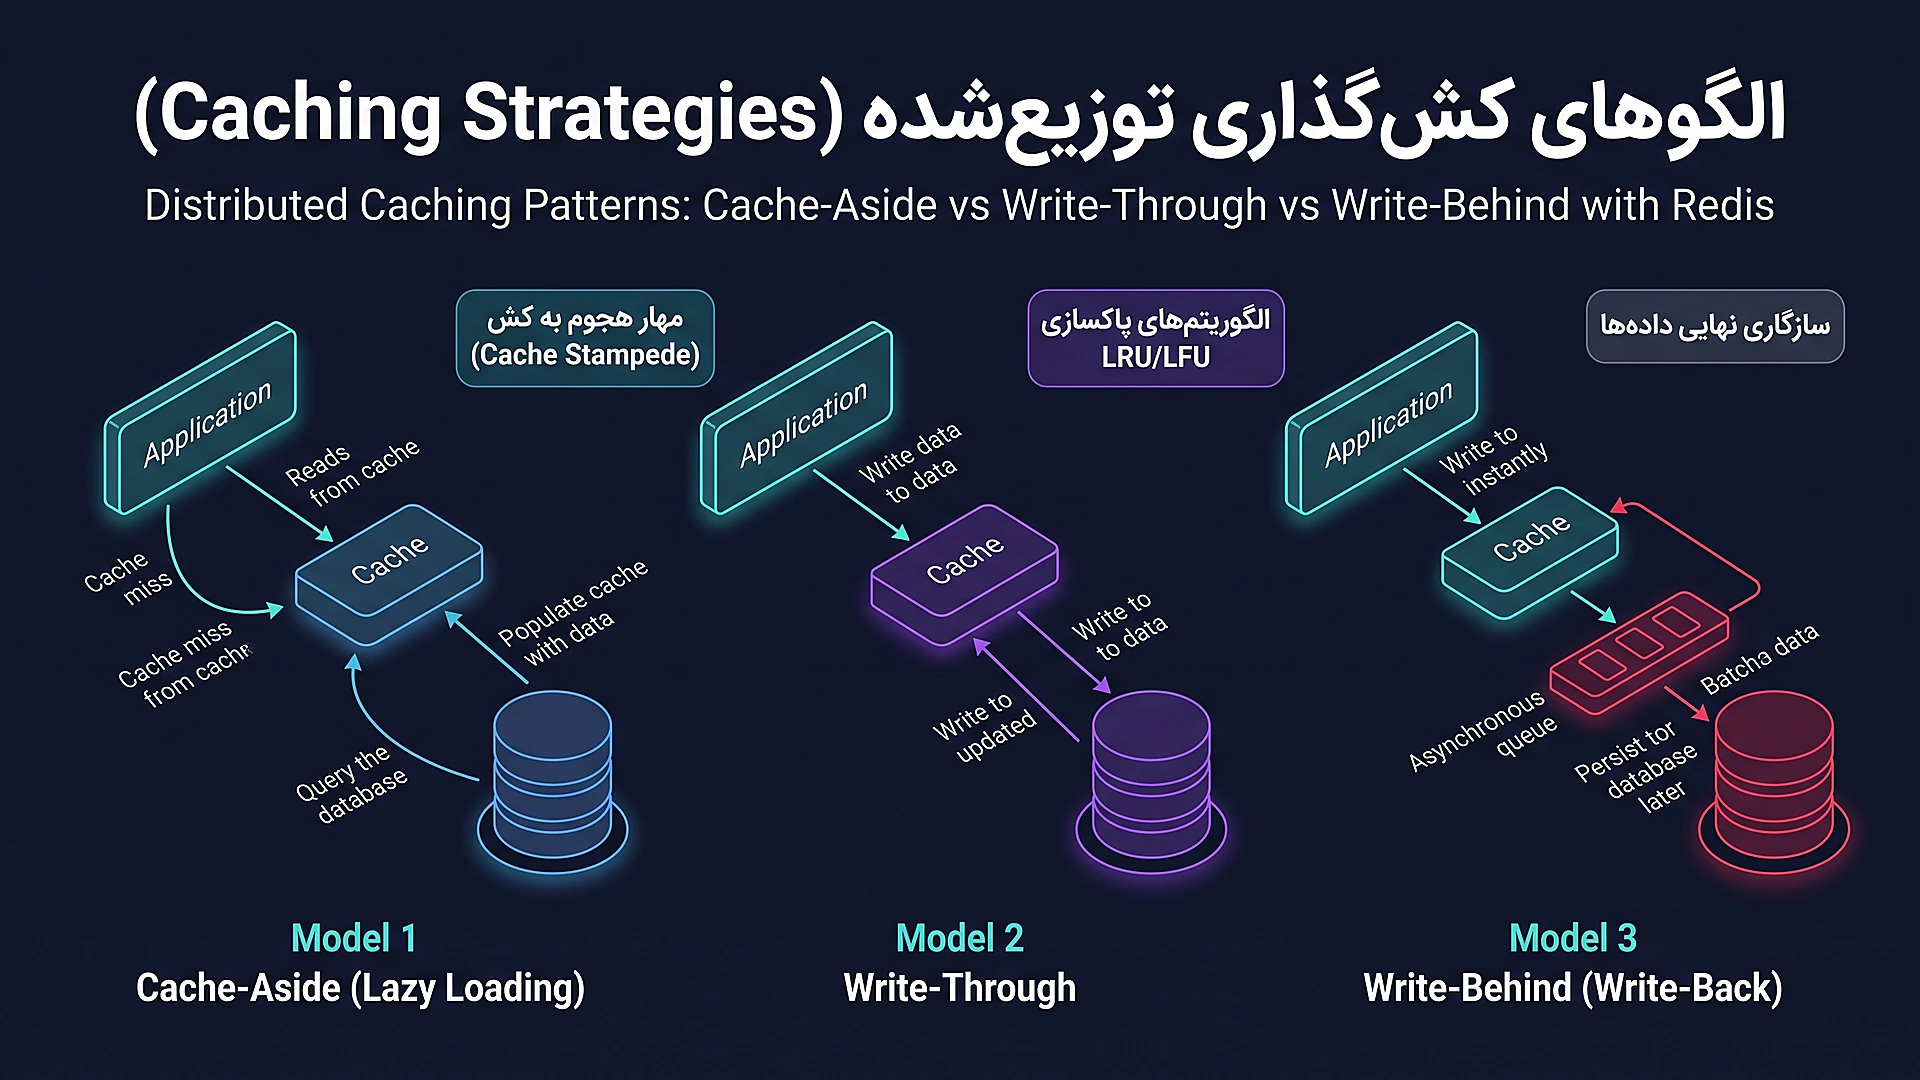
الگوی کنارگذر کش (Cache-Aside / Lazy Loading)
در این الگو، اپلیکیشن مستقیماً وظیفه همگام سازی کش و دیتابیس را بر عهده دارد:
- اپلیکیشن داده را ابتدا از کش استعلام میکند.
- در صورت رخداد Cache Hit، داده بلافاصله بازگردانده میشود.
- در صورت Cache Miss، اپلیکیشن داده را از دیتابیس میخواند، کش را پر میکند و نتیجه را برمیگرداند.
الگوی نوشتن مستقیم (Write-Through)
اپلیکیشن تمام تغییرات را فقط در لایه کش مینویسد. لایه کش وظیفه دارد تا پیش از اعلام موفقیت به اپلیکیشن، تغییرات را به صورت همگام در دیتابیس ثبت کند. این الگو تضمین بالایی برای همگامی داده ها ارائه میدهد اما تاخیر نوشتن را افزایش میدهد.
الگوی نوشتن با تاخیر (Write-Behind / Write-Back)
اپلیکیشن تغییرات را در کش ثبت میکند و پاسخ فوری دریافت مینماید. لایه کش این تغییرات را به صورت ناهمگام در دسته های چندتایی (Batch) در دیتابیس ذخیره میکند. این الگو حداکثر کارایی نوشتن را فراهم میکند اما در صورت قطع ناگهانی برق سرور کش، خطر از دست رفتن داده های اخیر وجود دارد.
مهار پدیده های خطرناک کش
- هجوم به کش (Cache Stampede / Thundering Herd): زمانی که یک کلید پرتقاضا منقضی میشود و ده ها هزار کوئری همزمان به سمت پایگاه داده هجوم میآورند. راهکار: استفاده از قفل توزیع شده (Distributed Lock با Redlock) یا انقضای زودهنگام احتمالی (Probabilistic Early Expiration).
- نفوذ به کش (Cache Penetration): ارسال درخواست برای کلیدهایی که در دیتابیس وجود ندارند، سبب بایپس شدن مداوم کش میشود. راهکار: کش کردن کلیدهای تهی با TTL کوتاه یا استفاده از فیلتر بلوم (Bloom Filter) در ورودی سرویس.
- فروپاشی کش (Cache Avalanche): انقضای همزمان تعداد بسیار زیادی از کلیدها. راهکار: افزودن مقدار تصادفی (Jitter) به زمان TTL کلیدها.
۵. معماری مقیاس پذیری و افراز پایگاه داده (Database Sharding & Federation)
هنگامی که حجم داده ها از سقف ذخیره سازی یک ماشین فیزیکی عبور کند یا توان نوشتن به اشباع برسد، مقیاس پذیری پایگاه داده اجتنابناپذیر میشود.
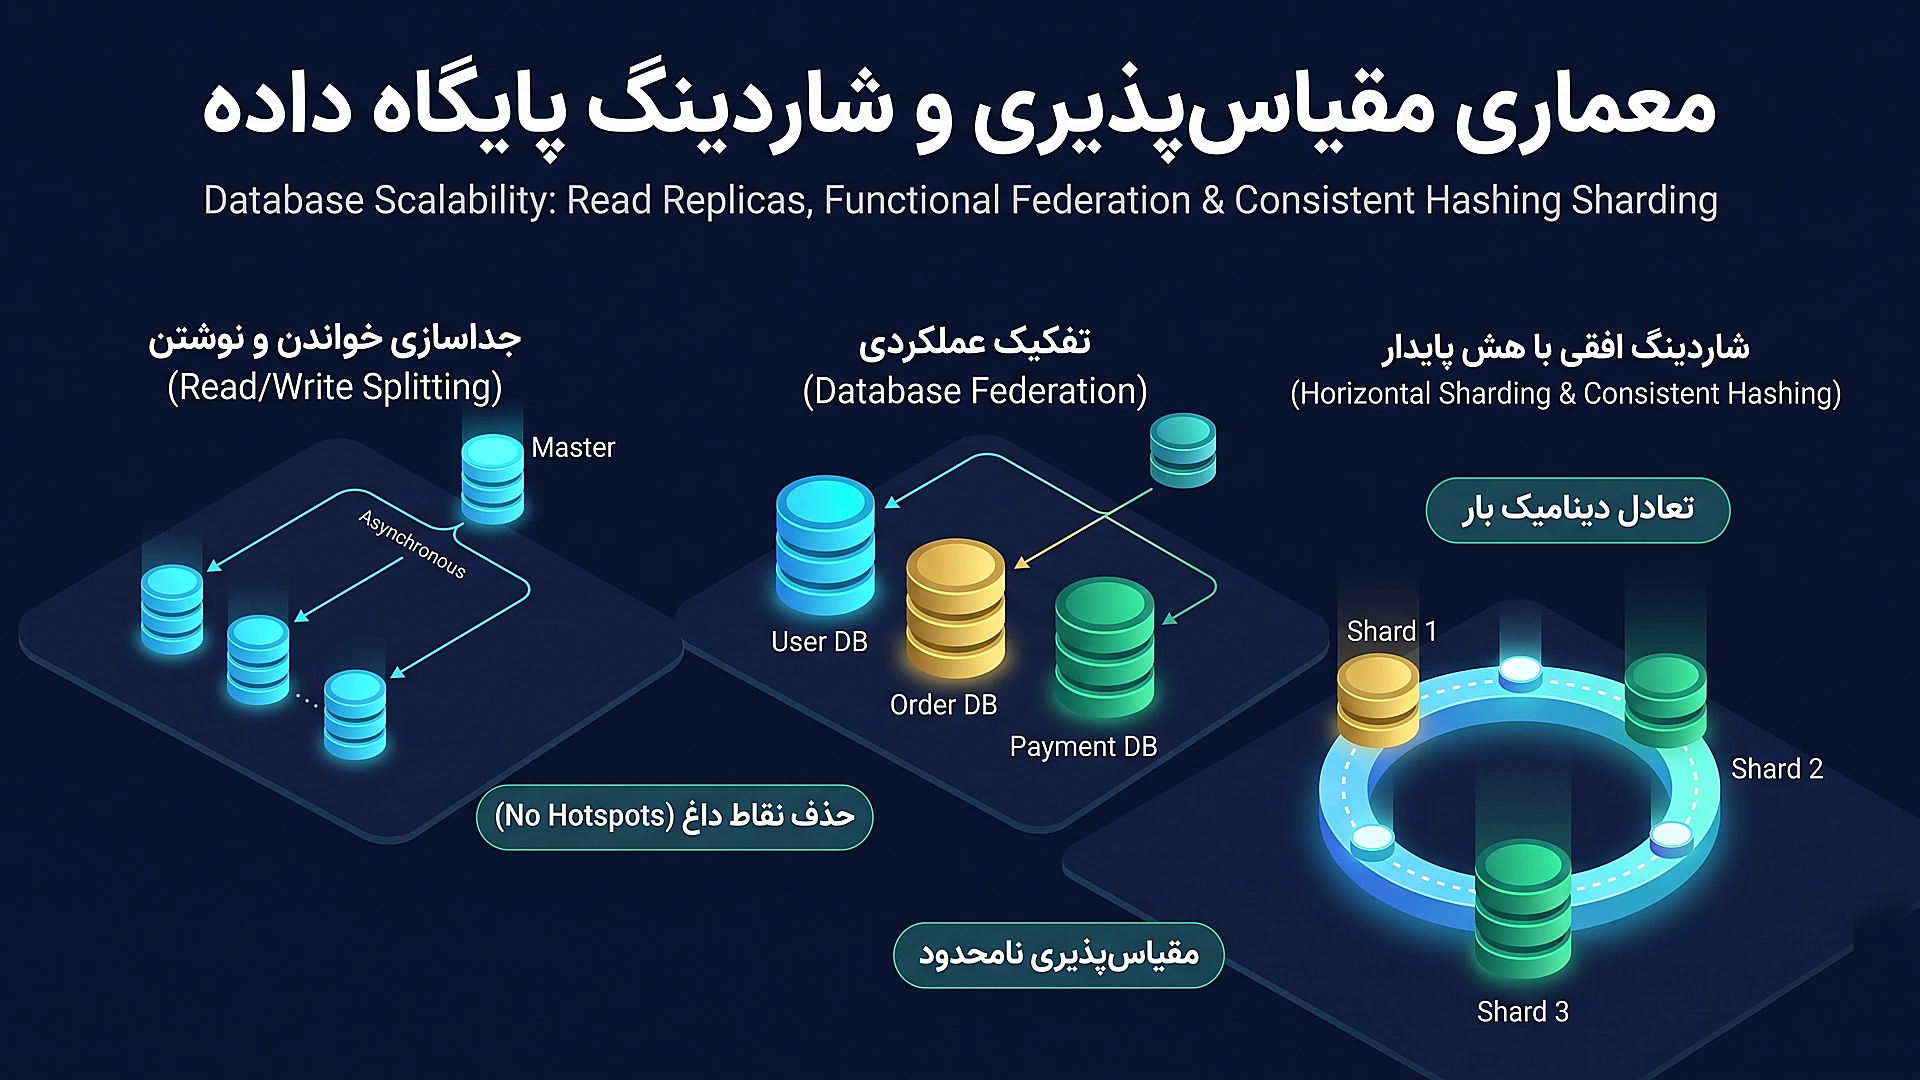
تفکیک خواندن و نوشتن (Read/Write Separation)
با راهاندازی گره اصلی (Master/Primary) برای پذیرش دستورات Insert/Update/Delete و استقرار کپی های تکرارشده (Read Replicas) برای کوئری های Select، بخش اعظمی از بار سیستم تخلیه میشود. در این رویکرد، درک پدیده تاخیر تکثیر (Replication Lag) ضروری است؛ چرا که ممکن است کاربر بلافاصله پس از ثبت پروفایل، تغییرات خود را روی Replica مشاهده نکند (نیاز به الگوی Read-Your-Own-Writes).
شاردینگ افقی (Horizontal Sharding) و هش پایدار (Consistent Hashing)
در شاردینگ افقی، سطرهای یک جدول میان سرور هایی مستقل تفکیک میشوند. استفاده از الگوریتم ساده باقیمانده تقسیم (Hash(Key) % N) فاجعهبار است؛ زیرا با افزودن یا کاستن یک سرور، نیاز به مهاجرت ۹۹٪ داده ها در کلاستر پدید میآید.
هش پایدار (Consistent Hashing) با سازماندهی فضای کلید در قالب یک دایره فرضی (۲ به توان ۳۲ مقدار) و نگاشت سرور های با گره های مجازی (Virtual Nodes) بر روی این دایره، هزینه مهاجرت را هنگام تغییر تعداد گره ها به حداقل نظری (K / N) کاهش میدهد.
کالبدشکافی دقیق مکانیزم های تکثیر داده، خطاهای همزمانی و سطوح ایزولاسیون را در مقاله مرجع تحلیل اصول طراحی سیستم های توزیع شده با تکیه بر DDIA به تفصیل تشریح کردهایم.
۶. الگوریتم های محدودسازی نرخ درخواست (Rate Limiting)
برای محافظت از زیرساخت در برابر حملات انکار سرویس (DoS)، رفتارهای غیرمجاز بات ها و تضمین رعایت انصاف (Fairness) میان مشتریان API، استفاده از مکانیزم های محدودکننده نرخ الزامی است:
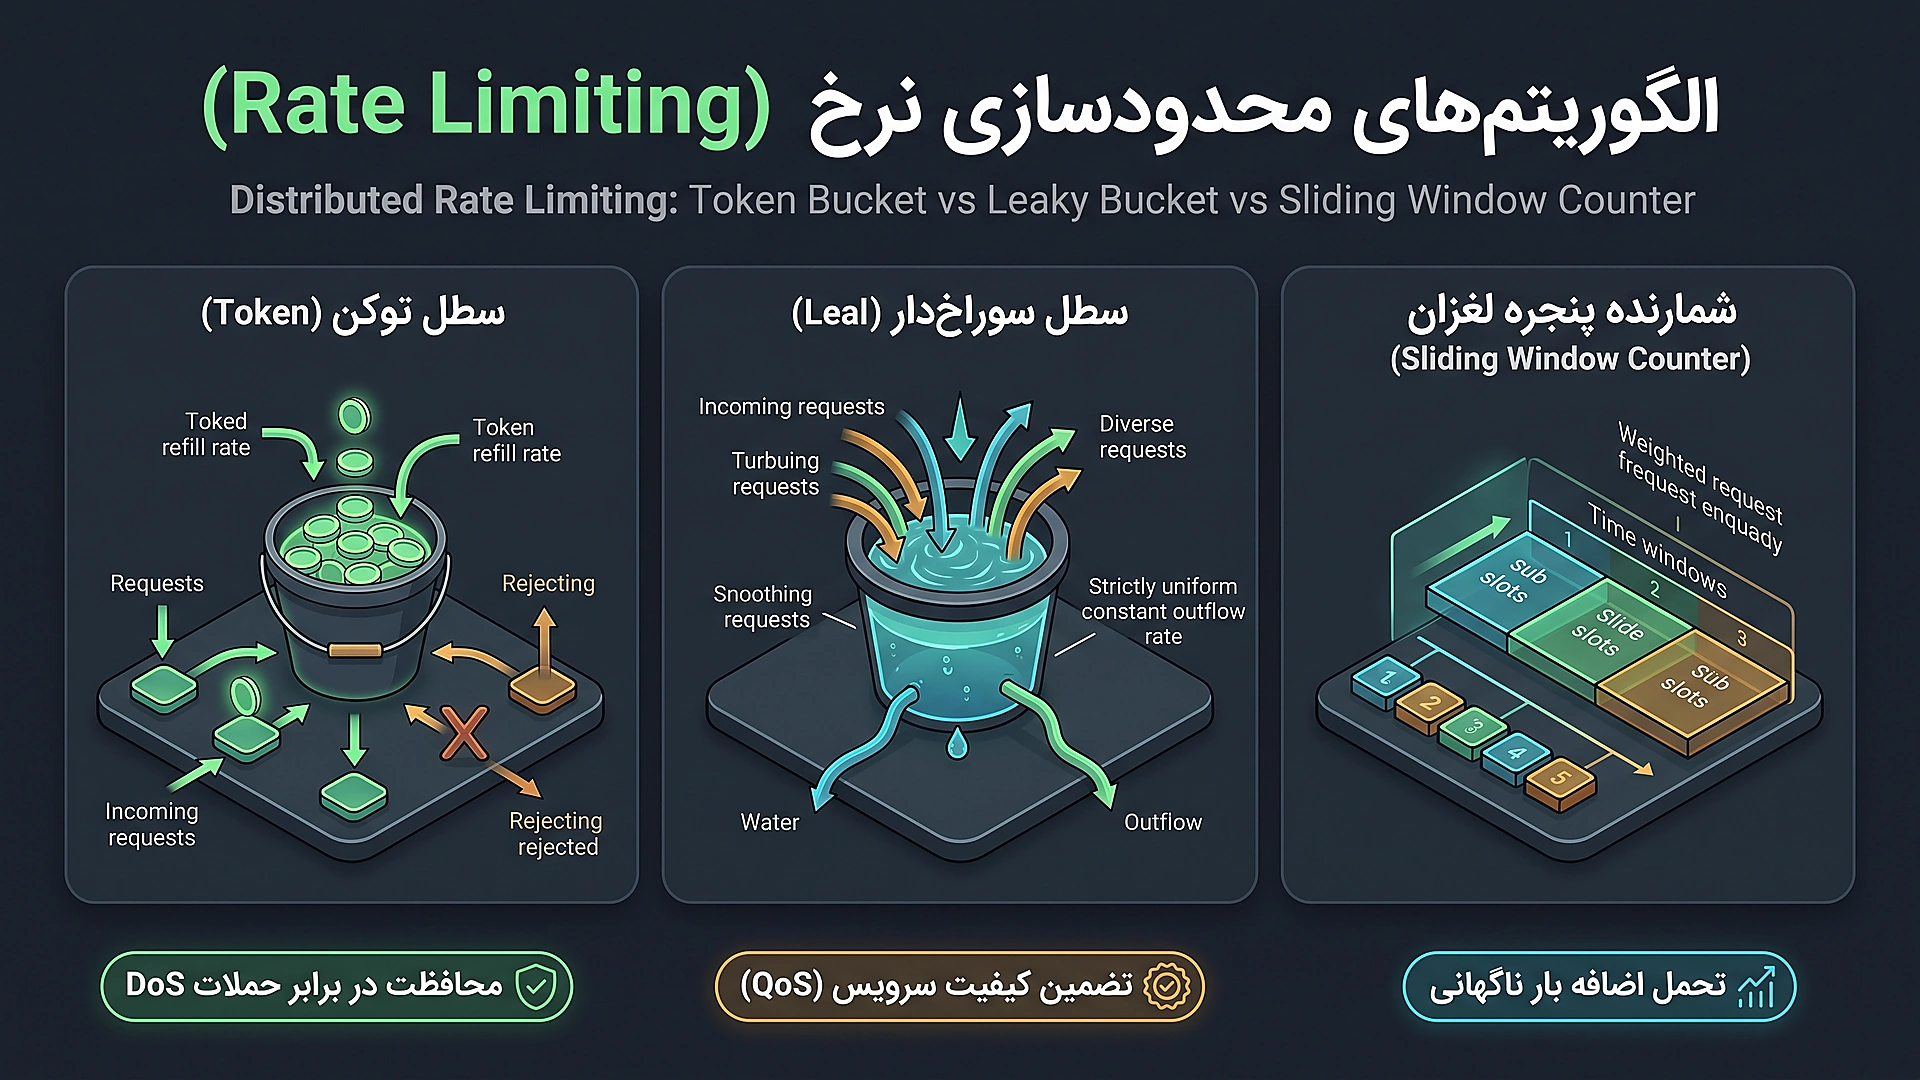
الگوریتم سطل توکن (Token Bucket)
سطلی با ظرفیت $B$ توکن تعریف میشود که در فواصل زمانی منظم با نرخ ثابت $R$ توکن در ثانیه پر میشود. هر درخواست به ازای پردازش یک توکن مصرف میکند. اگر سطل خالی باشد، درخواست بلافاصله با خطای HTTP 429 Too Many Requests رد میشود. ویژگی کلیدی این الگوریتم، توانایی پذیرش جهش های ترافیکی ناگهانی (Burst Traffic) تا سقف حجم سطل است.
الگوریتم سطل سوراخ دار (Leaky Bucket)
درخواست ها با هر سرعتی وارد یک صف اولویت با ظرفیت مشخص میشوند و با نرخ اکیداً ثابت و پیوسته به سرور هایی پردازشی تحویل میگردند. این الگو جریان نامنظم را به خروجی کاملاً هموار تبدیل میکند و برای سرویس هاییی با پردازش های سنگین پسزمینه مناسب است.
شمارنده پنجره لغزان در ردیس (Sliding Window Counter)
# پیاده سازی اتمیک پنجره لغزان با استفاده از دستورات پایپ لاین ردیس
import time
import redis
r = redis.Redis(host='localhost', port=6379, db=0)
def is_allowed_sliding_window(user_id, limit=100, window_seconds=60):
now = time.time()
clear_before = now - window_seconds
key = f"rate_limit:{user_id}"
pipe = r.pipeline()
# ۱. حذف درخواست های قدیمیتر از پنجره فعلی
pipe.zremrangebyscore(key, 0, clear_before)
# ۲. ثبت درخواست فعلی با امتیاز برچسب زمانی
pipe.zadd(key, {str(now): now})
# ۳. شمارش کل درخواست های موجود در پنجره لغزان
pipe.zcard(key)
# ۴. تعیین زمان انقضای کلید
pipe.expire(key, window_seconds + 5)
_, _, current_count, _ = pipe.execute()
return current_count ۷. تئوری های بنیادین سیستم های توزیع شده: قضیه CAP و قضیه PACELC
در طراحی سیستم های توزیع شده، قوانین ریاضی تعیینکننده حدود اختیارات معمار نرم افزار هستند.
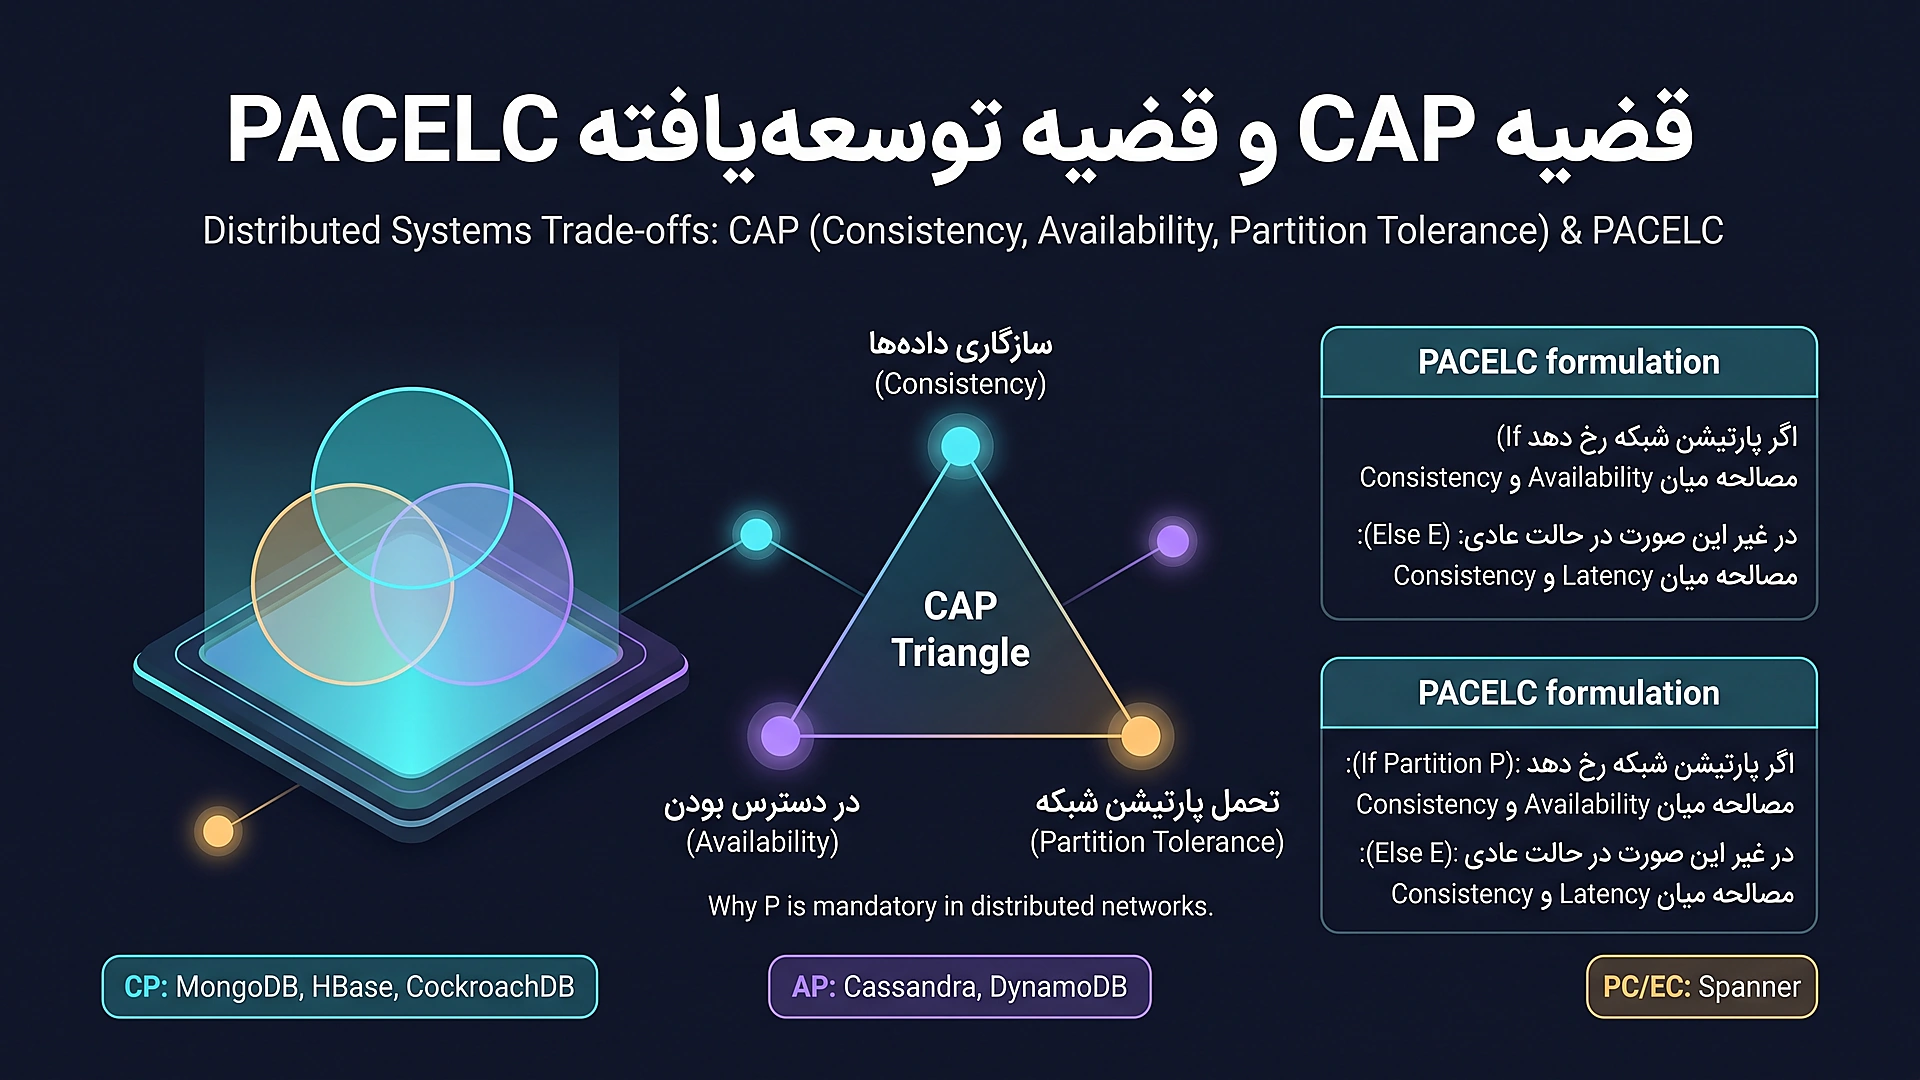
قضیه CAP (Consistency, Availability, Partition Tolerance)
قضیه اریک بروئر بیان میکند که یک سیستم توزیع شده بر بستر شبکه ناپایدار، تنها میتواند دو مورد از این سه ویژگی را تضمین کند. از آنجا که در شبکه های دنیای واقعی گسست فیزیکی کابل ها یا تاخیر روترها حتمی است، انتخاب تحمل پارتیشن (Partition Tolerance - P) اجباری است. در نتیجه سیستم ها به دو دسته تقسیم میشوند:
- سیستم های CP (سازگاری بالا): در هنگام قطعی شبکه، برای جلوگیری از ثبت داده های متناقض، درخواست ها تا زمان همگرایی رد میشوند (نظیر دیتابیس های مالی و بانکی).
- سیستم های AP (دسترس پذیری بالا): سیستم به پاسخدهی به کاربران ادامه میدهد، حتی اگر داده های گره ها موقتاً ناهمگام باشند (مانند لایک و اشتراکگذاری در اینستاگرام و توییتر).
قضیه تکمیلی PACELC
قضیه CAP تنها سناریوی شکست شبکه را مدل سازی میکند. قضیه PACELC (دنیل آبادی) پرسش مهمتری مطرح میکند: در ۹۹.۹٪ مواقع که شبکه به درستی کار میکند چه مصالحهای حاکم است؟
فرمولبندی: If Partition (P) choose between Availability (A) or Consistency (C); Else (E) choose between Latency (L) or Consistency (C). به این معنا که حتی در حالت عادی، برای داشتن سازگاری سختگیرانه باید تاخیر شبکه بیشتری برای هماهنگی نودها تحمل کنید، یا با فدا کردن اندکی سازگاری، پاسخ فوقالعاده سریع به کلاینت بدهید.
برای پیاده سازی سیستم های فوق سریع با سازگاری بالا بر پایه لاگ های نامتقارن، مطالعه مقاله راهنمای جامع معماری رویداد محور با آپاچی کافکا به شدت توصیه میشود.
۸. چک لیست طلایی معمار سیستم برای استقرار در مقیاس بالا
| حوزه معماری | الگوی پیشنهادی استاندارد | سنجه ارزیابی عملکرد (SLA / SLO) |
|---|---|---|
| ورودی شبکه و لبه | L۴ IPVS + Anycast DNS + L۷ Envoy API Gateway | تاخیر شبکه کمتر از ۵ میلیثانیه در لبه |
| لایه محاسباتی | Stateless Services در کلاستر کوبرنتیز با قابلیت HPA | تطبیق توان و مصرف CPU زیر ۶۰٪ |
| لایه کش | ردیس کلاستر با مدل Cache-Aside و الگوریتم LRU | نرخ Cache Hit بالای ۹۰٪ |
| پایگاه داده رابطهای | Primary + Multi Read-Replicas با شاردینگ افقی | تاخیر کوئری کمتر از ۱۵ میلیثانیه |
| پیامرسانی ناهمگام | آپاچی کافکا با پارتیشن بندی و تضمین At-Least-Once | حجم پردازش بالای ۱۰۰,۰۰۰ پیام در ثانیه |
| رصدپذیری سیستم | ردیابی توزیع شده با OpenTelemetry و Prometheus | کشف خرابی کمتر از ۳۰ ثانیه در مانیتورینگ |
جمع بندی و نتیجه گیری
طراحی سیستم های توزیع شده فرآیندی پویا و مبتنی بر درک دقیق مصالحه ها (Trade-offs) است. هیچ راهحل جادویی یا معماری واحدی وجود ندارد که پاسخگوی تمامی سناریوها باشد. هنر یک مهندس ارشد نرم افزار، سنجش واقعبینانه نیازمندی های کسبوکار، تحلیل ترافیک داده، ایزولاسیون دقیق مرزها و انتخاب ترکیب متوازنی از ابزار های ذخیره سازی، کشگذاری و صف های ناهمگام است تا سیستمی پایدار، مقیاس پذیر و خودترمیم در برابر بحران های غیرمترقبه ایجاد نماید.
امتیاز و نظرات
هنوز نظری ثبت نشده است. اولین نفر باشید.