
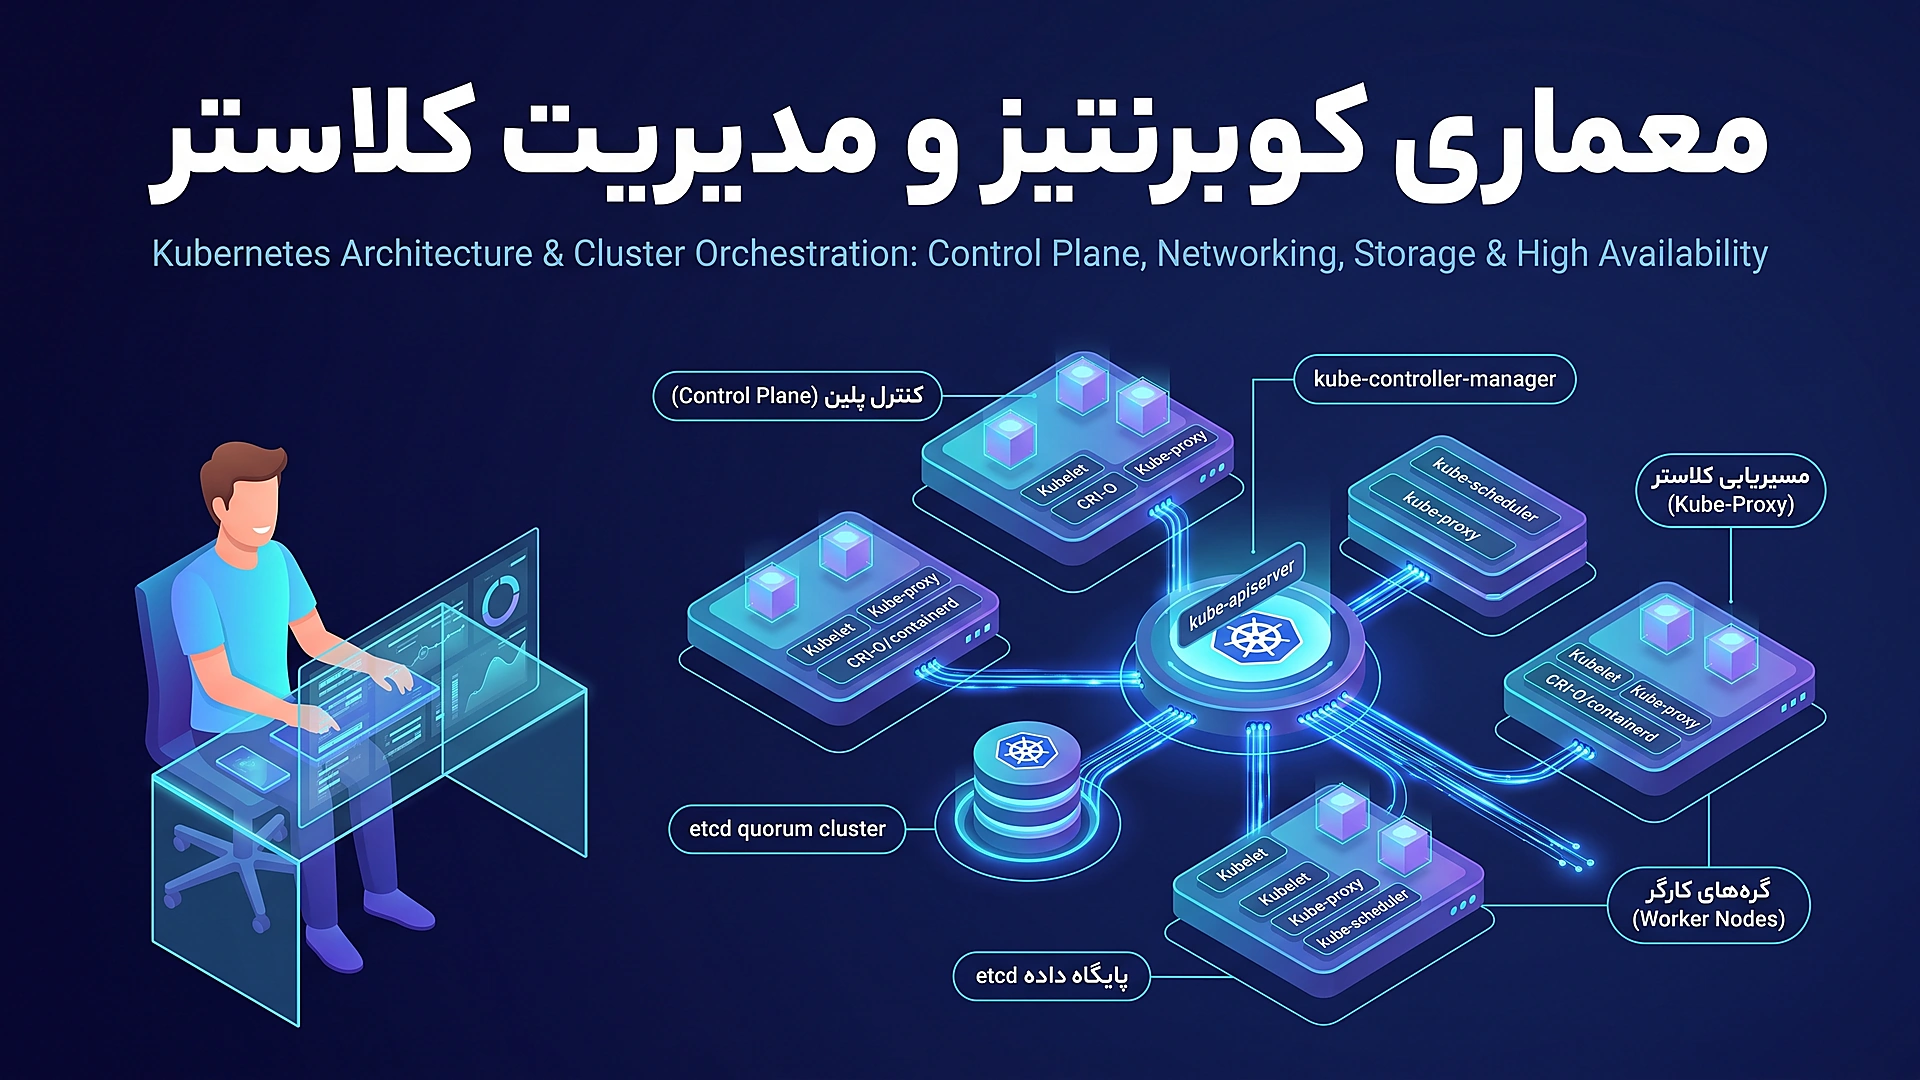
از مدیریت ایزوله کانتینرها تا ارکستراسیون دیتاسنترهای توزیعشده با کوبرنتیز
کانتینرسازی با داکر (Docker) انقلاب بزرگی در یکپارچگی محیط اجرا رقم زد، اما زمانی که یک سامانه Enterprise با صدها میکروسرویس، هزاران کانتینر همزمان، ترافیک متغیر و نیاز به استقرار بدون حتی یک ثانیه داونتایم وارد میدان میشود، داکر به تنهایی فلج خواهد شد. اینجاست که کوبرنتیز (Kubernetes یا K۸s) به عنوان سیستمعامل ابر و پلتفرم استاندارد ارکستراسیون وارد صحنه میگردد. در این راهنمای جامع مهندسی، معماری درونی کنترل پلین، ساختار گرههای کارگر، چرخه حیات پادها، ترافیک شبکه CNI و استراتژیهای خطایابی پروداکشن را بدون حاشیه و با تحلیل عمیق کالبدشکافی میکنیم.
پارادایم ارکستراسیون در معماری ابری نوین
در اوایل ظهور مفهوم میکروسرویس، مهندسان با استفاده از دستورات دستی docker run یا اسکریپتهای پیچیده docker-compose کانتینرها را روی چند سرور مجازی پراکنده مستقر میکردند. این رویکرد سنتی تا زمانی که تعداد سرویسها انگشتشمار بود پاسخگو به نظر میرسید؛ اما به محض اینکه یکی از سرورها دچار نقص فیزیکی میشد، حافظه رم سرور پر میشد، یا نسخه جدیدی از اپلیکیشن باید بدون قطع ترافیک کاربران جایگزین میگردید، بحران زیرساختی آغاز میشد.
مدیریت دستی کانتینرها با چالشهای مرگباری روبرو بود:
- عدم خودترمیمی (Lack of Self-Healing): اگر پروسس کانتینر کرش میکرد یا با خطای خروج از حافظه (OOM) متوقف میشد، هیچ مکانیزم هوشمندی برای راهاندازی خودکار آن روی یک گره سالم دیگر وجود نداشت و سرویس تا زمان بیدار شدن مهندس شیفت قطع میماند.
- توزیع بار کورکورانه: توزیع ترافیک میان سرورها به تنظیمات شکننده و دستی در NGINX یا HAProxy وابسته بود که با هر جابجایی کانتینر نیاز به بارگذاری مجدد فایل تنظیمات داشت.
- نبود مقیاسپذیری خودکار (Autoscaling): در زمان پیک ترافیک ناگهانی، افزودن کپیهای جدید نیازمند دخالت انسانی یا کدهای پیچیده اختصاصی بود که با تاخیر عمل میکردند.
فلسفه وضعیت مطلوب و حلقه آشتی کوبرنتیز
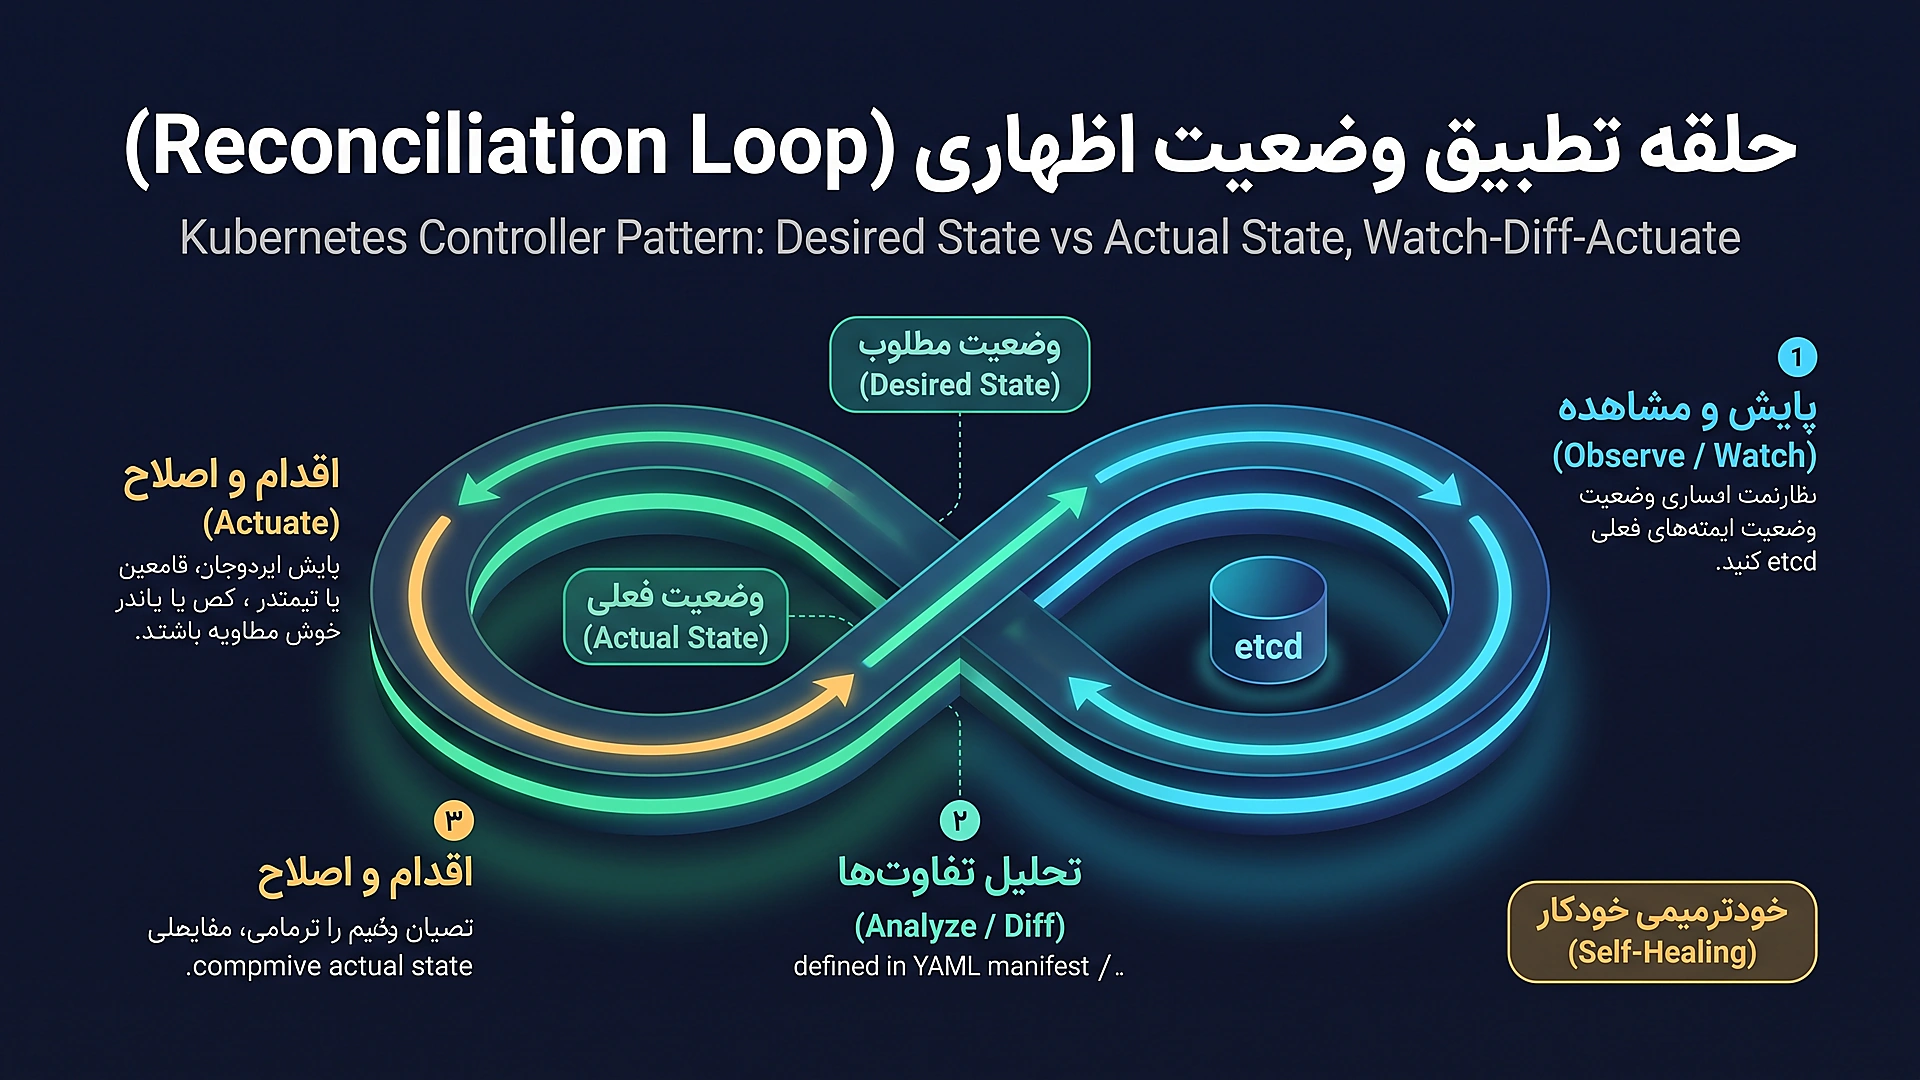
کوبرنتیز تمام این مدل تفکر را دگرگون ساخت. کوبرنتیز بر پایه یک اصل بنیادین ریاضی و فلسفی در سیستمهای کنترل به نام حلقه آشتی یا تطبیق (Reconciliation Loop) عمل میکند. در این الگو، مهندس نرمافزار هرگز به کوبرنتیز نمیگوید «همین الان فلان کار را انجام بده (Imperative Approach)»؛ بلکه مهندس در قالب فایلهای مانیفست YAML، وضعیت مطلوب (Desired State) سیستم را اعلام میکند (Declarative Approach)؛ مثلاً: «من ۵ کپی فعال، با حداقل ۲۵۶ مگابایت رم، و متصل به این نسخه از ایمیج میخواهم.»
کنترلرهای کوبرنتیز به صورت پیوسته در یک حلقه با فرکانس بالا وضعیت زنده کلاستر (Current State) را استعلام کرده و آن را با وضعیت مطلوب (Desired State) ذخیرهشده در دیتابیس کلاستر مقایسه میکنند. اگر سروری آتش بگیرد و تعداد پادها از ۵ به ۳ کاهش یابد، کنترلر بلافاصله این اختلاف را تشخیص داده و بدون نیاز به هیچ مداخله انسانی، ۲ پاد جایگزین را روی سایر گرههای سالم زمانبندی و فعال مینماید.
این الگوی کنترلی تضمین میکند که کلاستر همواره به سمت پایداری، رفع عیوب خودکار و تطابق با نیازهای تجاری میل کند؛ مفهومی که اصطلاحاً به آن «زیرساخت خودترمیم (Self-Healing Infrastructure)» میگویند.
کالبدشکافی لایه کنترل پلین کلاستر
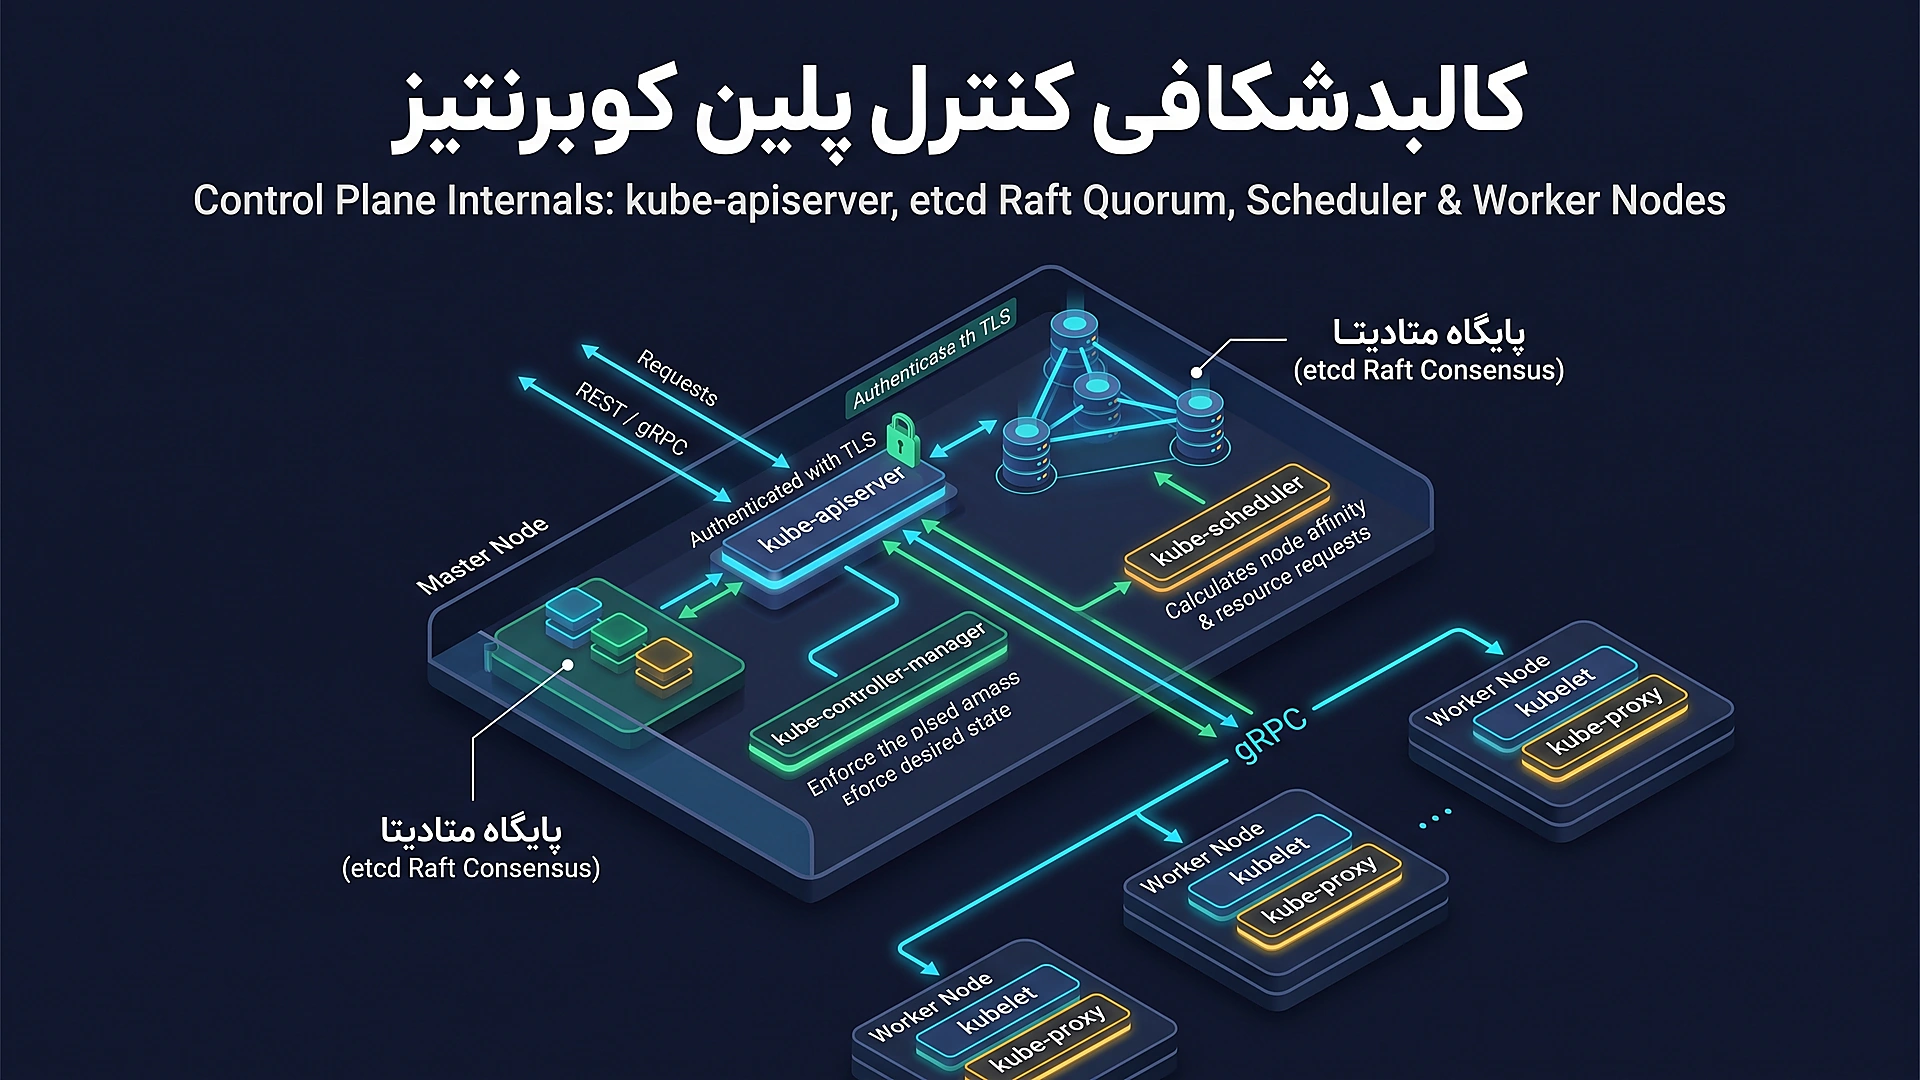
مغز متفکر کلاستر کوبرنتیز، کنترل پلین (Control Plane) نام دارد. این لایه مسئول حفظ وضعیت کلی، اتخاذ تصمیمات سراسری (مانند برنامهریزی استقرار پادها)، شناسایی خطاها و پاسخدهی به رویدادهای کلاستر است:
هسته مرکزی و دروازه امنیتی kube-apiserver
کامپوننت kube-apiserver دروازه ورود به دنیای کوبرنتیز است. این کامپوننت تنها بخشی از کنترل پلین است که به طور مستقیم با کاربران، ابزارهای CLI مانند kubectl، پایپلاینهای CI/CD و حتی عاملهای گرههای کارگر ارتباط برقرار میکند. تمامی ارتباطات از طریق پروتکل RESTful بر بستر HTTPS با رمزنگاری پیشرفته mTLS انجام میپذیرد.
هر درخواستی که به API Server میرسد، باید از سه فیلتر قدرتمند عبور کند:
- احراز هویت (Authentication): بررسی هویت کاربر یا ServiceAccount از طریق گواهیهای کلاینت X.۵۰۹، توکنهای OpenID Connect (OIDC) یا وبهوکهای امنیتی.
- اعتبارسنجی سطح دسترسی (Authorization): اعمال قوانین کنترل دسترسی نقشمحور (RBAC) برای اطمینان از اینکه کاربر مجوز انجام عملیات روی Namespace یا آبجکت مشخص را دارد.
- کنترلکنندههای پذیرش (Admission Controllers): هوکهای اعتبارسنجی و جهشدهنده (Mutating & Validating Webhooks) که میتوانند مانیفست را بازرسی، اصلاح یا در صورت نقض خطمشیهای امنیتی کلاستر رد کنند. به عنوان مثال، یک هوک اعتبارسنجی میتواند مانیفستهایی که
runAsUser: 0(دسترسی Root) دارند را بلافاصله مسدود نماید.
پایگاه داده توزیع شده etcd و الگوریتم اجماع Raft
تمام دادههای کلاستر، وضعیت پادها، تعاریف Serviceها، Secretها و تاریخچه رویدادها در پایگاه داده کلید-مقدار etcd ذخیره میشود. کامپوننت etcd قلب تپنده و تنها بخش حالتدار (Stateful) در کنترل پلین است؛ هیچ کامپوننت دیگری در کوبرنتیز وضعیت را در خود نگه نمیدارد.
پایگاه داده etcd از الگوریتم اجماع توزیعشده Raft استفاده میکند که برای درک رفتار محاسباتی و تحلیل تاخیر آن میتوان به مبانی تحلیل پیچیدگی و نماد Big-O رجوع کرد. در کلاسترهای پروداکشن، همواره تعداد فردی از نودهای etcd (معمولاً ۳ یا ۵ نود) تشکیل کلاستر میدهند تا سیستم در برابر خرابی همزمان یک یا دو نود مقاومت کند (Quorum بر اساس فرمول (N/۲)+۱). تنها کامپوننتی که اجازه اتصال مستقیم به دیتابیس etcd را دارد، kube-apiserver است؛ هیچ جزء دیگری در کلاستر حق تماس مستقیم با دیتابیس را ندارد که این امر امنیت و یکپارچگی دادهها را تضمین مینماید.
دیسکهای زیرساختی نودهای etcd باید بالاترین سرعت نوشتن تصادفی (IOPS بالا بر بستر درایوهای NVMe SSD) را داشته باشند؛ زیرا هرگونه تاخیر بیش از ۱۰ میلیثانیه در عملیات fsync دیتابیس etcd میتواند منجر به شکست لیدرشیپ و ناپایداری کل کلاستر گردد.
موتور زمانبندی هوشمند kube-scheduler
وقتی یک پاد جدید بدون گره مشخص ایجاد میشود، در وضعیت Pending قرار میگیرد. در این لحظه، kube-scheduler وارد عمل میشود تا بهینهترین گره فیزیکی یا مجازی را برای اجرای پاد پیدا کند. این فرایند در دو مرحله دقیق انجام میپذیرد:
- فیلتر کردن (Filtering / Predicates): گرههایی که شرایط اجرای پاد را ندارند کنار گذاشته میشوند؛ مثلاً گرههایی که منابع CPU یا RAM ناکافی دارند، یا گرههایی که دارای نشانهگذاری منع (Taints) بدون تطابق (Tolerations) در پاد هستند.
- امتیازدهی (Scoring / Priorities): در میان گرههای باقیمانده، بر اساس الگوریتمهای پیچیده (نظیر پخش متوازن بار در کلاستر، هماهنگی میل به قرارگیری نزدیک Pod Affinity، یا قرارگیری در دامنههای شکست مجزا Topology Spread Constraints) به هر گره امتیاز داده شده و پاد به گره با بالاترین امتیاز واگذار میشود.
مدیر کنترلرهای کلاستر kube-controller-manager
این کامپوننت در برگیرنده دهها حلقه کنترلی مجزاست که همگی در قالب یک باینری واحد اجرا میشوند. از جمله مهمترین کنترلرهای داخلی میتوان به Node Controller (پایش زنده بودن سرورها و تخلیه پادها در صورت قطعی نود)، Deployment Controller (هدایت استراتژیهای Rolling Update)، و EndpointSlice Controller (اتصال IP پادها به سرویسهای شبکه) اشاره کرد.
کالبدشکافی گرههای کارگر و رانتایم کانتینر
گرههای کارگر (Worker Nodes) همان سرورهای فیزیکی یا ماشینهای مجازی هستند که بار کاری اصلی، اپلیکیشنها و پردازشها را میزبانی میکنند. در هر گره کارگر، سه جزء کلیدی همواره فعال هستند:
عامل سیستمی Kubelet و اینترفیس CRI
Kubelet مهمترین نماینده کوبرنتیز در هر گره است. کیوبلت مانند یک کاپیتان اجرایی، پیوسته از طریق API Server دستورات اختصاص داده شده به گره خود (PodSpecs) را دریافت کرده و اطمینان حاصل میکند که کانتینرهای تعریفشده در آن پادها به درستی ساخته، اجرا و سالم نگهداری میشوند.
کیوبلت خودش مستقیماً کانتینر ایجاد نمیکند؛ بلکه از طریق یک استاندارد باز به نام رابط رانتایم کانتینر (CRI - Container Runtime Interface) با موتورهای رانتایم مدرن مانند Containerd یا CRI-O با استفاده از سوکتهای لینوکس و کانکشنهای gRPC گفتگو میکند. کیوبلت همچنین مسئول اجرای پروبهای سلامت و گزارش معیارهای مصرف حافظه و پردازنده به سرور مرکزی است.
موتور مسیریابی بستهها با Kube-Proxy و IPVS
هر پاد در کوبرنتیز دارای یک IP منحصربهفرد و موقت است. برای اینکه ترافیک کلاینتها بدون وابستگی به تغییر IP پادها به آنها برسد، شیء مجازی Service وجود دارد. وظیفه kube-proxy پیادهسازی این انتزاع شبکه روی تکتک گرههاست.
کیوبپروکسی در دو حالت عمده میتواند کار کند:
- حالت iptables: کیوبپروکسی برای هر سرویس، قوانینی در جدول Netfilter لینوکس ثبت میکند. در کلاسترهای بزرگ با هزاران سرویس، پیمایش خطی زنجیرههای iptables مرتبه زمانی O(n) پیدا کرده و به افت عملکرد هسته لینوکس میانجامد.
- حالت مدرن IPVS (IP Virtual Server): بر پایه جداول درهمسازی هسته لینوکس کار کرده و مرتبه اتصال را به O(۱) میرساند. این حالت برای سیستمهای سازمانی با حجم اتصالات بالا و کلاسترهای حجیم استاندارد طلایی است.
مهاجرت از داکر به Containerd در لایه زیرساخت
در نسخههای اولیه کوبرنتیز، داکر موتور رانتایم پیشفرض بود. اما داکر یک ابزار کامل توسعه با لایههای اضافه (مانند Docker CLI، دیمن dockerd، ابزارهای شبکه اختصاصی و بیلد ایمیج) است که نیازی به وجود آنها روی سرورهای پردازشی کلاستر نبود. کوبرنتیز مجبور بود از یک لایه واسط سنگین به نام dockershim برای ترجمه دستورات استفاده کند.
با حذف داکرشم در نسخههای نوین کوبرنتیز، ارتباط مستقیماً با Containerd (هسته سبکوزن رانتایم داکر) برقرار میشود. این اقدام مصرف رم سرورها را تا ۱۵٪ کاهش داده، سرعت راهاندازی پادها را دو برابر کرده و زنجیره آسیبپذیریهای امنیتی را به حداقل رسانده است.
چرخه حیات پاد و مدیریت خطاها
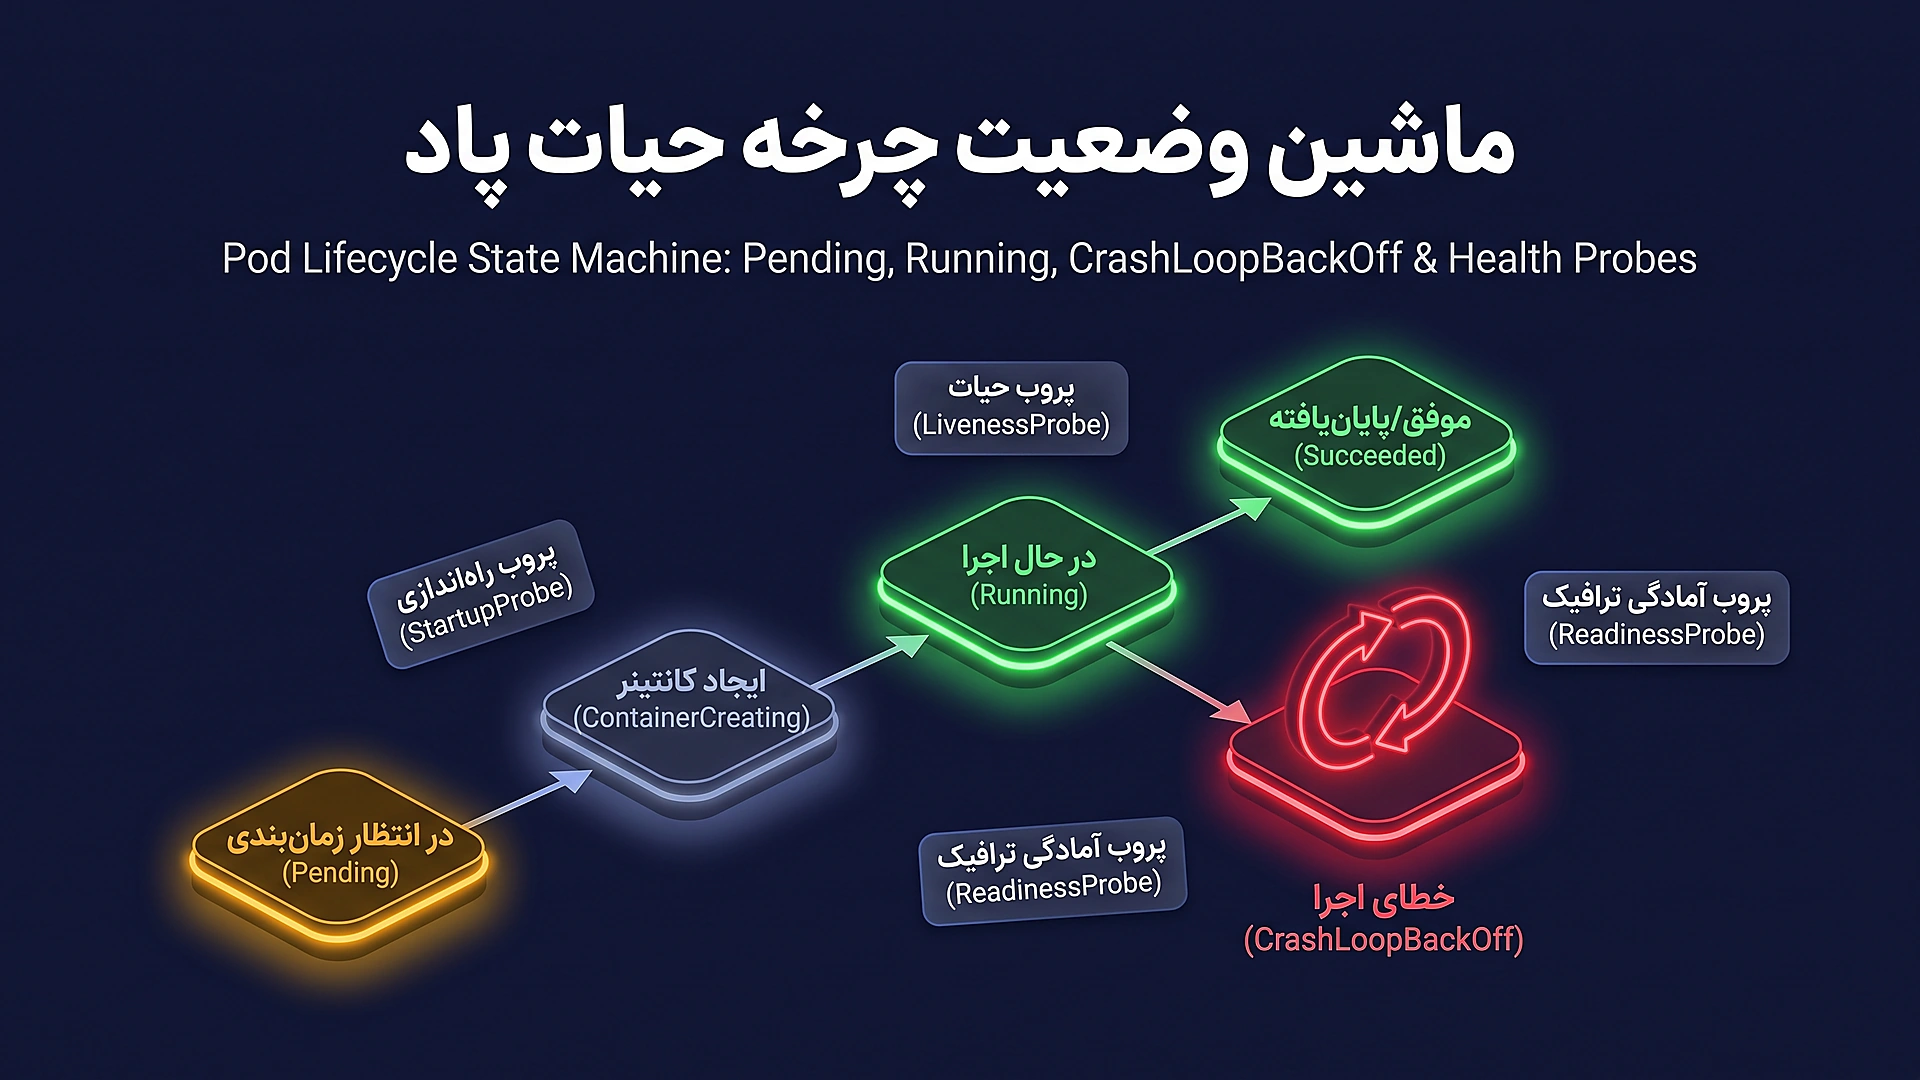
پاد (Pod) کوچکترین واحد پردازشی و اتمی در کوبرنتیز است. یک پاد میتواند شامل یک یا چند کانتینر باشد که فضای نام شبکه (Network Namespace)، آدرس IP، و درایوهای ذخیرهسازی مشترک را با یکدیگر سهیم هستند:
تحلیل و رفع خطای مشهور CrashLoopBackOff
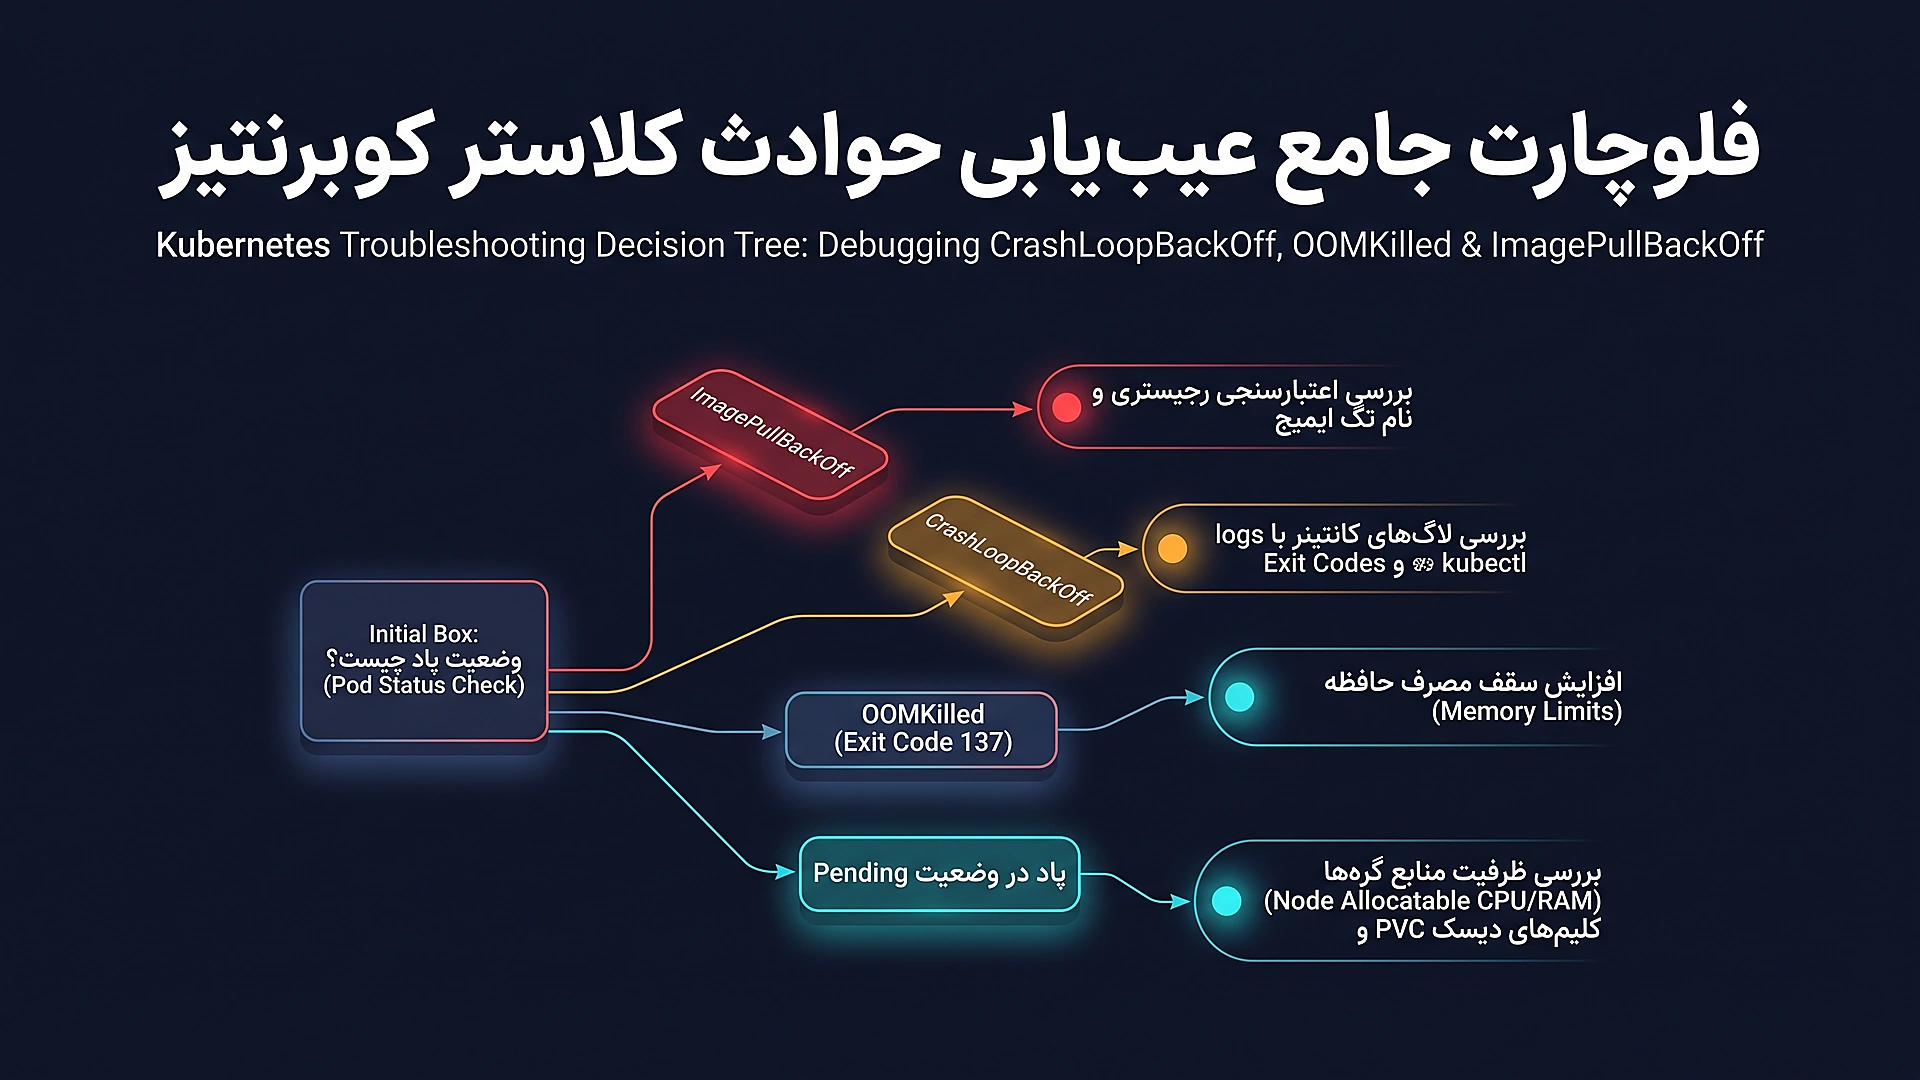
یکی از پرتکرارترین خطاها در مانیتورینگ دواپس، قرار گرفتن پاد در وضعیت CrashLoopBackOff است. این وضعیت یک فاز نیست، بلکه نشاندهنده یک الگوی رفتاری است: کانتینر شروع به کار میکند، اما بلافاصله با خطایی خارج میشود (Exit Code غیر صفر)؛ کیوبلت تلاش میکند آن را مجدداً راهاندازی کند، اما مجدداً کرش میکند. برای جلوگیری از فلج شدن گره در اثر راهاندازیهای مکرر، کیوبلت از استراتژی Exponential Backoff (تاخیرهای افزایشی ۱۰ ثانیه، ۲۰ ثانیه تا ۵ دقیقه) استفاده مینماید.
شایعترین دلایل این رخداد عبارتند از:
- خطای OOMKilled (Exit Code ۱۳۷): کانتینر بیش از سقف تعیینشده در
resources.limits.memoryحافظه مصرف کرده و سیگنال SIGKILL توسط کرنل لینوکس برای آن ارسال شده است. - فقدان متغیر محیطی یا Secret: برنامه در لحظه بوت به متغیری نیاز دارد که در ConfigMap تعریف نشده است.
- عدم دسترسی به پایگاه داده: سرویس بلافاصله در بلوک Main به دلیل خطای اتصال دیتابیس با خروجی Exit Code ۱ خارج میشود.
تنظیم پروبهای Startup ،Liveness و Readiness
بسیاری از مهندسان این سه پروب را به جای یکدیگر استفاده میکنند که میتواند منجر به فجایع پروداکشن شود:
- پروب آمادهبهکاری (Readiness Probe): مشخص میکند آیا پاد آماده دریافت ترافیک کاربر است یا خیر؟ اگر این پروب رد شود، کانتینر هرگز ریاستارت نمیشود! بلکه صرفاً آدرس IP پاد از Endpoints سرویس حذف میشود تا ترافیکی به آن هدایت نشود.
- پروب زندهبودن (Liveness Probe): بررسی میکند که آیا پروسس دچار بنبست (Deadlock) شده است؟ اگر این پروب چند بار متوالی شکست بخورد، کیوبلت کانتینر را بلافاصله کشته و از نو راهاندازی میکند.
- پروب راهاندازی اولیه (Startup Probe): برای برنامههای سنگین و سنتی (مانند سرویسهای بزرگ جاوا/اسپرینگ) که لود اولیه آنها ممکن است ۱ الی ۲ دقیقه طول بکشد. این پروب سایر پروبها را موقتاً غیرفعال میکند تا از ریاستارت ناخواسته برنامه در حین بوت جلوگیری شود.
مدیریت بهینه Resource Requests و Limits
تعریف مقادیر منابع در مانیفستها دو اثر کاملاً متفاوت دارد:
مقدار requests برای تصمیمگیری زمانبند (Kube-Scheduler) استفاده میشود. زمانبند بر اساس مجموع درخواستهای گره تصمیم میگیرد؛ بنابراین اگر مقدار Requests بیش از حد بالا تنظیم شود، ظرفیت کلاستر بیهوده هدر رفته و پادها بیهوده در حالت Pending میمانند.
در نقطه مقابل، مقدار limits سقف فیزیکی است که توسط Cgroups در لینوکس اعمال میشود. در مورد پردازنده (CPU)، اگر کانتینر به Limit برسد، پردازش آن صرفاً کند (Throttle) میشود؛ اما در مورد حافظه (RAM)، رسیدن به Limit مستقیماً منجر به فرآیند OOMKilled و خاموشی ناگهانی کانتینر خواهد شد. در سیستمهای بدونوضعیت جاوا، مقدار Request و Limit حافظه باید برابر تنظیم شود تا کیفیت خدمات (QoS Class: Guaranteed) به بالاترین سطح برسد.
معماری شبکه، سرویسها و مسیریابی لایه هفت
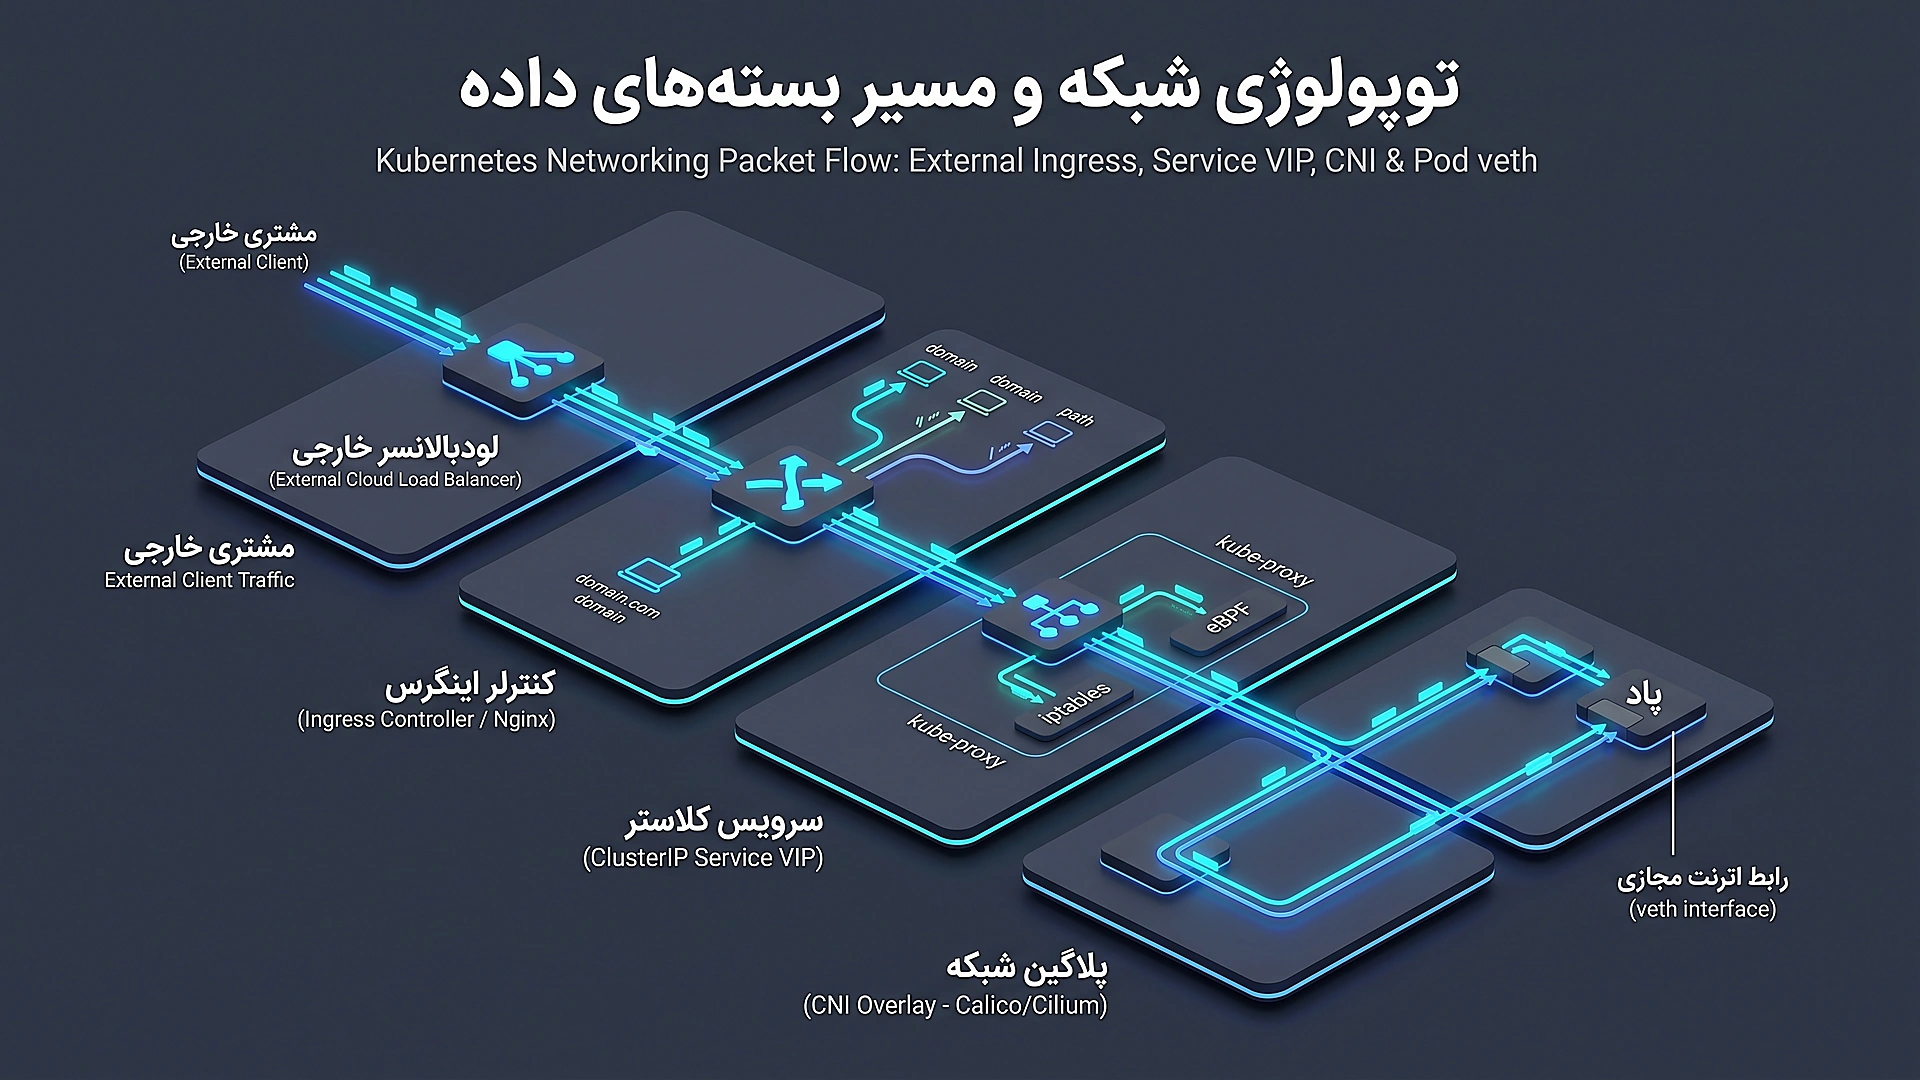
مدل شبکه در کوبرنتیز بر پایه یک فرض ساده اما انقلابی بنا شده است: تمامی پادها میتوانند با تمامی پادهای دیگر در کل کلاستر بدون نیاز به NAT ارتباط برقرار کنند. این مدل بستر یک شبکه مسطح و بدون مرز (Flat Network) را فراهم میآورد:
پلاگینهای رابط شبکه کانتینر (CNI)
کوبرنتیز به خودی خود شبکه فیزیکی را پیادهسازی نمیکند؛ بلکه این وظیفه را به پلاگینهای CNI (Container Network Interface) واگذار مینماید. مقایسه سه پلاگین پیشرو در دنیای کلاسترینگ:
- پلاگین Flannel: سادهترین پلاگین CNI که یک شبکه روکش (Overlay Network با پروتکل VXLAN) ایجاد میکند. سبک و سریع است اما از سیاستهای امنیتی شبکه (NetworkPolicies) پشتیبانی نمیکند.
- پلاگین Calico: استاندارد دیرینه سیستمهای سازمانی که از پروتکل BGP برای مسیریابی مستقیم بستهها بدون کپسولهسازی اضافه استفاده کرده و سیستم امنیتی فوقالعاده قوی بر بستر فایروال لینوکس ارائه میدهد.
- پلاگین مدرن Cilium: ستاره نوین دنیای دواپس که بر پایه فناوری شگفتانگیز eBPF در هسته لینوکس کار میکند. با اجرای بایتکد مستقیم در کرنل، کیوبپروکسی را به طور کامل حذف کرده، سرعت شبکه را به سقف سختافزار رسانده و قابلیتهای نظارتپذیری و کشف تهدیدات لایه ۷ را به ارمغان میآورد.
تمایز انواع سرویسها: ClusterIP ،NodePort و LoadBalancer
برای مدیریت ناپایداری آدرس IP پادها، اشیاء Service به عنوان یک لایه دسترسی پایدار عمل میکنند:
- ClusterIP (پیشفرض): یک آدرس IP مجازی اختصاصی و داخلی به سرویس میدهد که تنها از درون کلاستر قابل مشاهده است. بهترین گزینه برای ارتباط میکروسرویسهای داخلی و دیتابیسها.
- NodePort: یک پورت مشخص (در بازه پیشفرض ۳۰۰۰۰ تا ۳۲۷۶۷) را روی تمام گرههای کلاستر باز میکند. ترافیک ورودی به این پورت از هر گره، به پادهای مقصد فوروارد میشود.
- LoadBalancer: مستقیماً با ارائهدهنده ابری (AWS, GCP, Azure یا MetalLB در زیرساخت شخصی) گفتگو کرده و یک لودبالانسر سختافزاری با آدرس IP عمومی اختصاص میدهد.
مسیریابی هوشمند با Ingress Controller
اگر برای هر یک از دهها میکروسرویس خود یک Service از نوع LoadBalancer ایجاد کنید، هزینه زیرساخت و تعداد IPهای عمومی سر به فلک خواهد کشید. راهکار استاندارد معماری، استفاده از Ingress Controller (مانند NGINX Ingress، Traefik یا Envoy) است.
اینگرس به عنوان یک معکوسپروکسی (Reverse Proxy) در لایه ۷ شبکه عمل میکند. یک IP عمومی منفرد به اینگرس اختصاص مییابد و اینگرس بر اساس دامنه (Host Header) و مسیر URL (Path Routing مثلاً /api/v1/orders) درخواستها را به سرویس داخلی مربوطه هدایت کرده و مدیریت متمرکز گواهینامههای SSL/TLS با ابزارهایی مانند Cert-Manager را به عهده میگیرد.
کنترلرهای مدیریت بار کاری در پروداکشن
هرگز نباید در پروداکشن یک پاد را به تنهایی (Naked Pod) ایجاد کرد؛ زیرا در صورت مرگ پاد، هیچ کنترلی برای زنده کردن آن وجود ندارد. پادها همواره باید تحت نظارت کنترلرهای بار کاری مدیریت شوند:
سرویس های بدونوضعیت با Deployment و استراتژی Rolling Update
شیء Deployment استانداردترین گزینه برای وبسرویسها، فرانتاندها و میکروسرویسهای بدونحالت (Stateless) است که تفکیک لایههای زیرساخت از منطق نرمافزار را مطابق با اصول معماری تمیز (Clean Architecture) پیادهسازی میکند. دپلویمنت از طریق یک شیء میانی به نام ReplicaSet، تضمین میکند که همواره تعداد مشخصی نسخه یکسان از برنامه در حال اجرا باشند.
بزرگترین مزیت دپلویمنت، استراتژی بروزرسانی تدریجی (RollingUpdate) است. با تنظیم پارامترهای maxSurge و maxUnavailable، کوبرنتیز ابتدا پادهای نسخه جدید را بالا میآورد؛ پس از پاس شدن Readiness Probe، ترافیک را به آنها سوئیچ کرده و پادهای نسخه قدیمی را یکییکی خاموش میکند. در صورت بروز هرگونه مشکل، فرمان kubectl rollout undo برنامه را ظرف چند ثانیه به نسخه پایدار پیشین بازمیگرداند.
استقرار پایگاه های داده با StatefulSet و PersistentVolume
دیتابیسها و سیستمهای صف پیام (مانند PostgreSQL، MongoDB، Kafka و Redis) دارای حالت و داده فیزیکی هستند. استفاده از Deployment برای این سیستمها خطر نابودی دادهها را به همراه دارد؛ زیرا پادهای دپلویمنت نامهای تصادفی دارند و به درایوهای مشترک متصل میشوند.
شیء StatefulSet این نیاز حیاتی را با سه ویژگی برطرف میکند:
- هویت ترتیبی پایدار: پادها دارای اسامی مشخص و ترتیبی (از
kafka-0تاkafka-N) هستند و به ترتیب منظم ساخته و خاموش میشوند. - نام دامنه اختصاصی (Headless Service): هر پاد دارای یک رکورد DNS مستقل است که امکان برقراری ارتباط نودهای Leader و Follower را بدون تداخل فراهم میسازد.
- تخصیص دیسک مجزا با volumeClaimTemplates: هر پاد به دیسک فیزیکی ماندگار (PV) خود متصل میشود و در صورت ریاستارت یا جابجایی پاد به گره دیگر، دقیقاً به همان دیسک اختصاصی متصل میگردد.
اجرای عاملهای زیرساختی با DaemonSet
کنترلر DaemonSet تضمین میکند که روی تکتک گرههای کلاستر (یا مجموعهای خاص از نودها با استفاده از nodeSelector)، دقیقاً یک نسخه از پاد اجرا شود. اگر سرور جدیدی به کلاستر ملحق شود، کوبرنتیز به صورت خودکار پاد DaemonSet را روی آن راهاندازی میکند.
کاربردهای اصلی DaemonSet عبارتند از:
- عاملهای جمعآوری لاگ نظیر Fluentbit، Fluentd یا Vector که لاگهای فایل سیستم
/var/log/podsرا میخوانند. - عاملهای پایش سختافزار نظیر Prometheus Node-Exporter یا Datadog Agent.
- پلاگینهای مسیریابی شبکه CNI و درایورهای کارت گرافیک انویدیا (NVIDIA GPU Device Plugin).
الگو های مانیفست YAML سازمانی و امنسازی
در ادامه، نمونههای کاملی از مانیفستهای آماده پروداکشن برای استقرار سرویسهای تجاری و کدهای اتوماسیون مدیریت کلاستر ارائه شده است:
نمونه مانیفست Deployment حرفهای با پروبها و محدودیتها
این مانیفست استاندارد سازمانی تمامی الزامات امنیتی، سقف منابع، پروبهای سهگانه و تنظیمات بدونداونتایم را در بر دارد:
apiVersion: apps/v1
kind: Deployment
metadata:
  name: order-service
  namespace: production
  labels:
    app: order-service
spec:
  replicas: 5
  strategy:
    type: RollingUpdate
    rollingUpdate:
      maxSurge: 1
      maxUnavailable: 0
  selector:
    matchLabels:
      app: order-service
  template:
    metadata:
      labels:
        app: order-service
    spec:
      containers:
      - name: order-api
        image: registry.example.com/order-service:v2.4.1
        ports:
        - containerPort: 8080
        resources:
          requests:
            cpu: "250m"
            memory: "512Mi"
          limits:
            cpu: "1000m"
            memory: "1Gi"
        readinessProbe:
          httpGet:
            path: /health/ready
            port: 8080
          initialDelaySeconds: 5
          periodSeconds: 10
        livenessProbe:
          httpGet:
            path: /health/live
            port: 8080
          initialDelaySeconds: 15
          periodSeconds: 20
نمونه مانیفست StatefulSet کلاستر دیتابیس با دیسک اختصاصی
ساختار استقرار یک کلاستر دیتابیس با سرویس Headless و نگاشت ترتیبی دیسکها:
apiVersion: apps/v1
kind: StatefulSet
metadata:
  name: redis-cluster
  namespace: data
spec:
  serviceName: "redis-headless"
  replicas: 3
  selector:
    matchLabels:
      app: redis
  template:
    metadata:
      labels:
        app: redis
    spec:
      containers:
      - name: redis
        image: redis:7.2-alpine
        ports:
        - containerPort: 6379
          name: redis
        volumeMounts:
        - name: redis-data
          mountPath: /data
  volumeClaimTemplates:
  - metadata:
      name: redis-data
    spec:
      accessModes: [ "ReadWriteOnce" ]
      storageClassName: "fast-nvme-ssd"
      resources:
        requests:
          storage: 50Gi
اسکریپت اتوماسیون پایش و مقیاس پذیری با پایتون
با استفاده از کتابخانه رسمی kubernetes در پایتون، میتوان وضعیت نودها را رصد کرده و پادهای مشکوک را مدیریت نمود:
package main
import (
"context"
"fmt"
"time"
metav1 "k8s.io/apimachinery/pkg/apis/meta/v1"
"k8s.io/client-go/kubernetes"
"k8s.io/client-go/rest"
)
func main() {
config, err := rest.InClusterConfig()
if err != nil {
panic(err.Error())
}
clientset, err := kubernetes.NewForConfig(config)
if err != nil {
panic(err.Error())
}
for {
pods, err := clientset.CoreV1().Pods("production").List(context.TODO(), metav1.ListOptions{})
if err != nil {
panic(err.Error())
}
fmt.Printf("کلاستر فعال: %d پاد در حال اجرا در نیماسپیس پروداکشن\n", len(pods.Items))
time.Sleep(10 * time.Second)
}
}چکلیست خطایابی و پایش کلاستر در پروداکشن
هنگام بروز حوادث زیرساختی (Incidents)، اتخاذ یک رویکرد سیستماتیک و گامبهگام برای ایزولهسازی ریشه خطا حیاتی است:
فرمانهای طلایی kubectl برای عیبیابی سریع
تیمهای SRE در خط مقدم عیبیابی از این توالی استاندارد استفاده میکنند:
# دستورالعمل ترتیبی خطایابی و عیبیابی حوادث کلاستر کوبرنتیز
# ۱. استعلام هشدارهای بحرانی با فیلتر رویدادها
kubectl get events -n production --field-selector type=Warning --sort-by='.metadata.creationTimestamp'
# ۲. مشاهده جزییات وضعیت پاد و دلیل ناتوانی در شروع به کار (CrashLoopBackOff)
kubectl describe pod [POD_NAME] -n production
# ۳. بررسی وضعیت پروبهای سلامت و خطاهای گزارششده از کانتینر
kubectl logs [POD_NAME] -n production --previous
# ۴. بررسی جریان ترافیک اینگرس و تطابق Endpoints با سرویس
kubectl get endpoints order-service -n productionپایش و نظارتپذیری جامع با پرومتئوس و گرافانا
یک کلاستر بدون نظارتپذیری (Observability)، جعبه سیاهی است که در اولین حمله ترافیکی خاموش خواهد شد. مثلث طلایی پایش در کوبرنتیز عبارت است از:
- متریکها (Metrics): گردآوری مصرف منابع با Prometheus و نمایش داشبوردهای گرافیکی در Grafana به همراه پایش خطوط هشدار Alertmanager.
- لاگها (Logs): لاگهای ساختاریافته JSON که توسط Fluentbit از کانتینرها استخراج شده و در Elasticsearch، OpenSearch یا Grafana Loki ایندکس میشوند.
- ردیابی توزیعشده (Distributed Tracing): ردیابی تاخیر درخواستها در عبور از میان دهها پاد با استفاده از استانداردهای OpenTelemetry و Jaeger.
نتیجهگیری و افقهای نوین در اکوسیستم ابری
کوبرنتیز دیگر تنها یک ابزار برای استقرار برنامهها نیست؛ بلکه در یکپارچگی با سیستم کنترل نسخه گیت (Git) در متدولوژی GitOps، استاندارد بینالمللی دیتاسنترها و پلتفرم پایهای ابزارهای مدرن هوش مصنوعی، خطوط لوله دادههای حجیم و شبکههای میکروسرویسی است. تسلط عمیق بر معماری درونی کنترل پلین، مکانیزمهای شبکه و چرخه حیات پادها، به مهندسان دواپس و معماران نرمافزار این قدرت را میدهد که سیستمهایی با پایداری ۹۹.۹۹٪، مقیاسپذیری آنی و کمترین میزان شکست انسانی طراحی و هدایت کنند.
امتیاز و نظرات
هنوز نظری ثبت نشده است. اولین نفر باشید.