
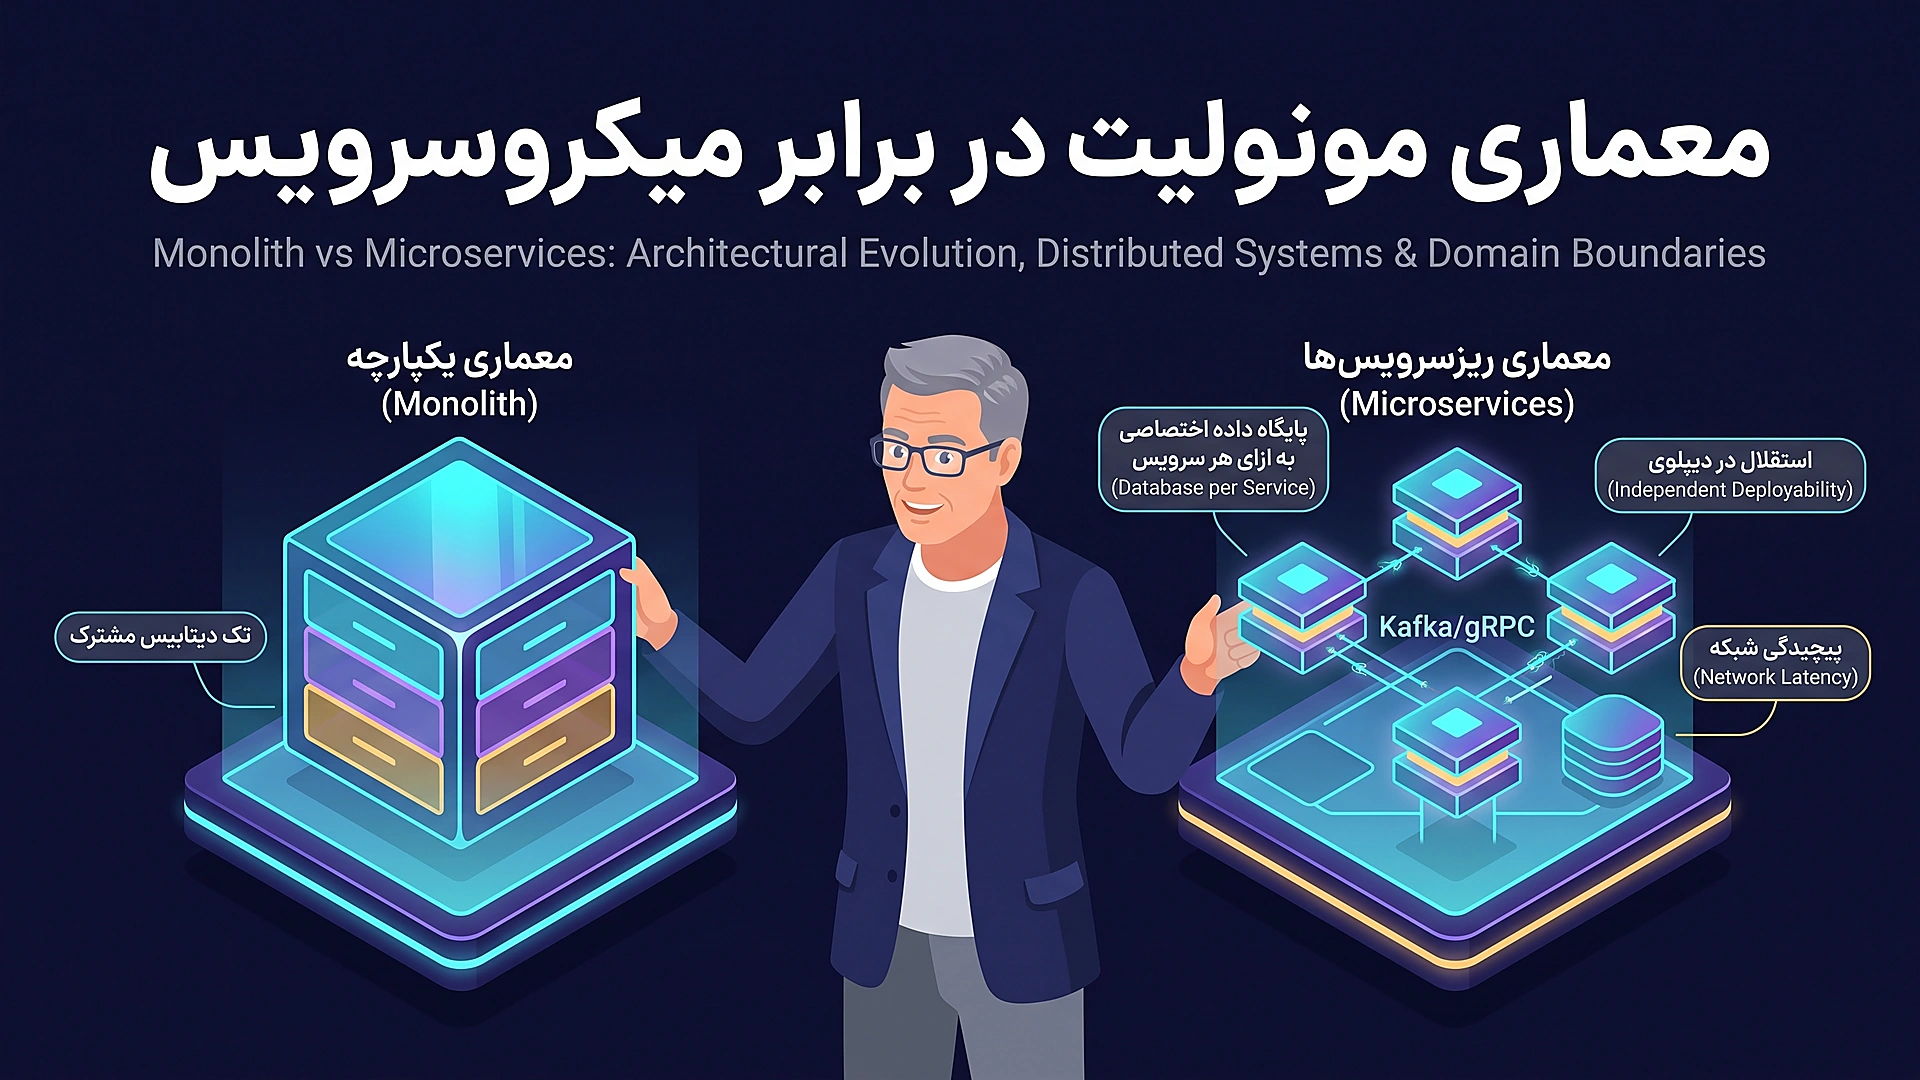
تصمیمگیری پیرامون معماری کلان نرم افزار و رعایت اصول معماری تمیز در سیستم های مقیاس پذیر، یکی از حساسترین و پرهزینهترین گلوگاه های مهندسی در هر سازمان نرم افزاری است. در طول دهه گذشته، معماری میکرو سرویس (Microservices Architecture) به عنوان درمان قطعی تمام چالش های مقیاس پذیری تبلیغ شد؛ اما تجربه صدها شرکت بزرگ فناوری نشان داد که ورود شتابزده به دنیای سیستم های توزیع شده بدون برخورداری از زیرساخت دواپس بالغ و درک عمیق از دامنه های کسبوکار، به جهنمی از تاخیرهای شبکه، پیچیدگی های استقرار و خطاهای آبشاری منتهی میشود. این راهنمای تحلیلی، یک کالبدشکافی بدون تعصب میان معماری مونولیتیک، ماژولار مونولیت و میکرو سرویس هایی توزیع شده است تا به توسعه دهندگان ارشد، معماران سیستم و مدیران فنی چارچوبی مهندسی برای انتخاب، پیاده سازی و در صورت لزوم، استراتژی مهاجرت تدریجی بدون خاموشی ارائه دهد.
سیر تکامل الگو های معماری از آغاز عصر وب
در سال های نخست توسعه نرم افزارهای تجاری و سازمانی، استقرار یک برنامه در قالب یک فایل باینری واحد (مانند یک فایل WAR در جاوا، پکیج داتنت یا اسکریپت های یکپارچه وب) استاندارد بلامنازع صنعت نرم افزار بود. این ساختار که امروزه با عنوان مونولیت (Monolithic Architecture) شناخته میشود، تمامی لایه های رابط کاربری، منطق کسبوکار، دسترسی به داده و فرآیندهای پسزمینه را در قالب یک پایگاه کد منفرد و درون یک پروسه اجرایی (Process) مشترک قرار میداد. سادگی توسعه در چنین سیستمی بینظیر بود؛ زیرا هر فراخوانی متد درون فضای حافظه مشترک (Shared Memory) انجام میپذیرفت، پایگاه داده با تکیه بر ویژگی های تضمینشده تراکنش های اسید (ACID Transactions) یکپارچگی داده ها را تضمین میکرد و نیازی به ارزیابی پروتکل های پیچیده شبکه و مدیریت قطعی ارتباط میان سرور های نبود.
با انفجار وب و رشد چشمگیر تعداد کاربران اینترنتی و مقیاس کسبوکارهای جهانی در اوایل دهه ۲۰۱۰، محدودیت های این مدل به ویژه در مقیاس سازمان های صدها نفره آشکار گشت. زمانی که تعداد مهندسان یک شرکت از چند ده نفر به چند صد نفر افزایش یافت، مشکل اصلی نه عملکرد خام کد، بلکه «تداخل سازمانی در پایگاه کد مشترک» و «طولانی شدن چرخه آزمون و استقرار» بود. یک خطای جزئی در منطق محاسبات فاکتور میتوانست کل پروسه سرور را دچار اختلال کند و فرآیند احراز هویت کاربران را نیز از دسترس خارج سازد. پایپ لاین های استقرار پیوسته ساعتها به طول میانجامید و هماهنگی میان ده ها تیم برای یک انتشار هفتگی، اصطکاک سازمان را به اوج میرساند.
در پاسخ به این گلوگاه های سازمانی و زیرساختی، شرکت های پیشگامی نظیر نتفلیکس و آمازون مفهوم خرد کردن سیستم های غولپیکر به سرویس هایی مستقل را رواج دادند. میکرو سرویس های وعده دادند که هر تیم مستقل بتواند بدون نیاز به هماهنگی با سایر بخش ها، سرویس خود را در زبان برنامه نویسی دلخواه بنویسد، در پایگاه داده مستقل خود ذخیره کند و در هر ساعت از شبانهروز مستقر سازد. با این حال، انتقال این الگو به شرکتهایی که نه ترافیک میلیاردی داشتند و نه ارتش مهندسان زیرساخت، به موجی از پشیمانی و ناکامی انجامید. امروزه در مهندسی نرم افزار مدرن، رویکرد سومی به نام «ماژولار مونولیت» بازتعریف شده است که تلفیقی از استقلال ماژول ها و سادگی عملیاتی مونولیت را در اختیار تیم ها میگذارد.
کالبدشکافی توپولوژی های بنیادین سیستم ها
برای انتخاب آگاهانه معماری، درک دقیق سازوکار داخلی و مرزهای فیزیکی و منطقی هر یک از این سه توپولوژی حیاتی است. این تفاوت ها در نحوه استفاده از منابع پردازشی، مدل مدیریت حافظه و پروتکل های برقراری ارتباط میان ماژول ها ریشه دارد.
ساختار مونولیت سنتی و تک لایه ای
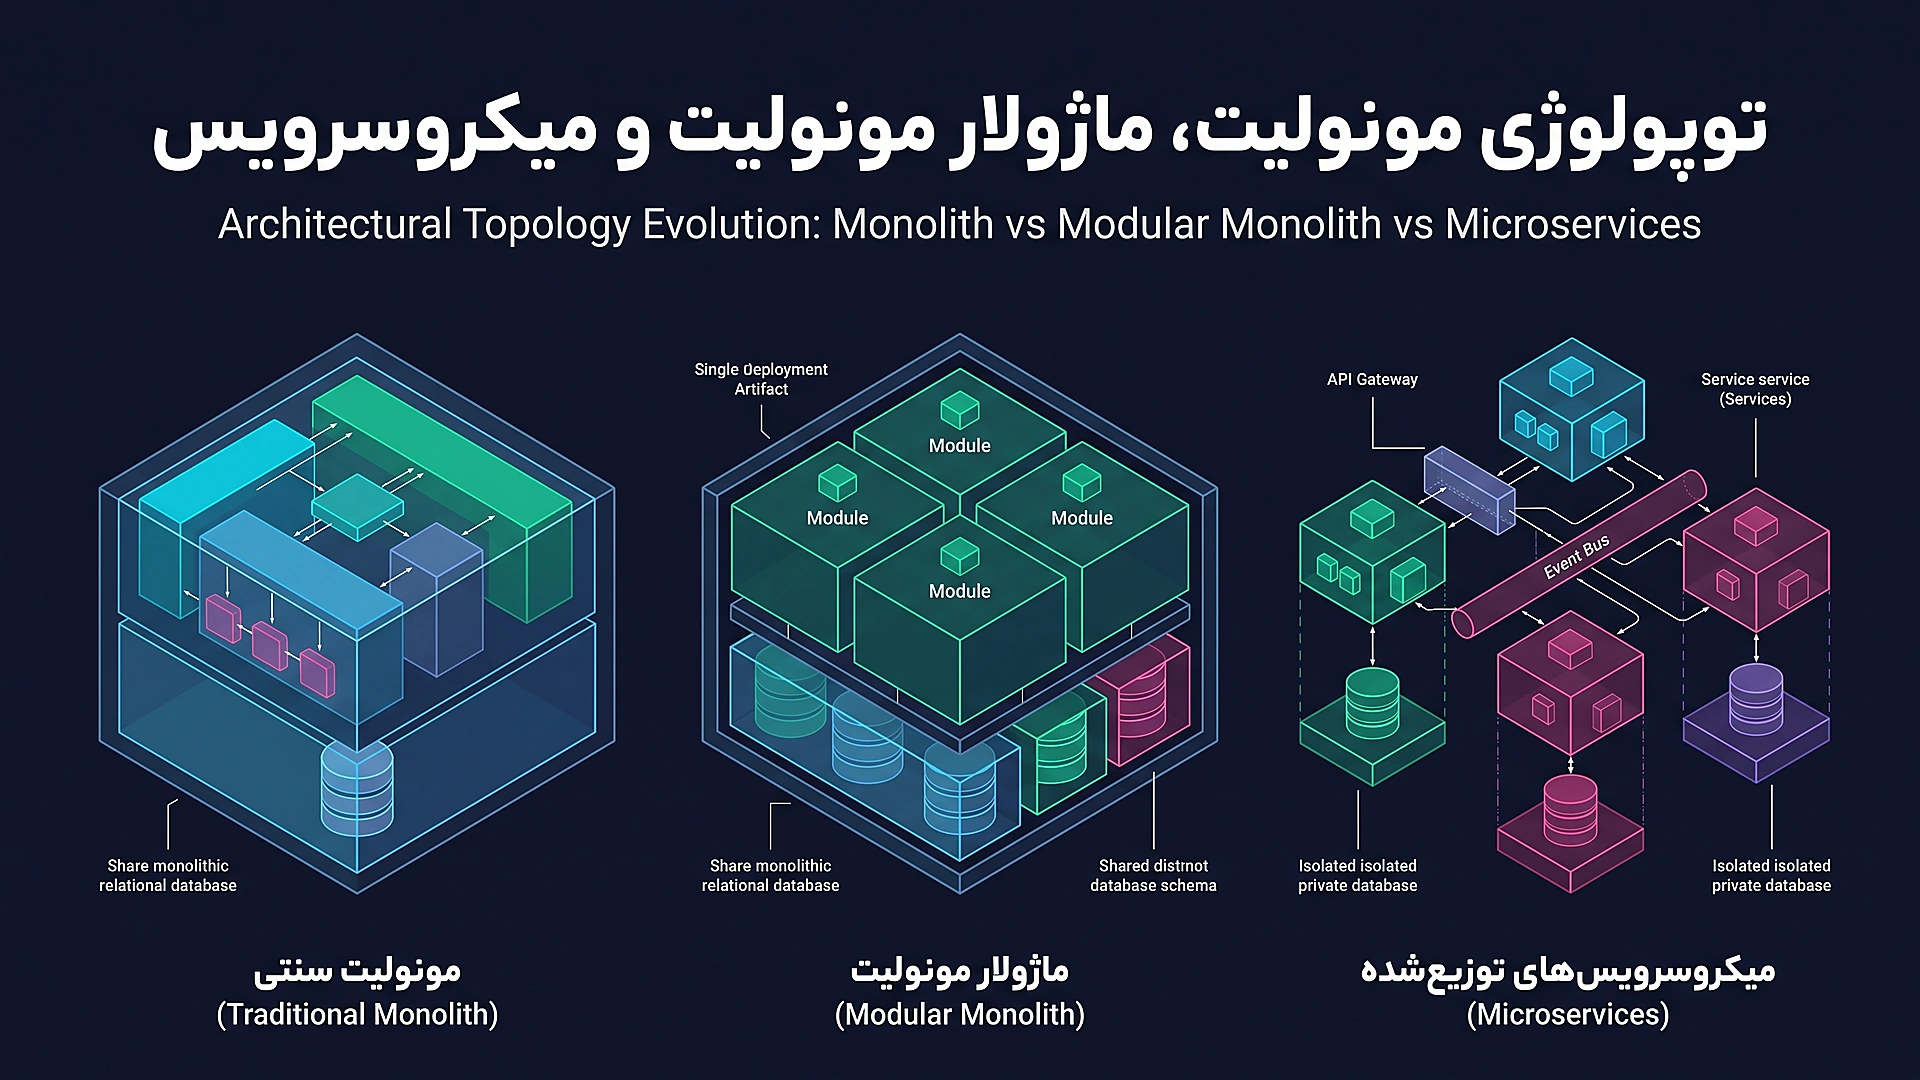
در مونولیت سنتی، تمام لایه های منطقی سیستم (ارائه، منطق بیزینس و دسترسی به داده) در قالب یک واحد استقرار (Deployment Unit) کامپایل یا تفسیر میشوند. اگر از زبان هایی نظیر جاوا، سیشارپ یا گو استفاده شود، خروجی یک فایل باینری منفرد است. در مونولیت سنتی، جداول پایگاه داده معمولا به شکل درهمتنیده طراحی میشوند؛ کلیدهای خارجی (Foreign Keys) میان جداول کاربران، سفارش ها، محصولات و تراکنش های بانکی به راحتی تعریف شده و درخواست های گزارشگیری با کوئری های جوین سنگین (SQL Joins) میان ده ها جدول اجرا میگردد.
نقطه قوت این ساختار در به صفر رساندن سربار شبکه است. هنگامی که کنترلر سفارشات نیاز دارد موجودی انبار را بررسی کند، یک تابع درونحافظهای را در چند نانوثانیه صدا میزند. هیچ سوکت شبکهای باز نمیشود، هیچ دیتایی برای سریالایزیشن به فرمت جیسان یا پروتوباف تبدیل نمیشود و احتمال قطعی ارتباط فیزیکی به دلیل مشکلات سوییچ های شبکه وجود ندارد. اما نقطه ضعف بحرانی این مدل، مستعد بودن به ایجاد «گلوله بزرگ گل و لای» (Big Ball of Mud) است؛ چرا که به دلیل عدم وجود موانع فیزیکی، مهندسان به مرور زمان وابستگی های مخرب و حلقوی (Circular Dependencies) میان بخش های مختلف ایجاد میکنند و هیچ ماژولی قابل بازنویسی یا جداسازی بدون تغییر کل سیستم نخواهد بود.
معماری ماژولار مونولیت: تعادل ایده آل مهندسی
معماری ماژولار مونولیت (Modular Monolith) واکنشی مهندسی به افراط گرایی میکرو سرویس هایست. در این رویکرد، برنامه همچنان به عنوان یک پروسه واحد و درون یک باینری مستقر میشود، اما ساختار درونی کد با دیوارهای نفوذناپذیر ماژولار تفکیک میگردد. هر ماژول دارای یک اینترفیس عمومی (Public API) صریح و منطق درونی کپسولهشده است. دسترسی مستقیم از کنترلر یک ماژول به لایه ریپازیتوری یا دیتابیس ماژول دیگر از طریق قوانین کامپایلر، ابزار های آنالیز استاتیک نظیر ArchUnit یا تنظیمات دسترسی زبان ها (پکیج-پرایوت در جاوا یا ماژول های اینترنال در سیشارپ) کاملاً مسدود میشود.
در سطح پایگاه داده نیز ماژولار مونولیت اصل ایزوله سازی را رعایت میکند. جداول هر ماژول درون یک اسکیمای اختصاصی (Database Schema) نگه داری میشوند و هیچ کلید خارجی فیزیکی میان اسکیمای ماژول سفارش و ماژول کاربران وجود ندارد. ارتباط میان ماژول ها برای تبادل اطلاعات از طریق ارسال رویدادهای درونحافظهای (In-Memory Domain Events) به صورت غیرهمزمان انجام میشود. بدین ترتیب، تیم به تمام مزایای استقلال کدهای میکرو سرویسی دست مییابد؛ بدون آنکه حتی یک دلار هزینه اضافی برای مدیریت کلاستر کوبرنتیز، زیرساخت شبکه یا حل مشکلات ارتباط توزیع شده پرداخت کند.
معماری میکرو سرویس های مستقل و توزیع شده
در این معماری، هر زیردامنه کسبوکار به عنوان یک اپلیکیشن کامپایلشده جداگانه با چرخه حیات، مخزن گیت (Git)، خط لوله استقرار و مهمتر از همه پایگاه داده اختصاصی (Database-per-Service) تعریف میشود. سرویس های از طریق استانداردهای شبکه بر پایه وب سرویس هایی رست (RESTful APIs)، پروتکل فوقالعاده سریع جیآرپیسی (gRPC) و یا ارسال پیام در صف های کافکا و ربیتامکیو با یکدیگر تعامل دارند. هیچ سرویسی مجاز نیست مستقیماً به پایگاه داده سرویس دیگر متصل شود؛ تمامی تعاملات از طریق درگاه های تعریفشده و پایدار قراردادهای نرم افزاری (APIs) به وقوع میپیوندد.
این مدل به تیم های مهندسی آزادی عمل بیسابقهای میبخشد. اگر سرویس پردازش تصویر نیاز به زبان پایتون و شتاب دهنده های هوش مصنوعی داشته باشد، مستقل از سرویس مالی که با جاوا یا گو پیاده سازی شده، توسعه یافته و مستقر میشود. همچنین مقیاس پذیری افقی کاملاً هدفمند است؛ اگر در جشنواره فروش ترافیک بخش جستجوی کالا ۵۰ برابر شود، میتوان فقط پادهای سرویس جستجو را مقیاس کرد، بدون اینکه نیاز به تخصیص رم و پردازنده به کل اپلیکیشن باشد. اما بهای این استقلال، پیچیدگی فزاینده عملیاتی و مواجهه با خطاهای شبکه و پایداری داده است.
تله مرگبار مونولیت توزیع شده
بسیاری از سازمانهایی که ادعای استفاده از میکرو سرویس را دارند، در حقیقت در دام یکی از مخربترین ضدالگو های تاریخ مهندسی نرم افزار به نام «مونولیت توزیع شده» (Distributed Monolith) افتادهاند. مونولیت توزیع شده وضعیتی است که در آن تمام معایب میکرو سرویس های (تأخیر شبکه، هزینه های زیرساخت و قطعی ارتباط) وجود دارد، اما هیچیک از مزایای آن (استقلال ریلیز و مقیاس پذیری) به دست نیامده است.
علائم بارز این فاجعه معماری عبارتند از:
- استقرارهای همگام و زنجیرهای: برای بهروزرسانی سرویس ثبتنام کاربران، باید سرویس ایمیل، سرویس کیف پول و سرویس نوتیفیکیشن نیز همزمان استقرار یابند؛ در غیر این صورت کل سیستم دچار اختلال میشود. این امر به معنای صفر بودن استقلال تیمهاست.
- پایگاه داده مشترک پنهان: سرویس هایی به ظاهر مستقل، همگی به یک دیتابیس واحد متصل شده و مستقیماً روی جداول یکدیگر کوئری میزنند. هر تغییر در ساختار جدول توسط یک تیم، بیلدهای سایر تیم ها را با شکست مواجه میکند.
- فراخوانی های همگام تو در تو (HTTP Cascading Calls): پردازش یک درخواست ساده کاربر مستلزم عبور همگام از ۶ لایه سرویس مختلف از طریق HTTP است. با وقوع کندی یا کرش در پایینترین سرویس، تمام فراخوانی ها در بالادست تایماوت داده و کل پلتفرم زمینگیر میشود.
طراحی دامنه محور و تعیین مرزهای سیاق
بزرگترین خطایی که تیم ها در تقسیم سیستم به میکرو سرویس های مرتکب میشوند، تقسیم بندی بر اساس موجودیت های دادهای خام (CRUD Services) است؛ برای مثال ساختن یک سرویس کاربران، یک سرویس محصولات و یک سرویس فاکتورها. این مدل تفکیک، تضمینکننده ایجاد یک مونولیت توزیع شده پر از وابستگی های متقابل است. تنها روش اصولی برای خرد کردن یک سیستم، تکیه بر اصول طراحی دامنه محور (Domain-Driven Design - DDD) و تفکیک بر اساس مرزهای سیاق (Bounded Contexts) است.
در متدولوژی طراحی دامنه محور، یک موجودیت واقعی در دنیای واقعی ممکن است در سیاق های مختلف تعاریف و نیازمندی های دادهای کاملاً متفاوتی داشته باشد. برای مثال، کانسپت «کالا» در سیاق انبارداری دارای ویژگی هایی نظیر وزن، ابعاد، قفسه نگه داری و بارکد فیزیکی است. اما همین «کالا» در سیاق فروشگاه و بازاریابی شامل عنوان سئو، تصاویر تبلیغاتی، تخفیف فصلی و نظرات خریداران است. در یک معماری نادرست، سعی میشود یک مدل غولپیکر با ۵۰ فیلد ساخته شود و تمام سرویس های به آن متصل گردند. اما در طراحی بر اساس مرزهای سیاق، هر سرویس مدل مفهومی اختصاصی خود را از آن موجودیت ذخیره میکند و همگام سازی اطلاعات در صورت لزوم از طریق رخدادهای دامنهای نظیر «تغییر قیمت کالا» رخ میدهد.
module com.ecommerce.order {
    requires com.ecommerce.shared.kernel;

    exports com.ecommerce.order.api;
    exports com.ecommerce.order.dto;

    opens com.ecommerce.order.internal to org.hibernate.orm.core;
}
بحران پایداری داده: از تراکنش های ACID به BASE
در سیستم های مونولیتیک، تضمین سازگاری داده ها مسئولیتی است که بر دوش موتور پایگاه داده رابطه ای قرار دارد. با استفاده از دستورات استاندارد تراکنش (مانند BEGIN TRANSACTION و COMMIT)، اگر در هنگام ثبت سفارش، درج فاکتور با خطا مواجه شود یا کسر وجه از حساب انجام نپذیرد، کل تراکنش به وضعیت پیشین بازگردانده شده (Rollback) و هرگز دیتای ناقص در سیستم ذخیره نخواهد شد.
اما در معماری میکرو سرویس با الگوی Database-per-service، داده های مربوط به یک فرآیند تجاری در چندین پایگاه داده فیزیکی مجزا (برای مثال PostgreSQL برای سفارش ها، MongoDB برای کاتالوگ و Redis برای سشن ها) ذخیره میشوند. طبق قضیه کپ (CAP Theorem)، در یک سیستم توزیع شده به دلیل ناپایداری های ذاتی بستر شبکه (Network Partition)، شما نمیتوانید به صورت همزمان سازگاری قطعی آنی (Consistency) و دسترسی پذیری مداوم (Availability) را در بالاترین سطح داشته باشید.
استفاده از پروتکل های قدیمی سازگاری قوی نظیر پروتکل کامیت دوفازی (Two-Phase Commit - ۲PC) در میکرو سرویس هایی مدرن به شدت منع میشود؛ زیرا نیازمند قفل کردن طولانیمدت رکوردها در چندین پایگاه داده از طریق شبکه است و در صورت کندی یک سرور، کل زیرساخت دچار بنبست (Deadlock) و سقوط عملکردی میشود. بنابراین، معماری سیستم های توزیع شده ناچار به پذیرش مدل «سازگاری نهایی» (Eventual Consistency) و مفاهیم مدل BASE (مخفف Basically Available, Soft state, Eventual consistency) است؛ بدین معنا که داده ها ممکن است برای چند ثانیه در سرویس هایی مختلف ناهماهنگ باشند، اما به مرور زمان و با انتشار رویدادها، تمام بخش های سیستم به یک وضعیت پایدار و متوازن همگرا خواهند شد.
حل مشکل نوشتن دوگانه با الگوی Transactional Outbox
یکی از شایعترین خطاهای مهندسی در میکرو سرویس های، مشکل نوشتن دوگانه (Dual-Write Problem) است. فرض کنید کدی مینویسید که ابتدا رکورد سفارش را در پایگاه داده ذخیره میکند و در خط بعدی پیامی را به بروکر کافکا میفرستد تا سرویس انبار آن را پردازش کند. چه رخ میدهد اگر بعد از ذخیره در دیتابیس، ارتباط با کافکا قطع شود؟ سفارش ذخیره شده اما انبار هرگز از آن مطلع نخواهد شد! برعکس، اگر اول پیام به کافکا ارسال شود و هنگام ذخیره در دیتابیس خطای دیسک رخ دهد، انبار کالایی را کسر میکند که اصلاً سفارشی برای آن ثبت نشده است!
راهکار استاندارد و مطمئن برای حل این تناقض، استفاده از الگوی Transactional Outbox است. در این الگو، به همراه جدول سفارشات، یک جدول دیگر به نام `outbox_events` در همان پایگاه داده تعبیه میشود. ثبت سفارش و درج رخداد در جدول اوتباکس درون یک تراکنش واحد محلی ACID انجام میپذیرد. سپس یک ابزار ردیابی لاگ تراکنش ها نظیر دبیزیوم (Debezium Change Data Capture) یا یک پروسه پسزمینه مطمئن، رکوردهای جدید اوتباکس را خوانده و با تضمین تحویل حداقل یکبار (At-least-once delivery) به بروکر کافکا تزریق میکند.
package com.example.orders.outbox;

import jakarta.persistence.*;
import java.time.Instant;
import java.util.UUID;

@Entity
@Table(name = "outbox_events")
public class OutboxEvent {

    @Id
    private UUID id;

    @Column(nullable = false)
    private String aggregateType;

    @Column(nullable = false)
    private String aggregateId;

    @Column(nullable = false)
    private String eventType;

    @Lob
    @Column(nullable = false)
    private String payload;

    @Column(nullable = false)
    private Instant createdAt;

    @Enumerated(EnumType.STRING)
    @Column(nullable = false)
    private EventStatus status;
}
الگوی تراکنش های توزیع شده ساگا
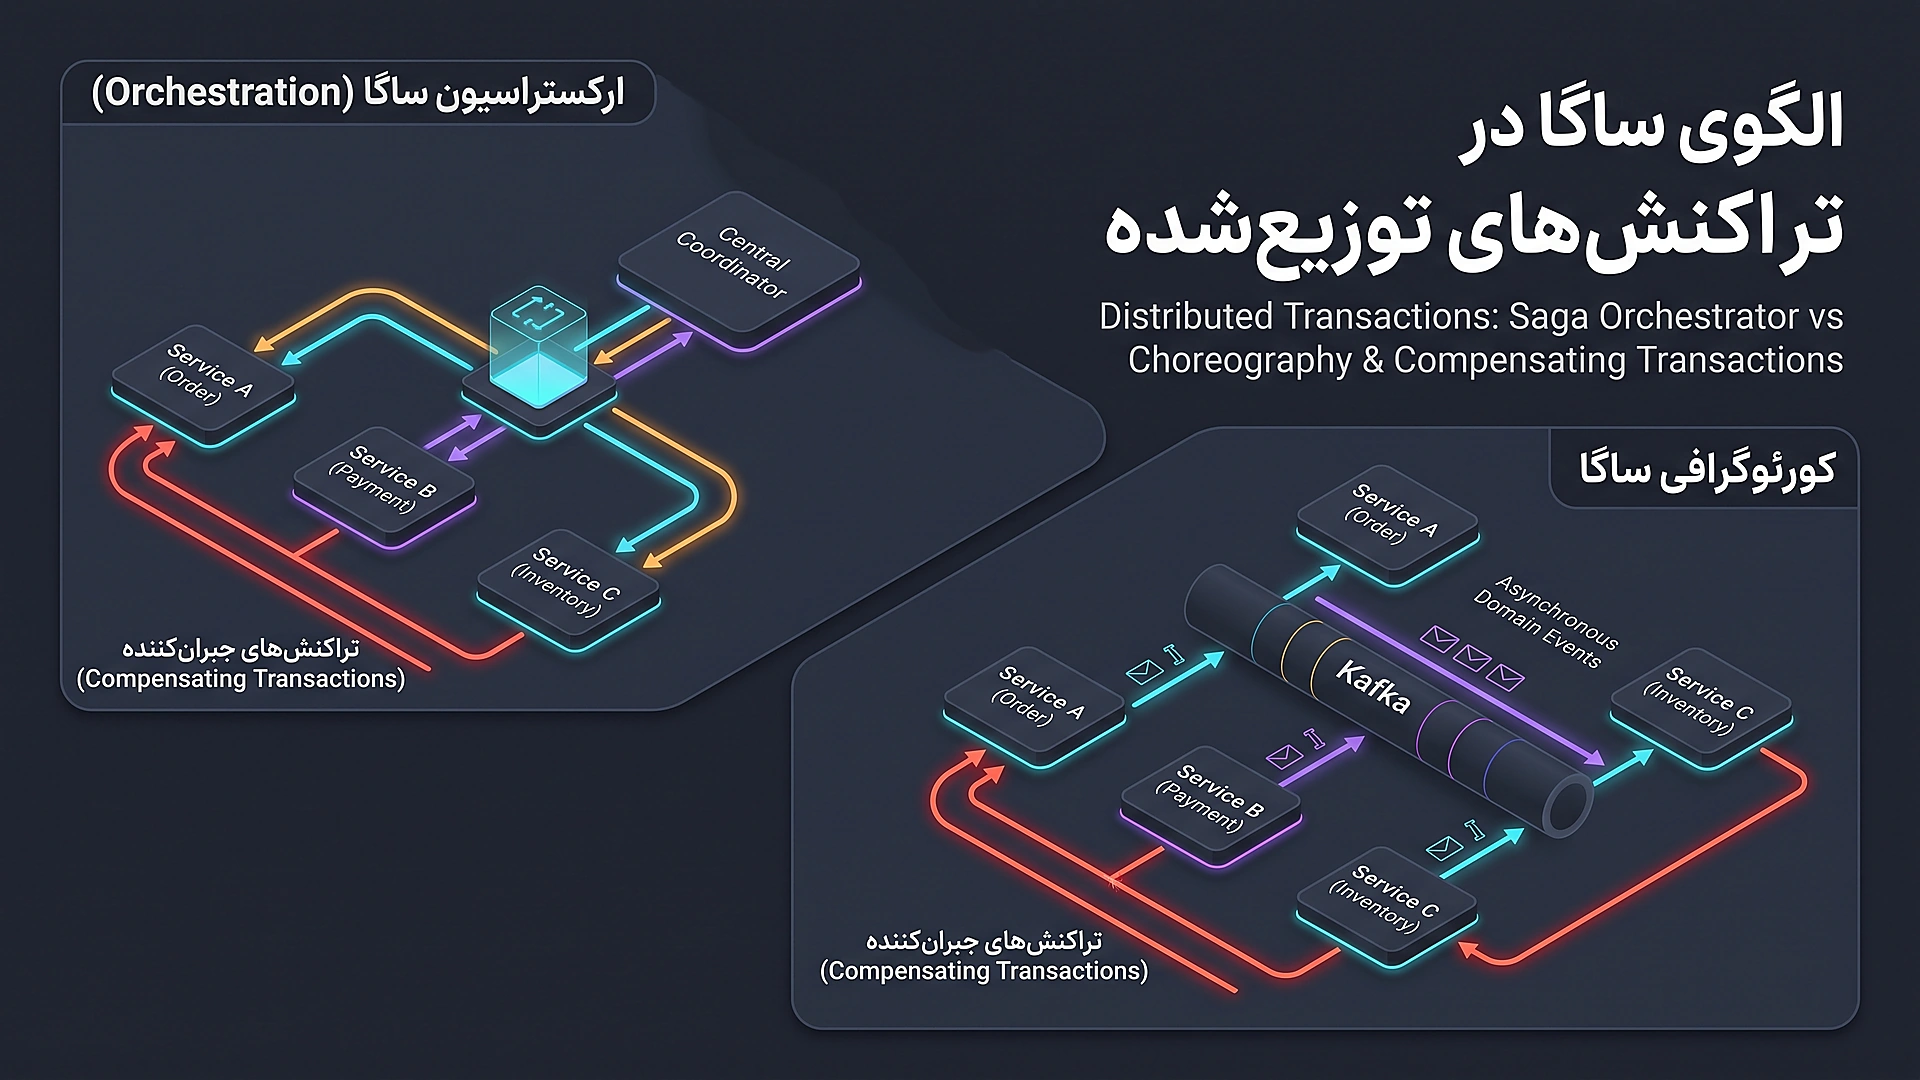
هنگامی که یک فرآیند کسبوکار چندین سرویس را درگیر میکند و امکان رولبک دیتابیسی به روش سنتی وجود ندارد، الگوی ساگا (Saga Pattern) تنها راه نجات است. ساگا مجموعهای از تراکنش های محلی مستقل است که در آن هر تراکنش داده های یک سرویس را بهروزرسانی کرده و رخدادی را برای آغاز گام بعدی تولید میکند. در صورتی که یکی از مراحل با خطا مواجه شود (برای مثال موجودی حساب کاربر کافی نباشد)، ساگا زنجیرهای از تراکنش های جبرانی (Compensating Transactions) را به ترتیب معکوس اجرا میکند تا تغییرات مراحل قبلی را خنثی سازد.
کوریوگرافی در برابر ارکستراسیون
پیاده سازی الگوی ساگا به دو شیوه بنیادین انجام میگیرد:
۱. کوریوگرافی (Choreography): در این مدل هیچ هماهنگکننده مرکزی وجود ندارد. هر سرویس پس از اتمام کار خود، یک رویداد روی کافکا منتشر میکند و سرویس هایی دیگر که مشترک آن رویداد هستند، به محض دریافت، کار خود را شروع میکنند. اگر پرداخت رد شود، سرویس پرداخت رویداد خطای پرداخت را اعلام کرده و سرویس انبار با شنیدن این پیام، کالای رزرو شده را آزاد میکند. این رویکرد برای فرآیندهای بسیار ساده با ۲ تا ۳ سرویس عالی است؛ اما با افزایش تعداد گام ها، به جهنمی از رویدادها (Event Spaghetti) تبدیل میشود که فهم مسیر کلی بیزینس در آن غیرممکن خواهد بود.
۲. ارکستراسیون (Orchestration): در این رویکرد یک ماژول هماهنگکننده مرکزی (Orchestrator) به عنوان یک ماشین وضعیت (State Machine) مسئولیت هدایت گام ها را بر عهده دارد. ارکستراتور به سرویس انبار دستور رزرو کالا را صادر میکند، پاسخ را میشنود، سپس دستور تراکنش بانکی را ارسال مینماید. در صورت دریافت خطای بانکی، ارکستراتور مستقیماً فرمان جبرانی لغو انبار را صادر میکند. مزیت بزرگ این روش، تمرکز شفاف لاجیک بیزینس، مانیتورینگ دقیق وضعیت سفارش و تست پذیری بسیار سادهتر است. ابزار هایی نظیر Temporal، Camunda و یا ساخت ماشین وضعیت داخلی در کد بهترین گزینه ها برای ارکستراسیون هستند.
package com.example.saga.order;
import org.springframework.stereotype.Component;
@Component
public class OrderSagaOrchestrator {
public void executeOrderSaga(OrderContext ctx) {
try {
inventoryService.reserveStock(ctx.getOrderId(), ctx.getItems());
paymentService.deductBalance(ctx.getUserId(), ctx.getTotalAmount());
deliveryService.scheduleDelivery(ctx.getOrderId(), ctx.getAddress());
orderService.markAsApproved(ctx.getOrderId());
} catch (PaymentFailedException ex) {
inventoryService.releaseStock(ctx.getOrderId(), ctx.getItems());
orderService.markAsFailed(ctx.getOrderId(), "تراکنش پرداخت ناموفق بود.");
} catch (Exception ex) {
paymentService.refund(ctx.getUserId(), ctx.getTotalAmount());
inventoryService.releaseStock(ctx.getOrderId(), ctx.getItems());
orderService.markAsFailed(ctx.getOrderId(), "خطای پیشبینینشده در زنجیره ساگا.");
}
}
}تفکیک مسئولیت دستور و پرس وجو با الگوی CQRS
در سیستم های توزیع شده با پایگاه های داده اختصاصی، یکی از بزرگترین چالش ها نحوه تولید گزارش ها و اجرای کوئری های ترکیبی است. در یک مونولیت سنتی، شما به سادگی یک دستور `JOIN` میان چهار جدول کاربران، سفارش ها، محصولات و تراکنش ها میزنید و نتیجه را در چند میلیثانیه دریافت میکنید. اما در میکرو سرویس های، هر یک از این جداول در یک پایگاه داده مستقل و روی سرور هایی جداگانه قرار دارند. اجرای فراخوانی های شبکهای مکرر (API Composition) و ترکیب دیتا در حافظه برای هزاران ردیف، عملکرد سیستم را نابود میکند.
الگوی CQRS (تفکیک مسئولیت دستور و پرسوجو - Command Query Responsibility Segregation) با تفکیک کامل مدل نوشتن داده (Command) از مدل خواندن داده (Query) این معضل را حل میکند:
- مدل دستور (Command Model): منحصراً بر روی اعتبارسنجی قوانین کسبوکار، قوانین اسید و ذخیره ایمن تغییرات تمرکز دارد (برای مثال دیتابیس رابطهای PostgreSQL با نرمال سازی بالا).
- مدل خواندن (Read Model): دیتابیسی دنورمالایز شده (Denormalized) که منحصراً برای کوئری های سریع فرانت اند بهینه سازی شده است (مانند Elasticsearch برای جستجوی متنی یا Redis برای لود سریع فید کاربر).
- همگام سازی از طریق رویدادها: با هر تغییری در مدل نوشتن، یک رویداد دامنهای منتشر شده و پروجکشن های مدل خواندن (Projections) به شکل ناهمگام و بدون ایجاد قفل بهروزرسانی میشوند.
ایونت سورسینگ: حقیقت به عنوان جریان رخدادهای تغییرناپذیر
در رویکرد سنتی ذخیره داده (CRUD)، شما تنها وضعیت فعلی موجودیت را ذخیره میکنید. هنگامی که کاربر آدرس خود را تغییر میدهد، آدرس قدیمی با مقدار جدید بازنویسی میشود و پیشینه تاریخی آن برای همیشه از دست میرود مگر اینکه جداول لاگ جداگانهای طراحی شده باشد. در سیستم های مالی، حسابداری، رهگیری زنجیره تأمین و سیستم های فوقحساس، این رویکرد پاسخگوی نیازمندی های قانونی و حسابرسی نیست.
الگوی ایونت سورسینگ (Event Sourcing) مفهوم ذخیره سازی وضعیت را متحول میسازد. به جای ذخیره وضعیت فعلی حساب، تاریخچهای منظم و تغییرناپذیر (Append-Only Event Store) از تمام رخدادهایی که برای آن حساب رخ داده ذخیره میشود: `AccountCreated`، `MoneyDeposited(۵۰۰$)`، `MoneyWithdrawn(۱۲۰$)`. وضعیت فعلی در حقیقت حاصل جمع و پخش مجدد (Replay) این رخدادها از ابتدا تا زمان حال است.
ترکیب Event Sourcing با CQRS قویترین پترن برای ساخت سیستم های فوقالعاده پایدار توزیع شده است؛ چرا که لاگ رخدادها هرگز دستکاری نمیشود، خطای انسانی در باگ های نرم افزاری با بازسازی وضعیت ها در هر نقطه از زمان (Time-travel Debugging) قابل جبران است و پروجکشن های تحلیلی و گزارشگیری جدید میتوانند از همان روز اول کل رخدادهای گذشته را از نو پردازش کنند.
لایه ضدفساد یا Anti-Corruption Layer در فرآیند مهاجرت
هنگامی که تصمیم میگیرید یک سرویس جدید را از دل یک سیستم مونولیتیک موروثی و قدیمی (Legacy System) استخراج کنید، با ساختار دادهای آشفته و مدل های مفهومی نامناسب مواجه خواهید شد که طی سال ها انباشت بدهی فنی شکل گرفته است. اگر میکرو سرویس جدید شما همان ساختارهای کثیف، اسامی غیراستاندارد و لاجیک های نامنظم مونولیت را در اینترفیس های خود کپی کند، سرویس جدید قبل از تولد فاسد شده است!
برای جلوگیری از سرایت این آشفتگی، الگوی لایه ضدفساد (Anti-Corruption Layer - ACL) به عنوان یک واسط مترجم عمل میکند. این لایه در مرز میان سیستم جدید و سیستم قدیمی قرار گرفته و داده های ناهنجار و قدیمی مونولیت را دریافت میکند، آنها را اعتبارسنجی کرده و به زبان پاکیزه، مدل های دامنه تمیز و پروتکل های مدرن میکرو سرویس ترجمه مینماید. بدین ترتیب دامنه سرویس جدید پاک و مستقل باقی مانده و در آینده پس از حذف کامل مونولیت، کافیست فقط این لایه آداپتور برداشته شود بدون آنکه هسته میکرو سرویس دستخوش تغییر گردد.
تست قراردادها و تضمین پایداری ارتباطات میان سرویسی
یکی از بزرگترین کابوس های تیم های میکرو سرویس، تغییر ناخواسته در اینترفیس یک سرویس است که باعث شکست و پرتاب خطاهای پیشبینینشده در سایر سرویس هایی مصرفکننده میشود. در پروژه هایی مونولیتیک، سیستم تایپ و کامپایلر بلافاصله ناسازگاری متدها را به توسعه دهنده گزارش میدهد. اما در میکرو سرویس، اگر سرویس کاربران نام یک فیلد جیسان را از `user_name` به `username` تغییر دهد، تا زمان استقرار در محیط تست یا پروداکشن، هیچ اخطاری دریافت نخواهد شد.
اجرای تست های سرتاسری سنتی (End-to-End Testing) در میکرو سرویس های بسیار گران، کند و به شدت ناپایدار (Flaky) است؛ زیرا مستلزم بالا آوردن همزمان ۳۰ کانتینر، دیتابیس ها و بروکرهای پیام در محیط پایپ لاین CI است. راهکار مدرن این چالش، استفاده از «تست قراردادهای مشتری محور» (Consumer-Driven Contract Testing) با ابزار هایی نظیر Pact است:
- تولید فایل قرارداد: سرویس مصرفکننده (Consumer) نیازمندی های دقیق خود از پاسخ سرویس تولیدکننده (Provider) را در قالب یک فایل قرارداد (Contract JSON) ثبت میکند.
- تست مستقل بدون نیاز به شبکه: در خط لوله CI سرویس تولیدکننده، این قراردادها در برابر متدهای کنترلر تست میشوند. اگر تغییری در فیلدها ایجاد شود که قرارداد مشتری را نقض کند، بیلد بلافاصله Fail شده و مانع از استقرار کد معیوب میشود.
تاب آوری شبکه و الگو های مدیریت شکست
در سیستم های توزیع شده، شبکه ذاتاً غیرقابل اعتماد است (Unreliable Network). بسته داده ممکن است در سوئیچ های شبکه گم شود، سرویس مقصد دچار مصرف شدید سیپییو شده و به کندی پاسخ دهد، یا به دلیل قطعی موقت در دسترس نباشد. اگر سرویس هایی بالادست به صورت کورکورانه به ارسال درخواست های مکرر ادامه دهند، پدیدهای خطرناک به نام خطای آبشاری (Cascading Failure) رخ میدهد که طی آن خرابی یک میکرو سرویس کوچک، تمام سرویس هایی زنجیره را یکی پس از دیگری ساقط میکند.
الگوی کلید قطع جریان یا Circuit Breaker
الگوی کلید قطع جریان برگرفته از کلیدهای مینیاتوری برق ساختمان است. مدار شکن در سه وضعیت کار میکند:
- وضعیت بسته (Closed): در حالت عادی، تمام درخواست ها مستقیماً به سرویس مقصد ارسال میشوند. مدار شکن نرخ خطاهای رخ داده یا زمان پاسخگویی را رصد میکند.
- وضعیت باز (Open): چنانچه درصد خطاهای سرویس مقصد از یک آستانه مشخص (مثلا ۵۰ درصد) فراتر رود، کلید باز میشود. در این حالت، هیچ درخواستی به شبکه ارسال نشده و بلافاصله استثنای خطا یا پاسخ پیشفرض (Fallback) به کاربر داده میشود تا از اشباع تردها و نابودی سیستم مقصد جلوگیری به عمل آید.
- وضعیت نیمهباز (Half-Open): پس از گذشت یک بازه خنک سازی مشخص (مثلا ۳۰ ثانیه)، کلید تعداد محدودی درخواست آزمایشی را عبور میدهد. اگر درخواست ها موفق باشند، مدار دوباره به حالت بسته بازمیگردد؛ در غیر این صورت به حالت باز بازگردانده میشود.
package com.example.orders.circuit;

import io.github.resilience4j.circuitbreaker.annotation.CircuitBreaker;
import io.github.resilience4j.retry.annotation.Retry;
import org.springframework.stereotype.Service;
import org.springframework.web.client.RestTemplate;

@Service
public class PaymentClient {

    private final RestTemplate restTemplate;

    public PaymentClient(RestTemplate restTemplate) {
        this.restTemplate = restTemplate;
    }

    @CircuitBreaker(name = "paymentService", fallbackMethod = "paymentFallback")
    @Retry(name = "paymentService")
    public PaymentResponse processPayment(PaymentRequest request) {
        return restTemplate.postForObject("https://payment-service/api/v1/charge", request, PaymentResponse.class);
    }

    public PaymentResponse paymentFallback(PaymentRequest request, Throwable t) {
        return new PaymentResponse("PENDING_OFFLINE", "سرویس پرداخت موقتاً در دسترس نیست؛ تراکنش در صف اعتبارسنجی قرار گرفت.");
    }
}
الگوی بالک هد و ایزولاسیون منابع در سطح تردها و کانتینر ها
الگوی بالکهد (Bulkhead Pattern) نام خود را از دیواره های نفوذناپذیر کشتی های اقیانوسپیما وام گرفته است. در طراحی کشتی، اگر بخشی از بدنه دچار شکستگی و نفوذ آب شود، دیواره های بالکهد مانع از سرایت آب به سایر محفظه ها شده و کشتی همچنان شناور میماند. در معماری نرم افزارهای توزیع شده، بالکهد به معنای دسته بندی و ایزوله کردن استخرهای منابع پردازشی (Thread Pools، اتصالات دیتابیس و حافظه) است به گونهای که انفجار مصرف منابع در یک بخش، منجر به خفگی کل سیستم نشود.
تصور کنید سرویس سفارشات از یک استخر ترد مشترک با ۲۰۰ ترد برای پاسخگویی به درخواست ها استفاده کند. اگر درگاه پرداخت اینترنتی به مدت ۳۰ ثانیه کند شود، تمام ۲۰۰ ترد برای انتظار پاسخ درگاه معلق میمانند. در این شرایط، حتی یک کاربر که قصد دارد صفحه اول فروشگاه یا سبد خرید را مشاهده کند با خطای عدم پاسخگویی مواجه میشود! با پیاده سازی الگوی بالکهد، معمار سیستم منابع را تفکیک میکند: ۵۰ ترد اختصاصی برای درگاه پرداخت، ۵۰ ترد برای جستجو و ۱۰۰ ترد برای عملیات حیاتی دیگر. در صورت اختلال درگاه پرداخت، حداکثر ۵۰ ترد اشباع میشوند و سایر ۹۰ درصد کاربران پلتفرم به فعالیت عادی خود بدون احساس کوچکترین افت سرعتی ادامه خواهند داد.
الگوی شناسه همبستگی یا Correlation ID در ردیابی خطاها
در سیستم های مونولیت، هنگام وقوع خطا، ردپای پشته (Stack Trace) تمام مسیر اجرای متدها را از کنترلر وب تا لایه دیتابیس به صورت پیوسته در یک فایل متنی نشان میدهد. اما در معماری میکرو سرویس، یک تراکنش کاربر در میان ۵ سرور مختلف و از طریق ترکیب فراخوانی های HTTP، صف های کافکا و سوکت های شبکه تقسیم میشود. اگر پرداخت کاربر ناموفق شود، مهندسان پشتیبانی چگونه میتوانند لاگ های مربوط به آن خطای خاص را در میان میلیون ها خط لاگ روزانه پیدا کنند؟
الگوی شناسه همبستگی (Correlation ID Pattern) استاندارد طلایی پایش در دنیای توزیع شده است. جریان کار به صورت زیر پیاده سازی میشود:
- تولید شناسه در لبه شبکه: به محض ورود درخواست به درگاه API Gateway، یک شناسه یکتای تصادفی (مانند یک UUID) به عنوان هدر `X-Correlation-ID` ایجاد میگردد.
- تزریق به بستر لاگینگ (MDC Context): فریم ورک در لایه اینترسپتور، این شناسه را در کانتکست لاگر تزریق میکند تا در ابتدای تمام سطرهای لاگ درج شود.
- انتشار در تماس های بعدی و صف ها: هنگامی که سرویس قصد ارسال درخواست به سرویس دیگر یا انتشار پیام روی کافکا دارد، این هدر را به صورت خودکار به هدرهای شبکه الحاق میکند.
- تجمیع و جستجو در کسری از ثانیه: مهندس پشتیبانی کافیست شناسه خطای کاربر را در سیستم Kibana یا Grafana جستجو کند تا تمام سطرهای لاگ تولید شده در سراسر کلاستر از لحظه کلیک کاربر تا خطای نهایی را به صورت یک تایم لاین منظم و یکپارچه مشاهده نماید.
پشته ارتباطات، امنیت و پایش توزیع شده
یک معماری میکرو سرویس تولیدی، علاوه بر منطق کد نویسی، متکی بر یک اکوسیستم استاندارد زیرساختی برای محافظت از جریان ترافیک و نظارت بر سلامت سیستم هاست. بدون این لایه ها، مدیریت ده ها سرویس در پروداکشن به یک کابوس غیرقابل کنترل تبدیل خواهد شد.
درگاه یکپارچه یا API Gateway
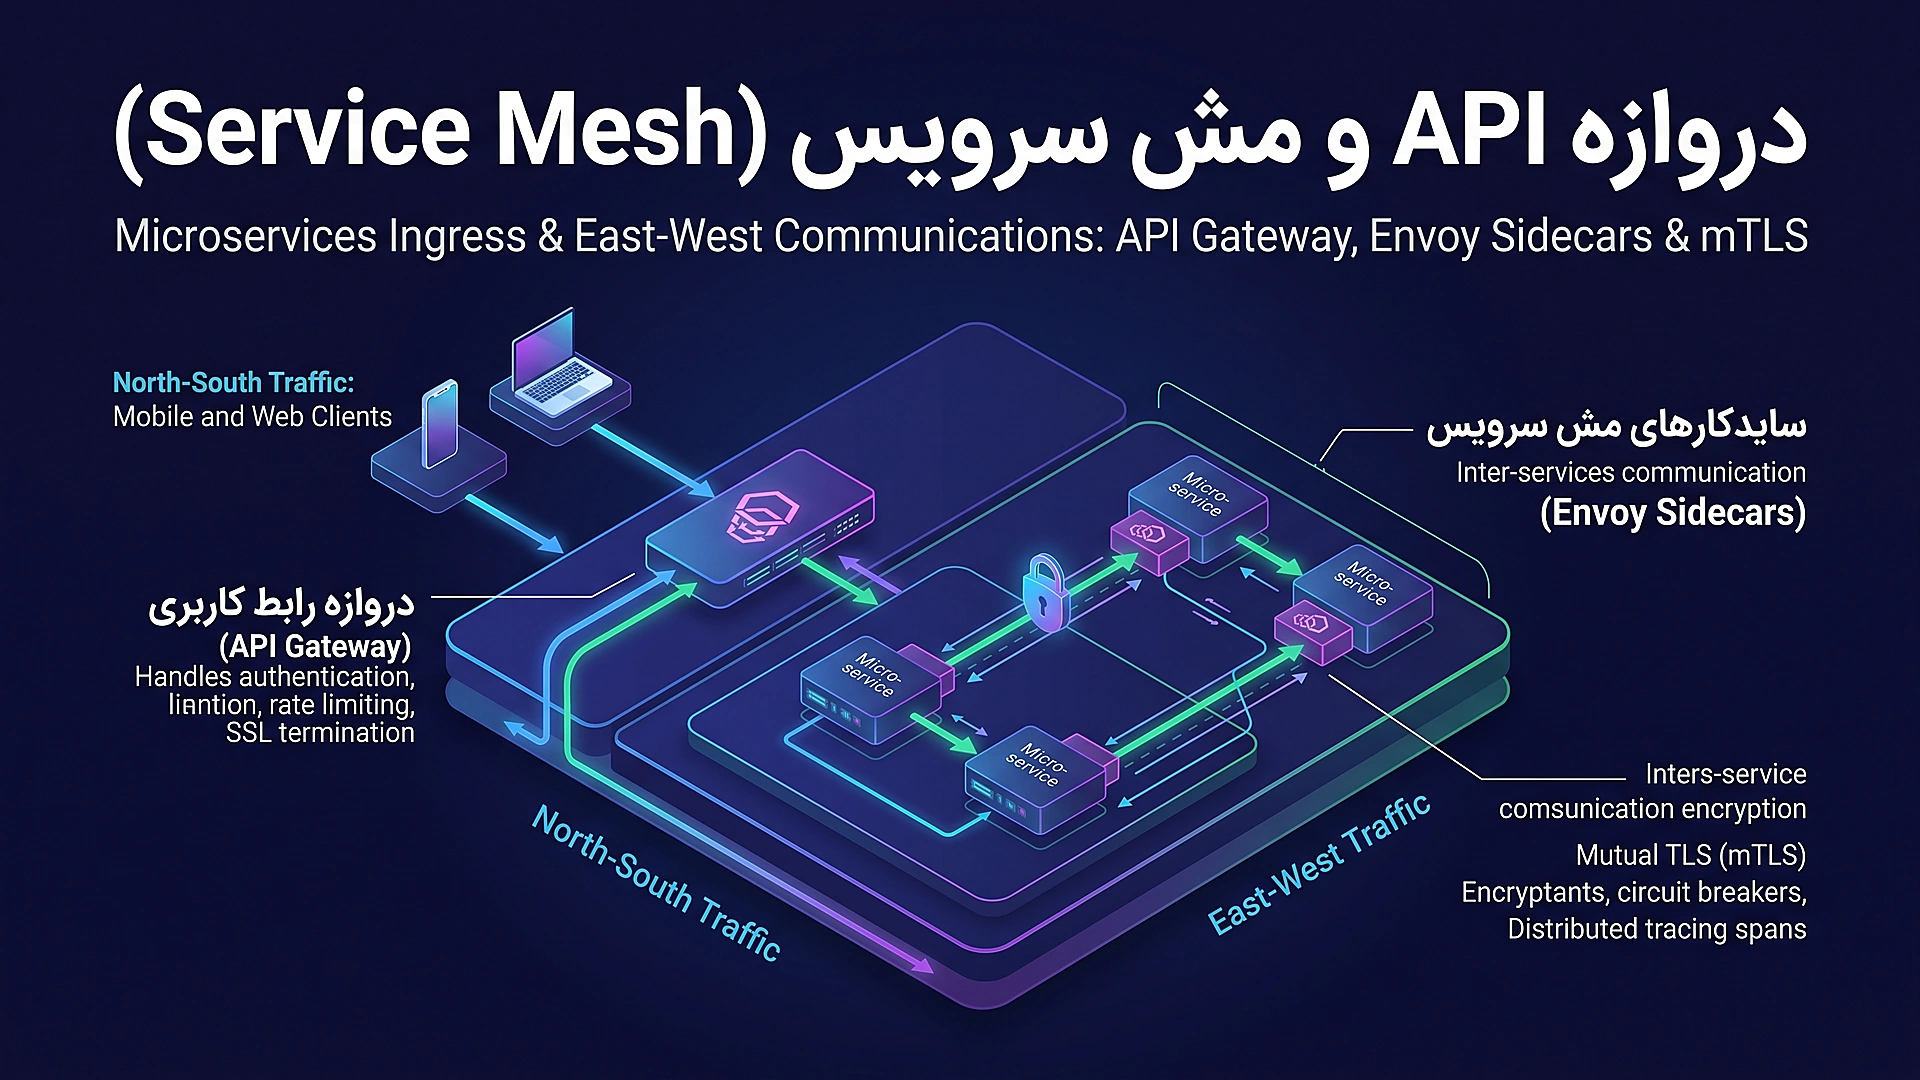
در سیستم های میکرو سرویس، کلاینت های فرانت اند و اپلیکیشن های موبایل توسعهیافته با فریم ورک های کراس پلتفرم نظیر فلاتر یا ری اکت نیتیو نباید آدرس آیپی ده ها سرویس داخلی را بدانند یا مستقیماً با آنها ارتباط برقرار کنند. درگاه ورودی (API Gateway) نظیر Kong، Envoy یا Spring Cloud Gateway به عنوان نقطه ورود مرکزی عمل میکند. وظایف حیاتی گیتوی شامل تخلیه پروتکل اساسال (SSL/TLS Offloading)، مسیریابی هوشمند مسیرها، اعتبارسنجی توکن های احراز هویت نظیر JWT، و اعمال سقف ترافیک ورودی (Rate Limiting) برای جلوگیری از حملات منع سرویس است.
الگو های امنیت و احراز هویت در معماری های توزیع شده
در یک معماری مونولیتیک، احراز هویت کاربر به سادگی از طریق سشن های ذخیرهشده در حافظه سرور (Stateful In-Memory Sessions) و کوکی های مرورگر مدیریت میشد. اما در یک کلاستر میکرو سرویس با ده ها نمونه مستقل از هر سرویس، ذخیره سازی سشن روی یک سرور خاص غیرممکن است مگر اینکه یک پایگاه داده مشترک سریع نظیر ردیس (Redis Shared Session Store) به کار گرفته شود که خود به یک نقطه تکین شکست (Single Point of Failure) بدل خواهد شد.
رویکرد استاندارد در سیستم های مدرن، استفاده از توکن های دیجیتالی بدون حالت (Stateless JSON Web Tokens - JWT) بر پایه استانداردهای OAuth ۲.۰ و OpenID Connect است. در این الگو، فرآیند اعتبارسنجی نام کاربری و رمز عبور تنها یکبار در سرویس هویت و احراز هویت (Auth Service) صورت میگیرد و یک توکن امضاشده دیجیتالی با کلید نامتقارن (RS۲۵۶ Private Key) به کاربر داده میشود. درگاه ورودی یا سایر سرویس های تنها با در اختیار داشتن کلید عمومی (Public Key)، اعتبار توکن و نقش های کاربری را در حافظه محلی خود در کسری از میکروثانیه اعتبارسنجی میکنند بدون اینکه نیازی به ارسال درخواست شبکهای به سرویس احراز هویت داشته باشند.
همچنین برای رفع چالش ابطال فوری توکن های سرقتشده (Token Revocation)، از استراتژی توکن دوگانه استفاده میشود: یک توکن دسترسی (Access Token) با طول عمر بسیار کوتاه (مثلاً ۱۰ دقیقه) که بدون دسترسی به دیتابیس اعتبارسنجی میشود، و یک توکن تازه سازی (Refresh Token) با طول عمر طولانی (مثلاً ۳۰ روز) که به صورت ایمن در دیتابیس اعتبارسنجی و در صورت لزوم فوراً باطل میگردد.
مش سرویس و ردیابی توزیع شده با OpenTelemetry
با گسترش سرویس های در ابعاد صدها نمونه، ارتباطات داخلی میان سرویس های (ترافیک شرق به غرب) نیازمند امنیت سفت و سخت رمزنگاری دوطرفه (mTLS) است. راهکارهای مش سرویس مانند Istio این قابلیت را بدون تغییر در کدهای بیزینس و از طریق کانتینر های سایدکار (Sidecar Proxies) فراهم میآورند.
علاوه بر این، در هنگام وقوع کندی یا خطای ۵۰۰ در یک درخواست کاربر، پیدا کردن منشأ خطا در میان ۲۰ سرویس مختلف غیرممکن است مگر اینکه از استانداردهای ردیابی توزیع شده (Distributed Tracing) استفاده شود. پروتکل استاندارد OpenTelemetry برای هر درخواست یک `Trace ID` یکتا تولید میکند که از طریق هدرهای شبکه بین تمام سرویس های دست به دست میشود. بدین ترتیب در پنلهایی نظیر Jaeger یا Zipkin، معمار سیستم میتواند تایم لاین میلیثانیهای اجرای هر بخش از درخواست را مشاهده کند و گلوگاه های شبکه یا کوئری های کند دیتابیس را در کسری از ثانیه شناسایی نماید.
مدل هزینه و قانون جریمه میکرو سرویس
مارتین فاولر، از برجستهترین پیشگامان مهندسی نرم افزار، قانونی طلایی به نام «جریمه میکرو سرویس» (Microservice Premium) را تدوین کرده است که استقرار بهینه آن با ابزار های کانتینرسازی نظیر داکر (Docker) تحلیل میگردد. بر اساس این اصل مهندسی، بهرهوری اولیه تیم ها در یک پروژه میکرو سرویس به مراتب پایینتر از مونولیت است؛ زیرا بخش عمدهای از انرژی مهندسان صرف پایپ لاین های CI/CD، کانفیگ داکر، عیبیابی شبکه و نوشتن پروتکل های ارتباطی میشود.
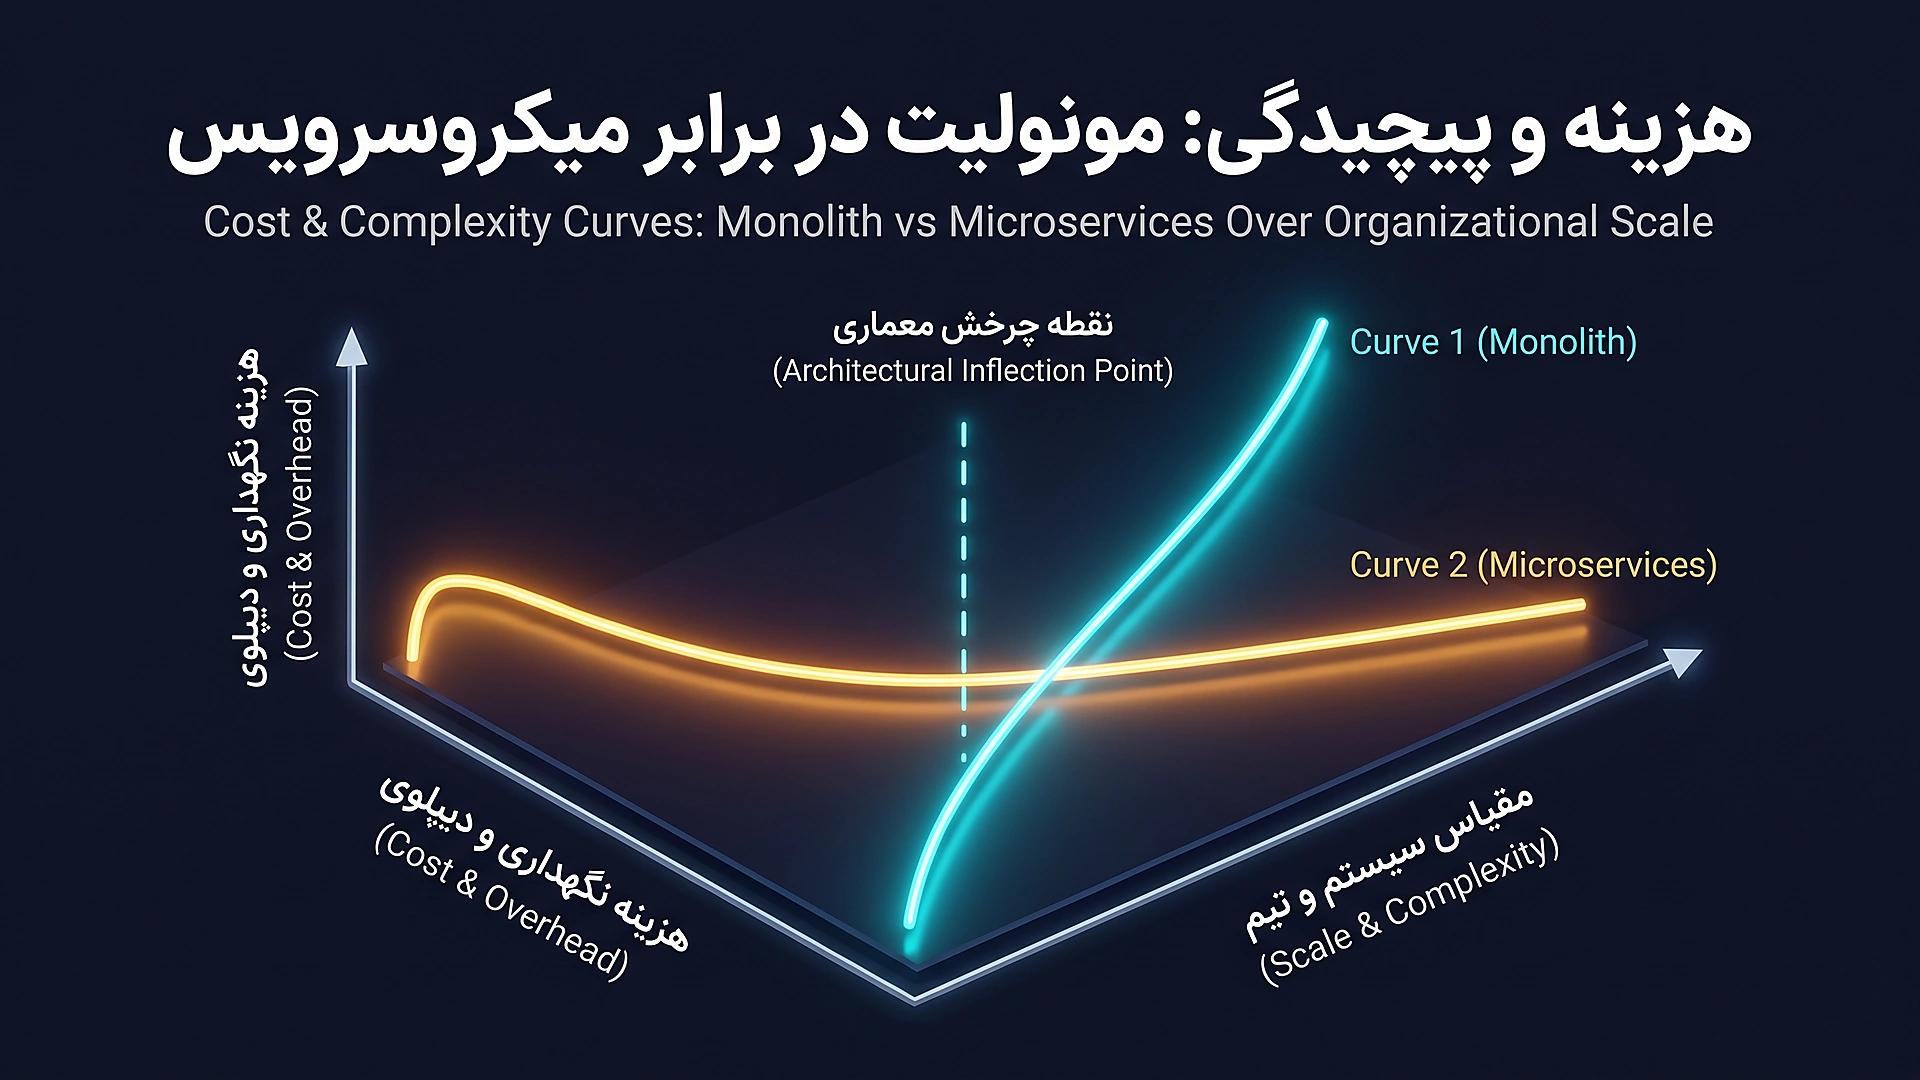
تنها زمانی که وسعت پایگاه کد و تعداد مهندسان سازمان از یک حد آستانه بحرانی (معمولاً بیش از ۳ الی ۴ تیم مستقل یا ۳۰ توسعه دهنده) عبور کند، شیب بهرهوری میکرو سرویس به دلیل از میان برداشتن تداخل سازمانی در گیت و مستقل شدن چرخه های انتشار، از شیب بهرهوری مونولیت پیشی خواهد گرفت. انتخاب میکرو سرویس برای پروژهای با ۵ توسعه دهنده، چیزی جز شلیک به پای خود و اتلاف بیرحمانه سرمایه استارتاپ نخواهد بود.
استراتژی مهاجرت بدون خاموشی با الگوی انجیر خفه کننده
اگر در حال حاضر یک سیستم مونولیتیک بزرگ دارید که اسکیل پذیری آن به بنبست رسیده است، بدترین کار ممکن بازنویسی از صفر (Big Bang Rewrite) است. آمار پروژه هایی نرم افزاری نشان میدهد که بیش از ۸۰ درصد بازنویسی های کامل با شکست، اتمام بودجه یا تأخیرهای چندساله مواجه میشوند؛ زیرا سیستم قدیمی همچنان در حال رشد و دریافت فیچر است و تیم بازنویسی هرگز به آن نخواهد رسید.
استراتژی استاندارد صنعت برای گذار امن، الگوی انجیر خفهکننده (Strangler Fig Pattern) است. گیاه انجیر خفهکننده در طبیعت از بالای شاخه های یک درخت کهنسال شروع به رشد میکند و به تدریج با ریشهدواندن در طول تنه، جایگزین تنه اصلی درخت میشود بدون اینکه در ابتدا آسیبی به پایداری آن بزند.
مراحل اجرای الگوی Strangler Fig در نرم افزار:
- گام نخست: یک درگاه API Gateway در جلوی مونولیت قدیمی قرار داده و تمام ترافیک ورودی را از طریق آن هدایت کنید (در ابتدا ۱۰۰ درصد ترافیک به سمت مونولیت میرود).
- گام دوم: یک ماژول فرعی با وابستگی کم (مانند سرویس اعلان ها یا نظرات کاربران) را انتخاب کرده و کد آن را به عنوان یک میکرو سرویس جدید بازنویسی کنید.
- گام سوم: مسیرهای مربوط به این ماژول در API Gateway تغییر یافته و ترافیک به سمت میکرو سرویس جدید هدایت میشود.
- گام چهارم: این فرآیند را به صورت تدریجی برای دامنه های دیگر تکرار کنید تا جایی که هسته اصلی مونولیت قدیمی کاملاً خالی شده و آماده خاموش سازی شود.
درخت تصمیم گیری استراتژیک برای انتخاب معماری
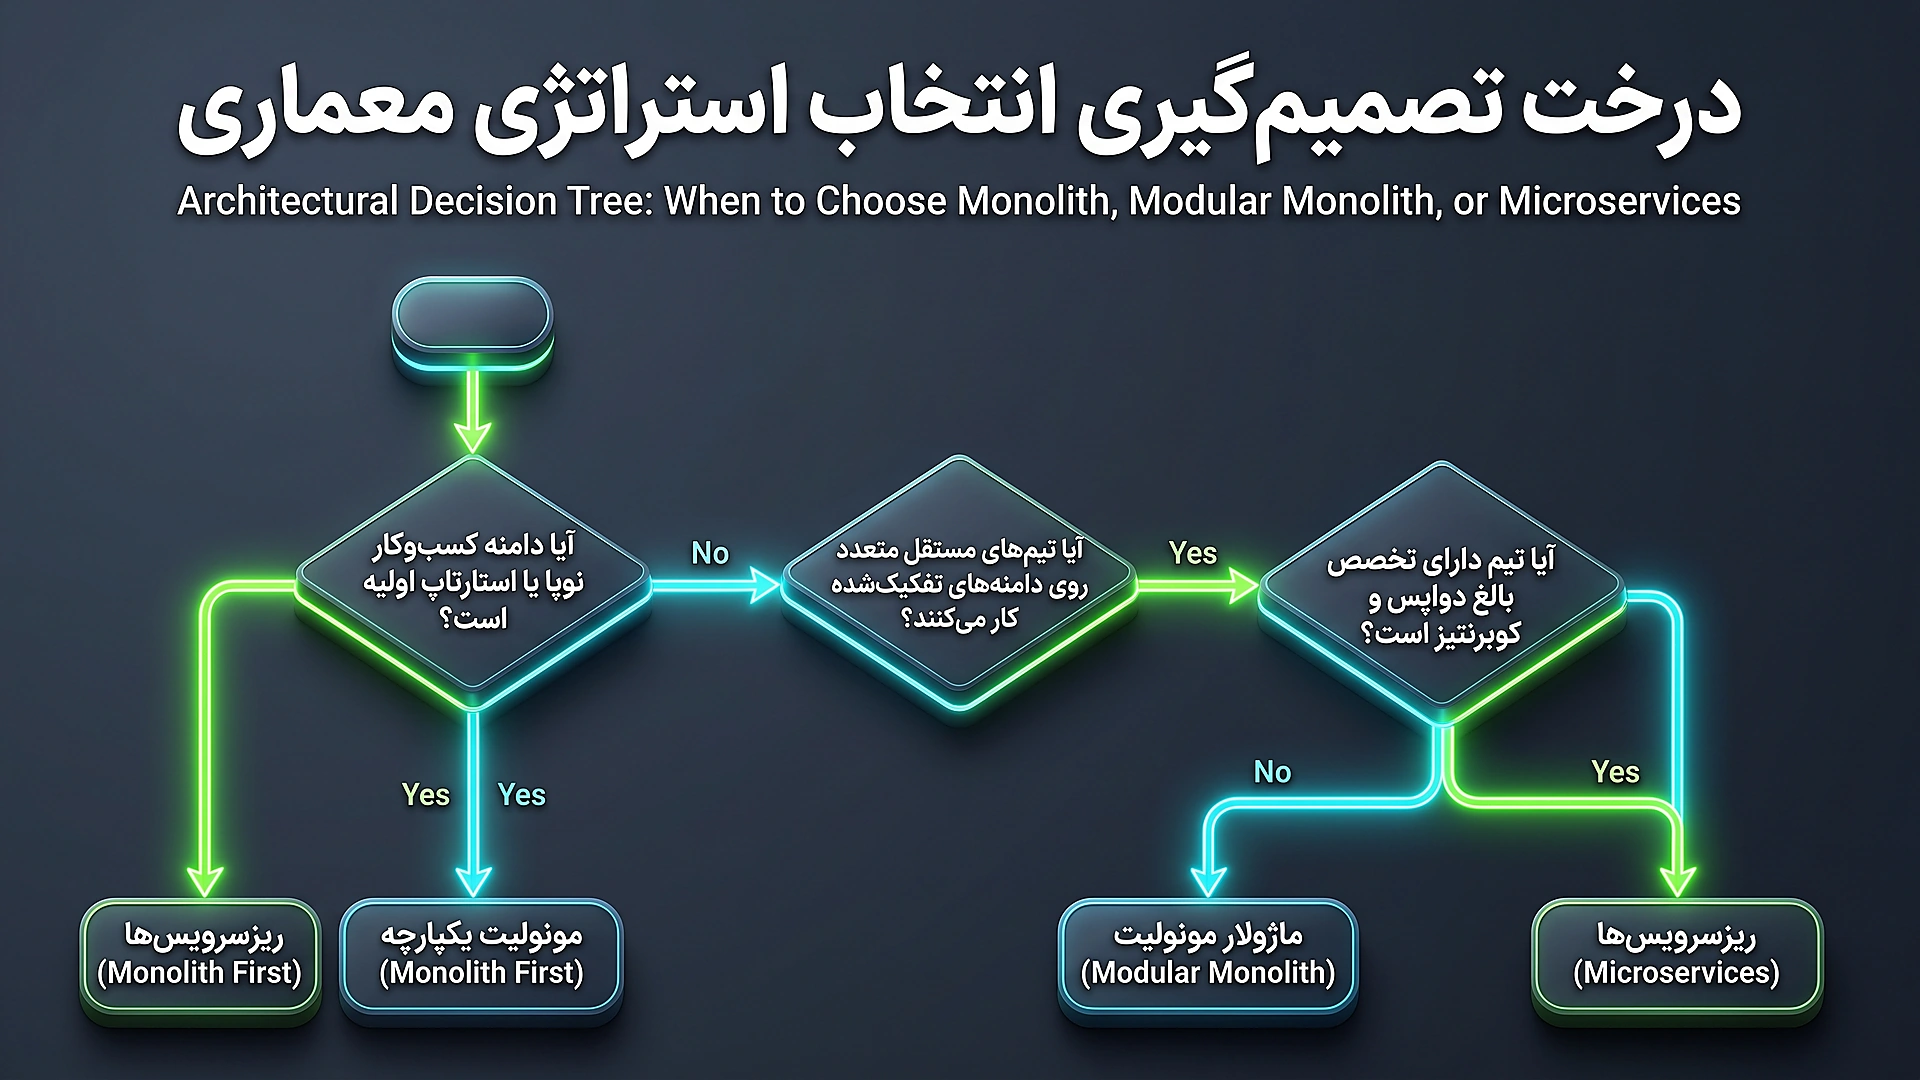
هیچ معماری برتر مطلقی در مهندسی نرم افزار وجود ندارد؛ هر انتخابی توازنی میان مزایا و معایب (Trade-offs) است. برای اینکه از گرفتار شدن در دام مدهای زودگذر جلوگیری کنید، از درخت تصمیمگیری زیر بهره بگیرید:
جمع بندی تحلیلی و توصیه های اجرایی برای مدیران فنی
میکرو سرویس پاسخی سازمانی به معضل مقیاس تیم های بزرگ است، نه ابزاری برای نوشتن کدهای بهتر. اگر تیم مهندسی شما کمتر از ۲۰ تا ۳۰ نفر است، بهترین، امنترین و سریعترین معماری ممکن برای شما «ماژولار مونولیت» است. ماژولار مونولیت به شما اجازه میدهد انضباط مرزهای دامنه و پاکیزگی لایه های کدی را به دقت تمرین کنید، بدون آنکه هزینه های سنگین شبکه، ارکستراسیون کانتینر ها، ناپایداری های تراکنش های توزیع شده و دیباگ چندساعته ردیابی لاگ ها را متحمل شوید.
چنانچه سازمان شما به مرحلهای از بلوغ رسیده که تیم های چندگانه مستقل دارد، زیرساخت دواپس با پایپ لاین های خودکار تست و استقرار در کلاستر کوبرنتیز کاملاً تثبیت شده است و دامنه های کسبوکار کاملاً شفاف و بدون ابهام هستند، آنگاه ورود حسابشده به معماری میکرو سرویس از طریق الگوی استخراج تدریجی Strangler Fig بیشترین ارزش افزوده تجاری را برای محصول شما رقم خواهد زد. مهندس ارشد کسی نیست که پیچیدهترین سیستم را طراحی کند، بلکه کسی است که سادهترین سیستم پاسخگوی نیازهای سازمان را با بالاترین کیفیت و کمترین هزینه پدید آورد.
امتیاز و نظرات
هنوز نظری ثبت نشده است. اولین نفر باشید.