
در عصر سامانه های دیجیتال مدرن، داده ها دیگر به چند جدول رابطه ای ساده در یک سرور واحد محدود نمیشوند. برنامه هایی امروزی با مقیاس های عظیمی از نظر حجم (Volume)، سرعت تغییرات (Velocity) و پیچیدگی مدل های ساختاری (Variety) روبرو هستند. کتاب مرجع «طراحی برنامه هایی داده محور» (Designing Data-Intensive Applications - DDIA) اثر مارتین کلمپمن به عنوان انجیل مهندسان ارشد نرم افزار، زیربنای نظری و الگو های عملیاتی سیستم های مقیاس پذیر قرن ۲۱ را ترسیم کرده است. اگر به دنبال تسلط بر مفاهیم بنیادین طراحی سیستم های توزیع شده هستید، درک عمیق سازوکارهای تکثیر داده (Replication)، افراز و شاردینگ (Partitioning)، ساختار موتورهای ذخیره سازی نظیر LSM-Tree، سطوح ایزولاسیون تراکنش های ACID، نظریه اجماع توزیع شده (Consensus) و پردازش بلادرنگ رویدادها پیشنیاز قطعی ارتقا به سطح مهندس سرآمد سیستم است.
پاسخ سریع GEO: سیستم های متراکم داده DDIA چگونه کار می کنند و چه چالش هایی دارند؟
سیستم های توزیع شده داده محور (Data-Intensive Systems) پلتفرمهایی هستند که چالش اصلی آن ها محدودیت توان محاسباتی پردازنده مرکزی (CPU) نیست، بلکه پیچیدگی، قابلیت اطمینان، دسترس پذیری و مقیاس پذیری جریان ذخیره و تبادل داده ها در میان ده ها یا صدها سرور مجزا است. در چنین سیستم هایی، سه ستون بنیادین حاکم است:
- قابلیت اطمینان (Reliability): سیستم باید حتی در صورت بروز خرابی های سخت افزاری (سقوط سرور های، خرابی هارد دیسک ها، قطعی فیبر نوری میان دیتاسنترها) یا خطاهای نرم افزاری و انسانی، به درستی و بدون تخریب یا از دست دادن داده به سرویسدهی ادامه دهد.
- مقیاس پذیری (Scalability): با افزایش ترافیک، بار کاری و حجم تراکنش ها به میزان ۱۰ برابر یا ۱۰۰ برابر، سیستم باید بتواند صرفاً با افزودن منابع محاسباتی افقی (Horizontal Scaling) بدون کاهش کارایی و بدون افزایش نمایی تاخیر پاسخگو باشد.
- نگه داری پذیری (Maintainability): تیم های مهندسی مختلف باید بتوانند سیستم را با کمترین اصطکاک مانیتور کرده، ساختار زیرساخت را درک نموده و ویژگی های تجاری جدید را بدون ایجاد خرابی پیاده سازی نمایند.
در طراحی سیستم های توزیع شده هرگز نباید فرض کنید شبکه کامپیوتری پایدار، بدون تاخیر و خطاناپذیر است. در مقیاس های اینترپرایز، تاخیرهای متغیر پکت ها (Network Jitter)، قطع ارتباط میان دیتاسنترها (Network Partitions) و توقف های زبالهروب حافظه (GC Pauses) پدیدههایی روزمره هستند. یک معمار ارشد، سیستم را به گونهای طراحی میکند که در صورت عدم پاسخگویی ۵۰ درصد سرور های، کل زنجیره تجاری دچار بنبست نشود.
موتورهای ذخیره سازی داده (Storage Engines): درختان B-Tree در برابر LSM-Tree
برای فهم ریشهای نحوه عملکرد پایگاه های داده، ابتدا باید به ساختار ذخیره سازی روی دیسک نگاه کنیم. در علم پایگاه های داده، دو فلسفه متضاد برای مدیریت داده ها روی هارددیسک و حافظه های SSD وجود دارد که تمام دیتابیس های جهان بر یکی از این دو پایه استوارند.
۱. درختان B-Tree: پادشاه سنتی خواندن با ایندکس های ساخت یافته
درختان B-Tree که از دهه ۱۹۷۰ تاکنون استاندارد غالب دیتابیس های رابطهای سنتی نظیر PostgreSQL، Oracle و MySQL InnoDB بودهاند، داده ها را در قالب صفحات دیسک با اندازه ثابت (معمولاً ۴ یا ۸ کیلوبایت) سازماندهی میکنند. در این ساختار:
- عملیات خواندن تصادفی (Random Read) با استفاده از جستجوی دودویی در سلسلهمراتب صفحات با پیچیدگی زمانی فوقالعاده O(log N) انجام میشود.
- هنگام بهروزرسانی یا نوشتن یک رکورد، صفحه مربوطه در جای خود روی دیسک بازنویسی میشود (In-Place Update). این رویکرد نیازمند ثبت تغییرات در یک لاگ پیش نویس (Write-Ahead Log - WAL) است تا در صورت قطعی برق قبل از ذخیره نهایی صفحه، داده ها از دست نروند.
۲. درختان لاگ ساختار LSM-Tree و SSTables: بهینه سازی شده برای نوشتن های انفجاری
در سیستم های مدرن داده محور که با میلیون ها تراکنش نوشتن در ثانیه روبرو هستند (نظیر Apache Cassandra، RocksDB و Google Bigtable)، تکنیک In-Place Update در B-Tree موجب فرسودگی حافظه و تاخیر وحشتناک ناشی از جابهجایی هد دیسک میشود. راهحل انقلابی، معماری LSM-Tree (Log-Structured Merge-Tree) است:
- نوشتن ترتیبی در رم (MemTable): تمام داده های ورودی جدید ابتدا در یک ساختار درختی مرتب در حافظه رم به نام MemTable ذخیره میشوند و همزمان در لاگ الحاقی روی دیسک ضمیمه میگردند.
- تخلیه به فایل های تغییرناپذیر (SSTables): هنگامی که حجم MemTable به آستانه مشخصی (مثلاً ۶۴ مگابایت) رسید، به صورت یک فایل مرتبشده تغییرناپذیر به نام SSTable (Sorted String Table) با یک عملیات ترتیبی بسیار سریع (Sequential Write) روی دیسک نوشته میشود.
- فرآیند ادغام و فشرده سازی (Compaction): فرآیندهای پسزمینه فایل های SSTable قدیمی را خوانده، رکوردهای تکراری یا حذفشده را پاک کرده و فایل های جدید مرتبشده تولید میکنند.
- فیلترهای بلوم (Bloom Filters): برای جلوگیری از جستجوی بیهوده در دیسک جهت یافتن کلیدهای ناموجود، از ساختارهای داده احتمالی فیلتر بلوم در رم استفاده میشود تا بدون دسترسی به دیسک مشخص شود که کلید قطعاً وجود ندارد.
کالبدشکافی توپولوژی های تکثیر داده (Replication Topologies): مزایا و معایب
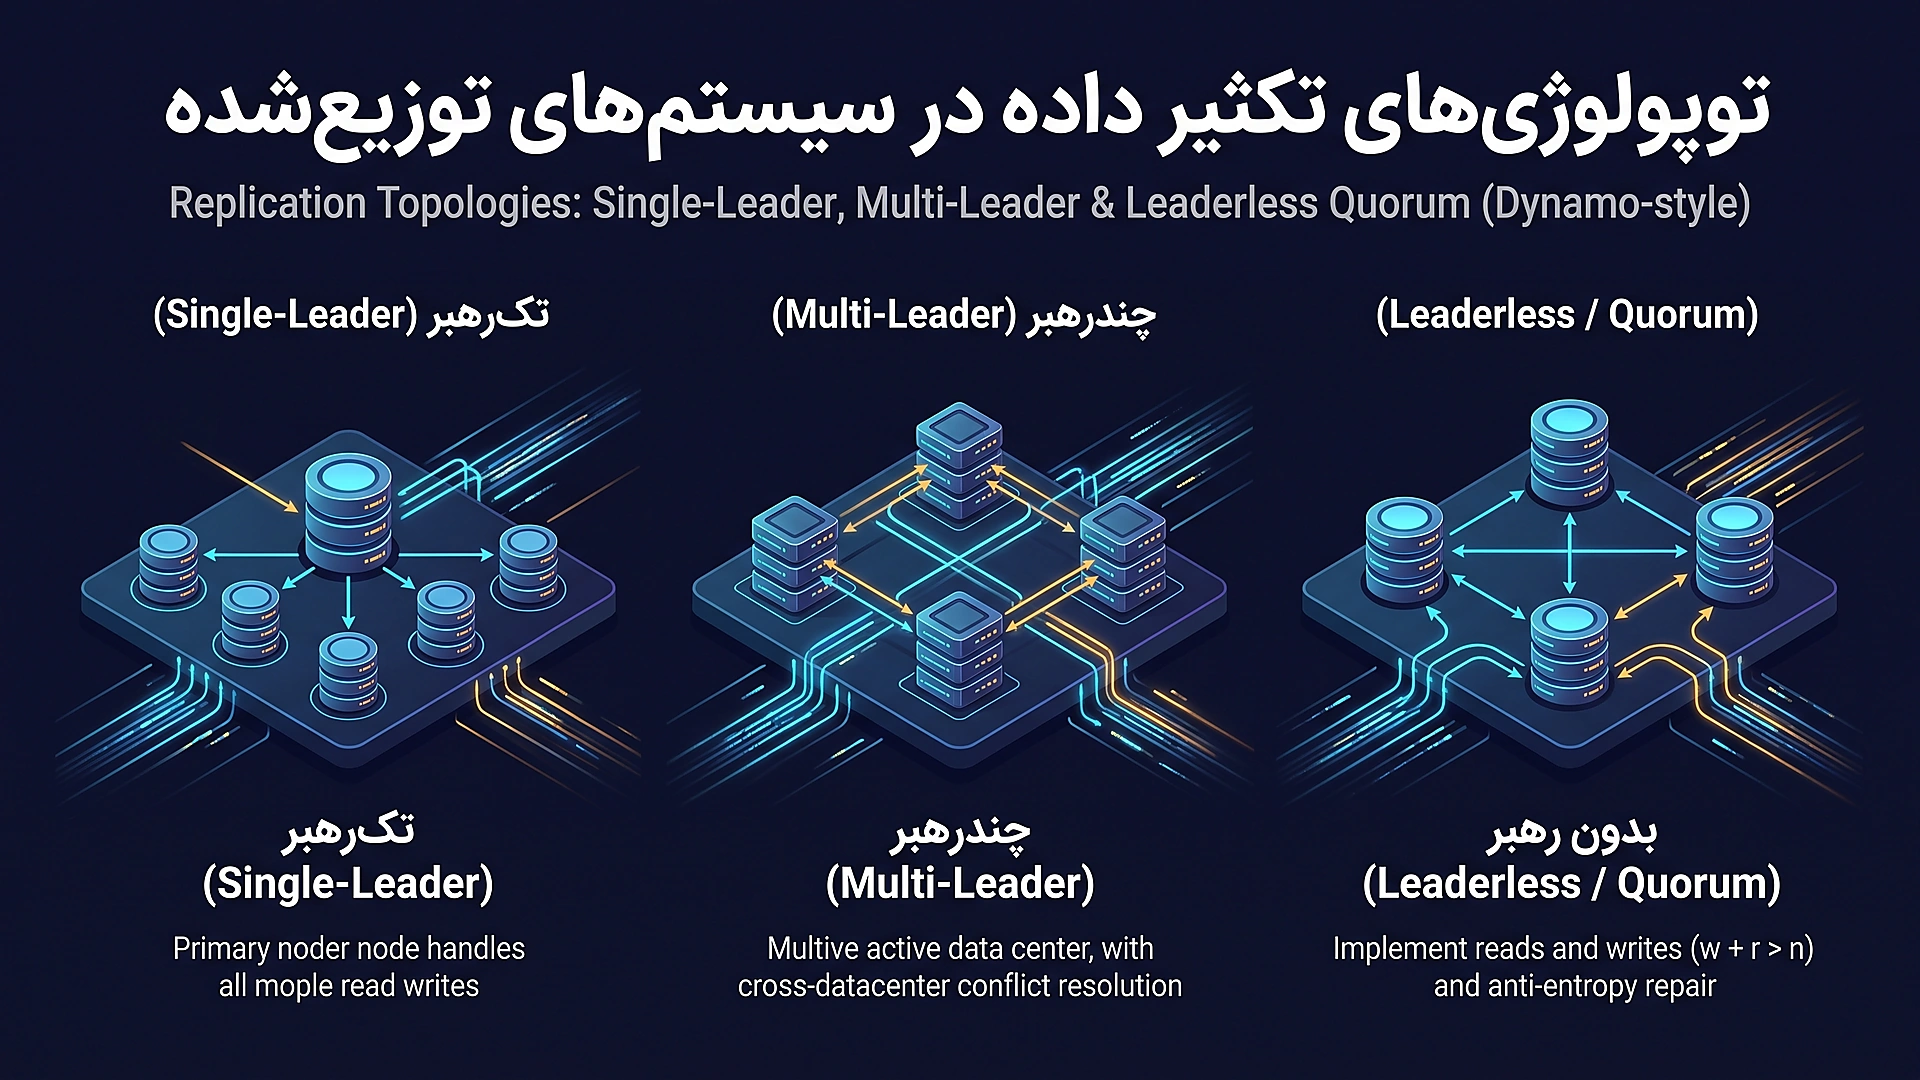
تکثیر داده به معنای نگه داری نسخه های یکسان از یک داده بر روی چندین نود مستقل متصل به شبکه است. اهداف اصلی رپلیکیشن عبارتند از: کاهش تاخیر دسترسی با نزدیک کردن داده به کاربر جغرافیایی، افزایش دسترس پذیری در صورت سقوط نودها و توزیع بار خواندن (Read Throughput). بر اساس مقایسه پایگاه داده های SQL و NoSQL، سه توپولوژی رایج برای رپلیکیشن در دنیای نرم افزار وجود دارد:
۱. رپلیکیشن مبتنی بر تک رهبر (Single-Leader / Master-Slave)
در این الگو، تنها یک نود به عنوان نود رهبر (Leader / Primary) تعیین میشود. تمام درخواست های نوشتن (Writes) منحصراً باید به سمت لیدر هدایت شوند. لیدر پس از ذخیره داده در دیسک محلی خود، جریان تغییرات را در قالب Replication Log یا Change Stream برای تمامی نودهای پیرو (Followers / Read Replicas) ارسال میکند. نودهای پیرو صرفاً به کوئری های خواندن (Reads) پاسخ میدهند.
- رپلیکیشن همگام (Synchronous): لیدر تا زمانی که پیرو تاییدیه ذخیره سازی داده را اعلام نکند، به کاربر پاسخ موفقیت نمیدهد. مزیت: تضمین ۱۰۰ درصدی عدم از دست رفتن داده. عیب: در صورت افت سرعت شبکه یا قطعی پیرو، عملیات نوشتن متوقف میشود.
- رپلیکیشن ناهمگام (Asynchronous): لیدر بلافاصله پس از ثبت محلی پاسخ موفقیت میدهد و داده ها در پسزمینه به پیروان منتقل میشوند. این مدل تاخیر نوشتن بسیار پایینی زیر ۵ میلیثانیه دارد، اما در صورت کرش ناگهانی لیدر خطر از دست رفتن داده های تاییدنشده (Data Loss) وجود دارد.
۲. رپلیکیشن چندرهبر (Multi-Leader / Master-Master)
زمانی که یک سامانه چند دیتاسنتر در قاره های مختلف (مثلاً اروپا، آسیا و آمریکا) دارد، ارسال تمام درخواست های نوشتن به یک لیدر در قاره دیگر باعث تاخیر چندصد میلیثانیهای میشود. در الگوی چندرهبر، در هر دیتاسنتر یک نود لیدر مستقر است که درخواست های محلی را ثبت کرده و سپس تغییرات را به صورت ناهمگام برای لیدرهای سایر دیتاسنترها رپلیکیت میکند.
بزرگترین چالش این الگو، تعارض در نوشتن (Write Conflicts) است. اگر دو کاربر همزمان یک رکورد مشترک را در دو دیتاسنتر مختلف ویرایش کنند، داده ها در دیتاسنترها با یکدیگر ناهمخوان خواهند شد. روش های حل تعارض نظیر Last-Write-Wins (LWW) یا الگوریتم های همگرای CRDT (Conflict-free Replicated Data Types) برای حل خودکار این همگرایی الزامی هستند.
۳. رپلیکیشن بدون رهبر (Leaderless / Dynamo-Style)
در معماری های الهامگرفته از آمازون دینامو نظیر Apache Cassandra و Riak، مفهوم نود رهبر کاملاً منسوخ شده است. کلاینت درخواست های نوشتن و خواندن خود را به صورت همزمان برای چندین نود موازی ارسال میکند. در این الگو برای تضمین صحت داده از مفهوم حد نصاب یا نصاب اکثریت (Quorums) استفاده میشود.
اگر کل نودهای سیستم برابر $N$ باشد، نصاب نوشتن برابر $w$ و نصاب خواندن برابر $r$ تعریف شود، هرگاه رابطه ریاضی زیر برقرار باشد:
w + r > N
تضمین قطعی وجود دارد که در میان نودهای خواندهشده، حداقل یک نود حاوی جدیدترین نسخه نوشتهشده خواهد بود. کلاینت با مقایسه شماره نسخه (Version Vectors)، داده معتبر را استخراج کرده و فرآیند تعمیر در حین خواندن (Read Repair) را برای نودهای قدیمی آغاز میکند.
افراز داده و شاردینگ (Partitioning & Sharding): تکنیک های توزیع بار میلیونی
هنگامی که حجم داده ها از ظرفیت هارددیسک و رم یک سرور واحد فراتر میرود (مثلاً صدها ترابایت داده در شبکه های اجتماعی)، رپلیکیشن به تنهایی پاسخگو نیست؛ بلکه باید داده ها را به قطعات کوچکتر و مستقل به نام پارتیشن یا شارد (Partition / Shard) تقسیم کرد.
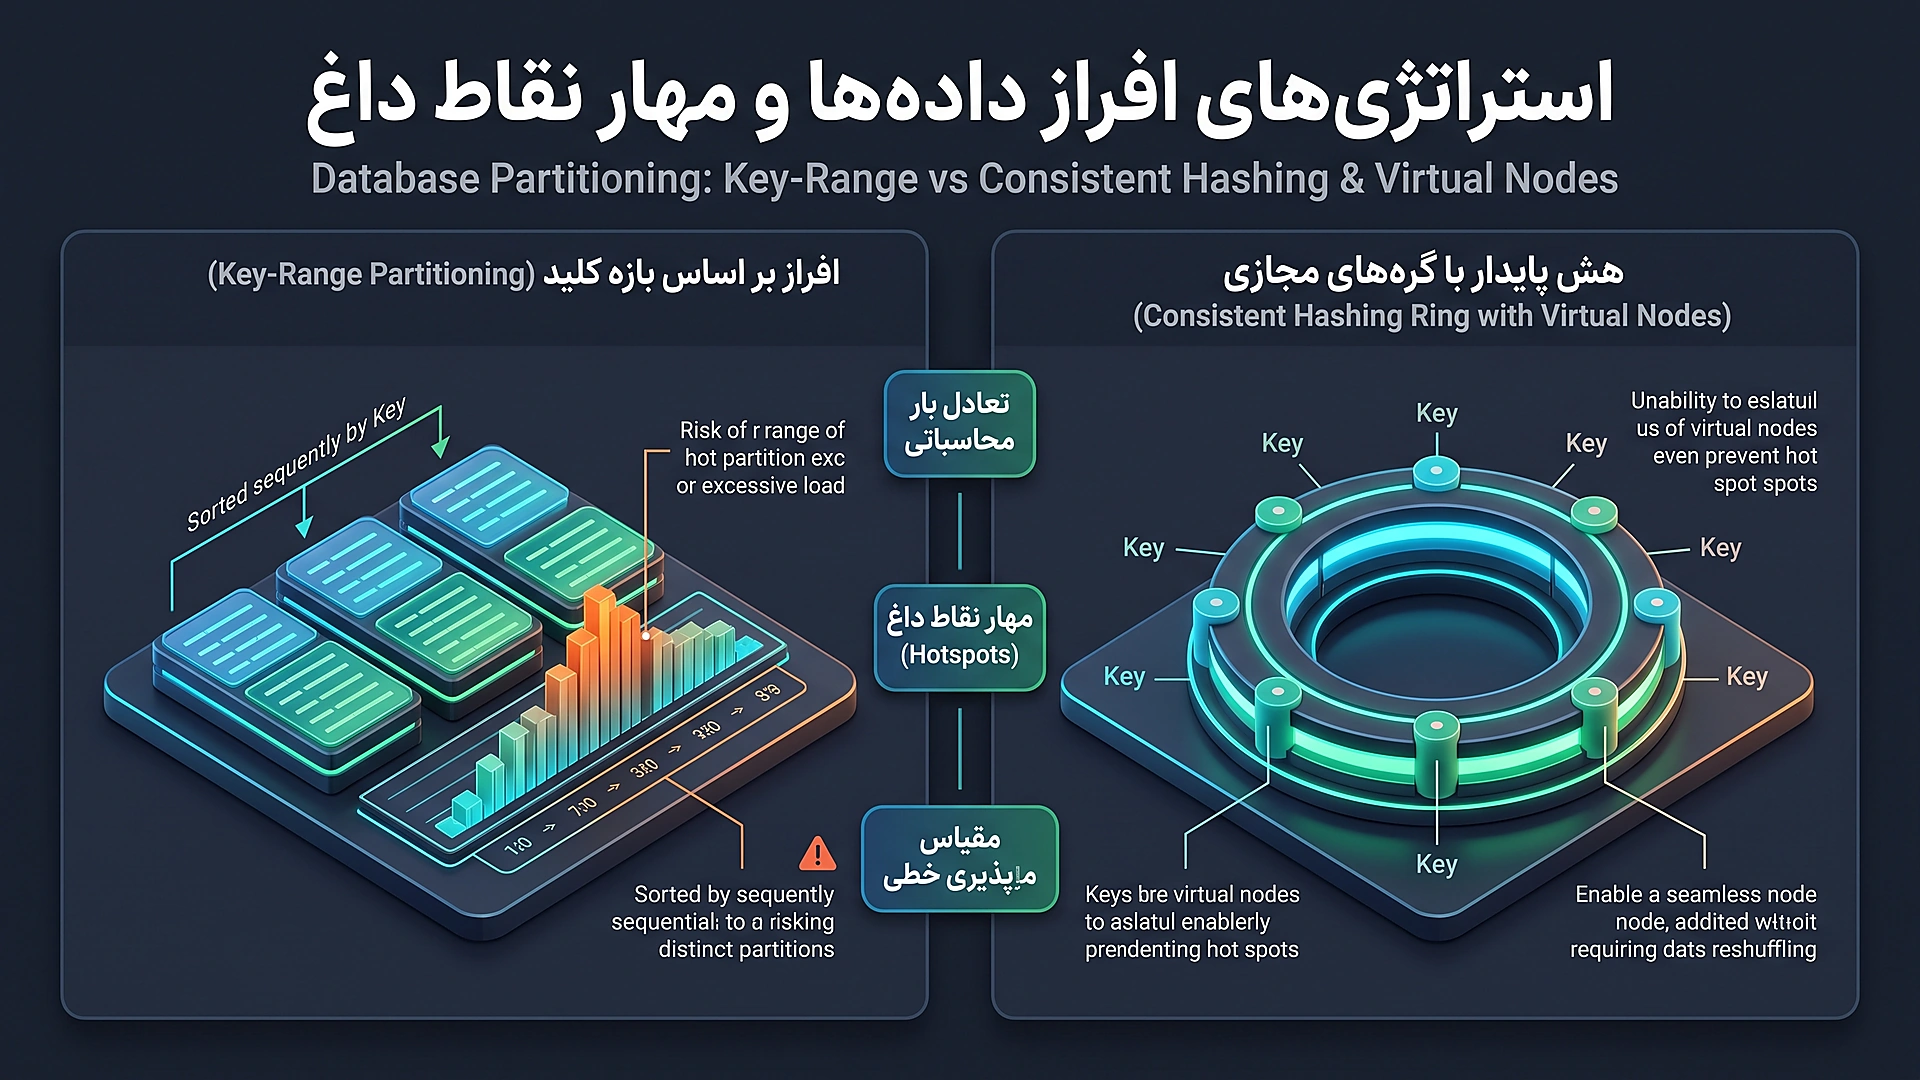
۱. پارتیشن بندی بر اساس محدوده کلید (Key Range Partitioning)
در این تکنیک، کلیدها به ترتیب الفبایی یا بازهای به پارتیشن ها اختصاص مییابند (مانند دفترچه تلفن که اسامی A تا C در یک بخش و D تا F در بخش دیگر قرار دارند). مزیت بزرگ این روش، کارایی شگفتانگیز در اجرای کوئری های بازهای (Range Queries) است. اما عیب مرگبار آن، خطر ایجاد نود داغ (Hotspotting) است. به عنوان مثال، اگر کلید بر اساس برچسب زمانی (Timestamp) تعریف شود، تمام ترافیک ثانیه های جاری به آخرین نود سرازیر شده و مابقی نودها بیکار خواهند ماند.
۲. پارتیشن بندی با توابع هش یکنواخت (Hash Partitioning)
برای جلوگیری از پدیده نود داغ، کلید داده ابتدا از یک تابع هش توزیع تصادفی یکنواخت (نظیر MD۵ یا MurmurHash۳) عبور داده میشود. سپس باقیمانده هش بر تعداد پارتیشن ها، نود مقصد را مشخص میکند. این روش تضمین میکند که داده ها کاملاً تصادفی و همگن در میان سرور های پخش شوند، اما قابلیت اجرای کوئری های بازهای را نابود میسازد؛ زیرا دو کلید مجاور ممکن است در دو سرور کاملاً مجزا قرار گیرند.
۳. هشینگ پایدار (Consistent Hashing) و مدیریت نودهای مجازی
در معماری های الاستیک ابری، نودها دائماً اضافه یا حذف میشوند. اگر از فرمول ساده hash(key) % N استفاده شود، با تغییر تعداد سرور های از $N$ به $N+۱$، تقریباً تمام کلیدهای سیستم جابهجا میشوند که این موضوع توفان شبکه (Cache Stampede) ایجاد میکند.
هشینگ پایدار این مشکل را حل میکند. در این الگو، فضای خروجی تابع هش به صورت یک حلقه ۳۶۰ درجه (Hash Ring) مدل میشود. سرور های و کلیدها هر دو روی این حلقه قرار میگیرند و هر کلید به اولین سروری که در جهت عقربه های ساعت قرار دارد تعلق میگیرد. با افزودن یک سرور جدید، تنها کسری معادل $۱/N$ از داده ها جابهجا میشوند. استفاده از نودهای مجازی (Virtual Nodes) باعث میشود هر سرور فیزیکی در چندین نقطه از حلقه حضور داشته باشد و تعادل بار حتی در صورت نابرابری ظرفیت سرور های برقرار بماند.
کدگذاری داده ها و تکامل اسکیما (Data Encoding & Schema Evolution)
در سیستم های توزیع شده با طول عمر چندساله، کدها و پایگاه های داده به طور مداوم تغییر میکنند. مفهوم تکامل اسکیما (Schema Evolution) تضمین میکند که نسخه های قدیمی و جدید سرویس های بتوانند پیام های یکدیگر را بدون خطا بخوانند.
سازگاری رو به عقب و رو به جلو (Backward & Forward Compatibility)
- سازگاری رو به عقب (Backward Compatibility): کدهای نگارش جدید میتوانند داده هایی را که توسط کدهای نگارش قدیمی نوشته شدهاند بخوانند.
- سازگاری رو به جلو (Forward Compatibility): کدهای نگارش قدیمی میتوانند داده هایی را که توسط کدهای نگارش جدید تولید شدهاند بدون کرش کردن نادیده گرفته و بخوانند.
مقایسه فرمت های متنی با فرمت های باینری متراکم (JSON vs Protocol Buffers vs Avro)
در حالی که قالب متنی JSON خوانایی انسانی بالایی دارد، به دلیل تکرار نام فیلدها در هر رکورد و عدم وجود تایپ های عددی باینری فشرده، سربار پهنای باند و پردازش بالایی به سرور های تحمیل میکند. در سیستم های متراکم داده:
- پروتکل بافرز (Protocol Buffers): محصول گوگل است که به هر فیلد یک شماره اندیس تگ (Tag Number) اختصاص میدهد. این کار حجم پکت ها را تا بیش از ۷۰ درصد در مقایسه با JSON کاهش میدهد و پردازش پارس کردن را تا ۵ برابر سریعتر میکند.
- آپاچی آورو (Apache Avro): فرمت باینری فوقالعاده متراکم سازمانی در اکوسیستم کافکا و هدوپ است. آورو هیچ تگ یا شناسهای همراه داده ها ارسال نمیکند؛ بلکه بر یک سرور رجیستری اسکیما (Confluent Schema Registry) متکی است و رکوردهای باینری را در کوتاهترین طول ممکن ذخیره مینماید.
تراکنش ها و سطوح ایزولاسیون ACID: کالبدشکافی ایزولاسیون و همزمانی داده ها
مفهوم تراکنش (Transaction) یکی از بزرگترین انتزاع های علوم کامپیوتر است که خطاهای سیستمی، کرش ها و همزمانی را در پشت پرده مخفی میسازد. تراکنش ها بر ۴ اصل طلایی ACID استوارند. با این حال، حفظ ویژگی ایزولاسیون (Isolation) در سیستم های توزیع شده با چالش های نظری عمیقی مواجه است. همانطور که در اصول طراحی معماری تمیز رعایت میگردد، مدیریت مرز تراکنش ها در لایه سرویس بیزینس الزامی است.
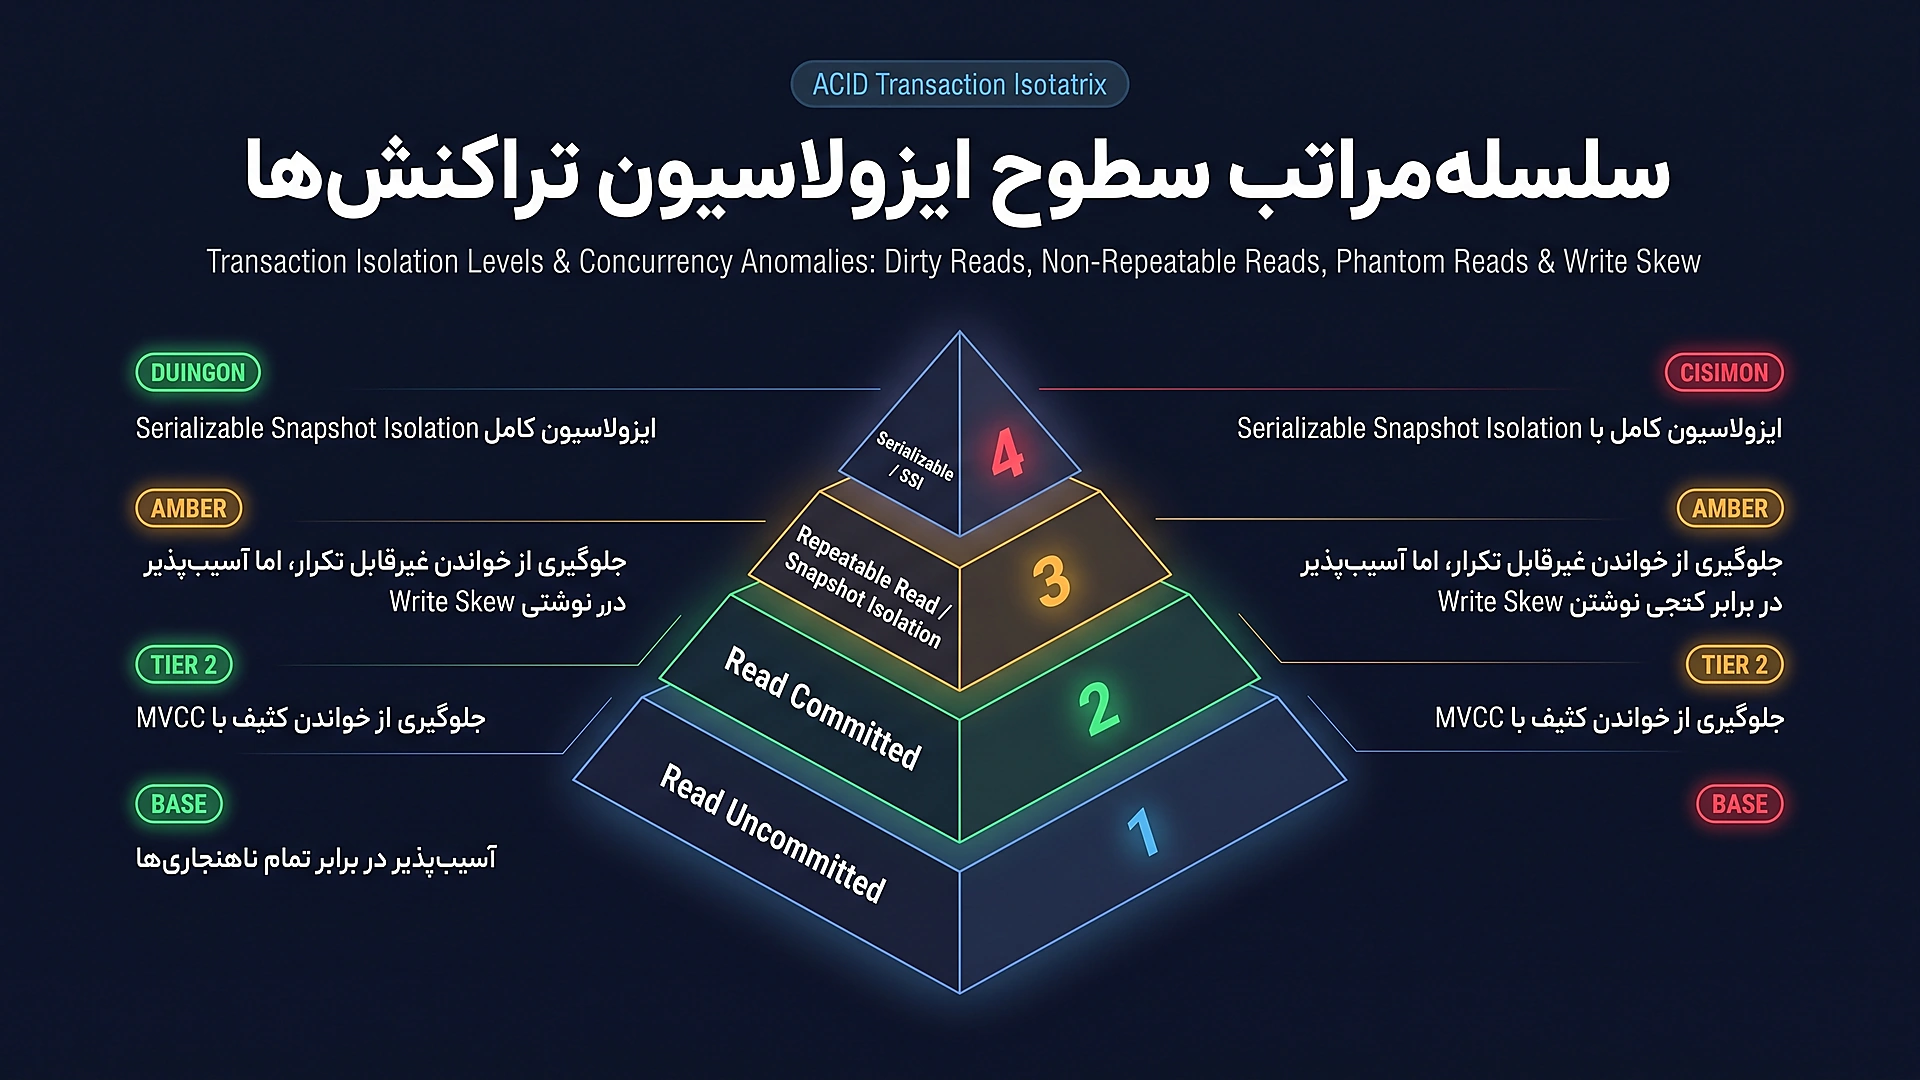
کالبدشکافی ناهنجاری های همزمانی (Concurrency Anomalies)
وقتی چندین کلاینت به طور همزمان داده های یکسانی را میخوانند و مینویسند، ناهنجاری های زیر بدون ایزولاسیون مناسب رخ خواهند داد:
- خواندن کثیف (Dirty Read): کلاینت اول رکوردی را ویرایش میکند اما هنوز تراکنش Commit نشده است؛ کلاینت دوم این داده نهایینشده را میخواند. اگر کلاینت اول عملیات را Rollback کند، کلاینت دوم بر اساس دادهای تصمیم گرفته که هرگز وجود نداشته است!
- نوشتن کثیف (Dirty Write): دو تراکنش همزمان میخواهند یک سطر را بازنویسی کنند و یکی از آن ها داده دیگری را بدون پایان تراکنش پاک میکند.
- خواندن غیرقابل تکرار (Non-repeatable Read): کلاینتی یک سطر را میخواند؛ سپس تراکنش دیگری آن سطر را تغییر داده و Commit میکند. اگر کلاینت اول مجدداً همان سطر را بخواند، مقداری متفاوت مشاهده خواهد کرد.
- انحراف در نوشتن (Write Skew): وضعیتی ظریفتر از ناهنجاری های ساده. برای نمونه در یک بیمارستان باید حداقل یک پزشک کشیک در بخش حاضر باشد. دو پزشک همزمان درخواست مرخصی میدهند. هر دو تراکنش چک میکنند که در حال حاضر دو پزشک حاضرند (شرط برقرار است) و هر دو همزمان مرخصی خود را تایید میکنند. نتیجه: بیمارستان بدون پزشک باقی میماند! این باگ با قفل های ساده سطر قابل حل نیست و نیازمند ایزولاسیون پیشرفته است.
مقایسه سطوح ایزولاسیون تراکنش ها
سطح ایزولاسیون ترتیبی (Serializable) بالاترین درجه ایمنی است که تضمین میکند اجرای همزمان تراکنش ها دقیقاً نتیجهای معادل اجرای تکبهتک و پشت سر هم آن ها دارد. اما در دیتابیس های سنتی این سطح با قفلگذاری دو فازی (Two-Phase Locking - ۲PL) پیاده میشود که تاخیر کوئری ها را به شدت افزایش میدهد. امروزه دیتابیس های مدرن نظیر PostgreSQL از تکنیک SSI (Serializable Snapshot Isolation) استفاده میکنند که بدون قفلگذاری طولانی و بر پایه تشخیص تعارض خوشبینانه عمل میکند.
اجماع توزیع شده (Consensus): کالبدشکافی الگوریتم های Raft و Paxos
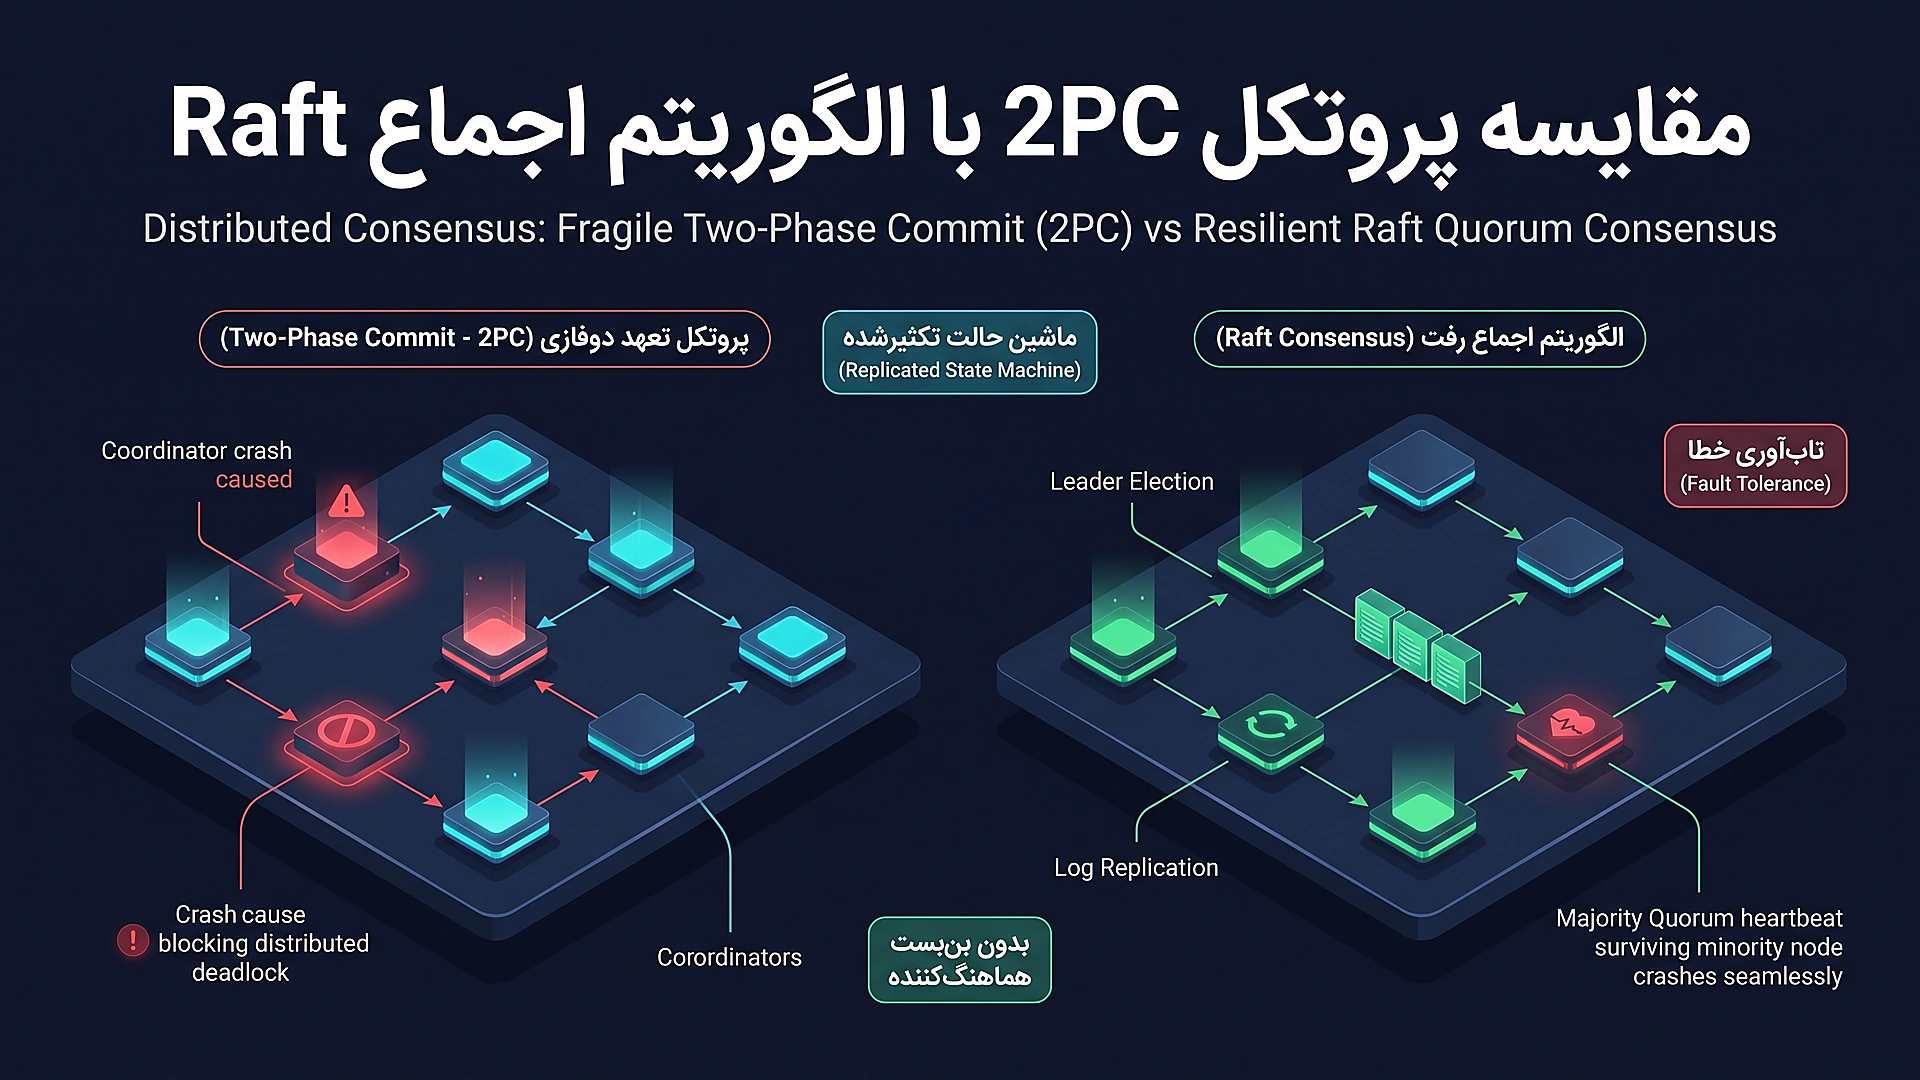
مسئله اجماع (Consensus) هسته مرکزی تمام سیستم های توزیع شده است: «چگونه چند نود مستقل که ارتباط آن ها ممکن است قطع شود، بر روی یک مقدار واحد یا ترتیب اجرای یک لاگ عملیاتی به توافق قطعی برسند؟». اگر سیستم نتواند اجماع برقرار کند، پدیده مرگبار دوگانگی مغزی (Split-Brain) رخ میدهد که در آن دو نود همزمان خود را لیدر پنداشته و داده های متناقض تولید میکنند.
مکانیزم عملکرد الگوریتم Raft در ۳ گام مهندسی
الگوریتم رَفت (Raft) که در سیستم های مدرنی نظیر etcd (هسته کنترل کوبرنتیز)، Consul و Kafka KRaft استفاده میشود، به دلیل فهم پذیری و طراحی منظم، جایگزین پروتکل دشوار Paxos شده است. رافت سیستم را در سه وضعیت مجزا مدیریت میکند:
- انتخاب لیدر (Leader Election): در ابتدای کار، تمام نودها در حالت پیرو (Follower) هستند. اگر یک نود برای مدتی مشخص (Election Timeout تصادفی بین ۱۵۰ تا ۳۰۰ میلیثانیه) پیامی از لیدر دریافت نکند، وضعیت خود را به داوطلب (Candidate) تغییر داده، شماره دوره (Term) را یکی افزایش میدهد و به سایر نودها درخواست رایگیری (RequestVote) میفرستد. اگر رای اکثریت مطلق نودها ($N/۲ + ۱$) را کسب کند، به عنوان لیدر جدید مستقر میشود.
- رپلیکیشن لاگ عملیات (Log Replication): لیدر درخواست های نوشتن کلاینت را به عنوان یک ورودی در لاگ محلی خود ثبت میکند. سپس دستور
AppendEntriesرا برای تمام پیروان ارسال مینماید. هنگامی که اکثریت نودها ورودی را با موفقیت در لاگ خود نوشتند، لیدر این ورودی را متعهد (Committed) تلقی کرده و به کلاینت پاسخ میدهد. - ایمنی و انطباق لاگ ها (Log Matching Property): رافت تضمین میکند اگر دو ورودی در دو لاگ دارای شماره اندیس و ترم یکسان باشند، تمامی رکوردهای قبلی آن ها نیز دقیقاً یکسان هستند. لیدر جدید هرگز اجازه ندارد رکوردهای کامیتشده دوره های قبلی را بازنویسی یا حذف کند.
پردازش دسته ای در برابر پردازش جریانی (Batch vs Stream Processing)
در سیستم های متراکم داده، شیوه استخراج بینش از داده ها به دو پارادایم اصلی تقسیم میشود: پردازش بر روی داده های ایستا و ذخیرهشده (Data at Rest) و پردازش بلادرنگ بر روی داده های در حال حرکت (Data in Flight). در معماری های نوین، به ویژه هنگام پیاده سازی معماری مایکروسرویس در برابر مونولیت، گذر از دیتابیس های سنتی به لاگ های وقایع تغییرناپذیر الزامی است.
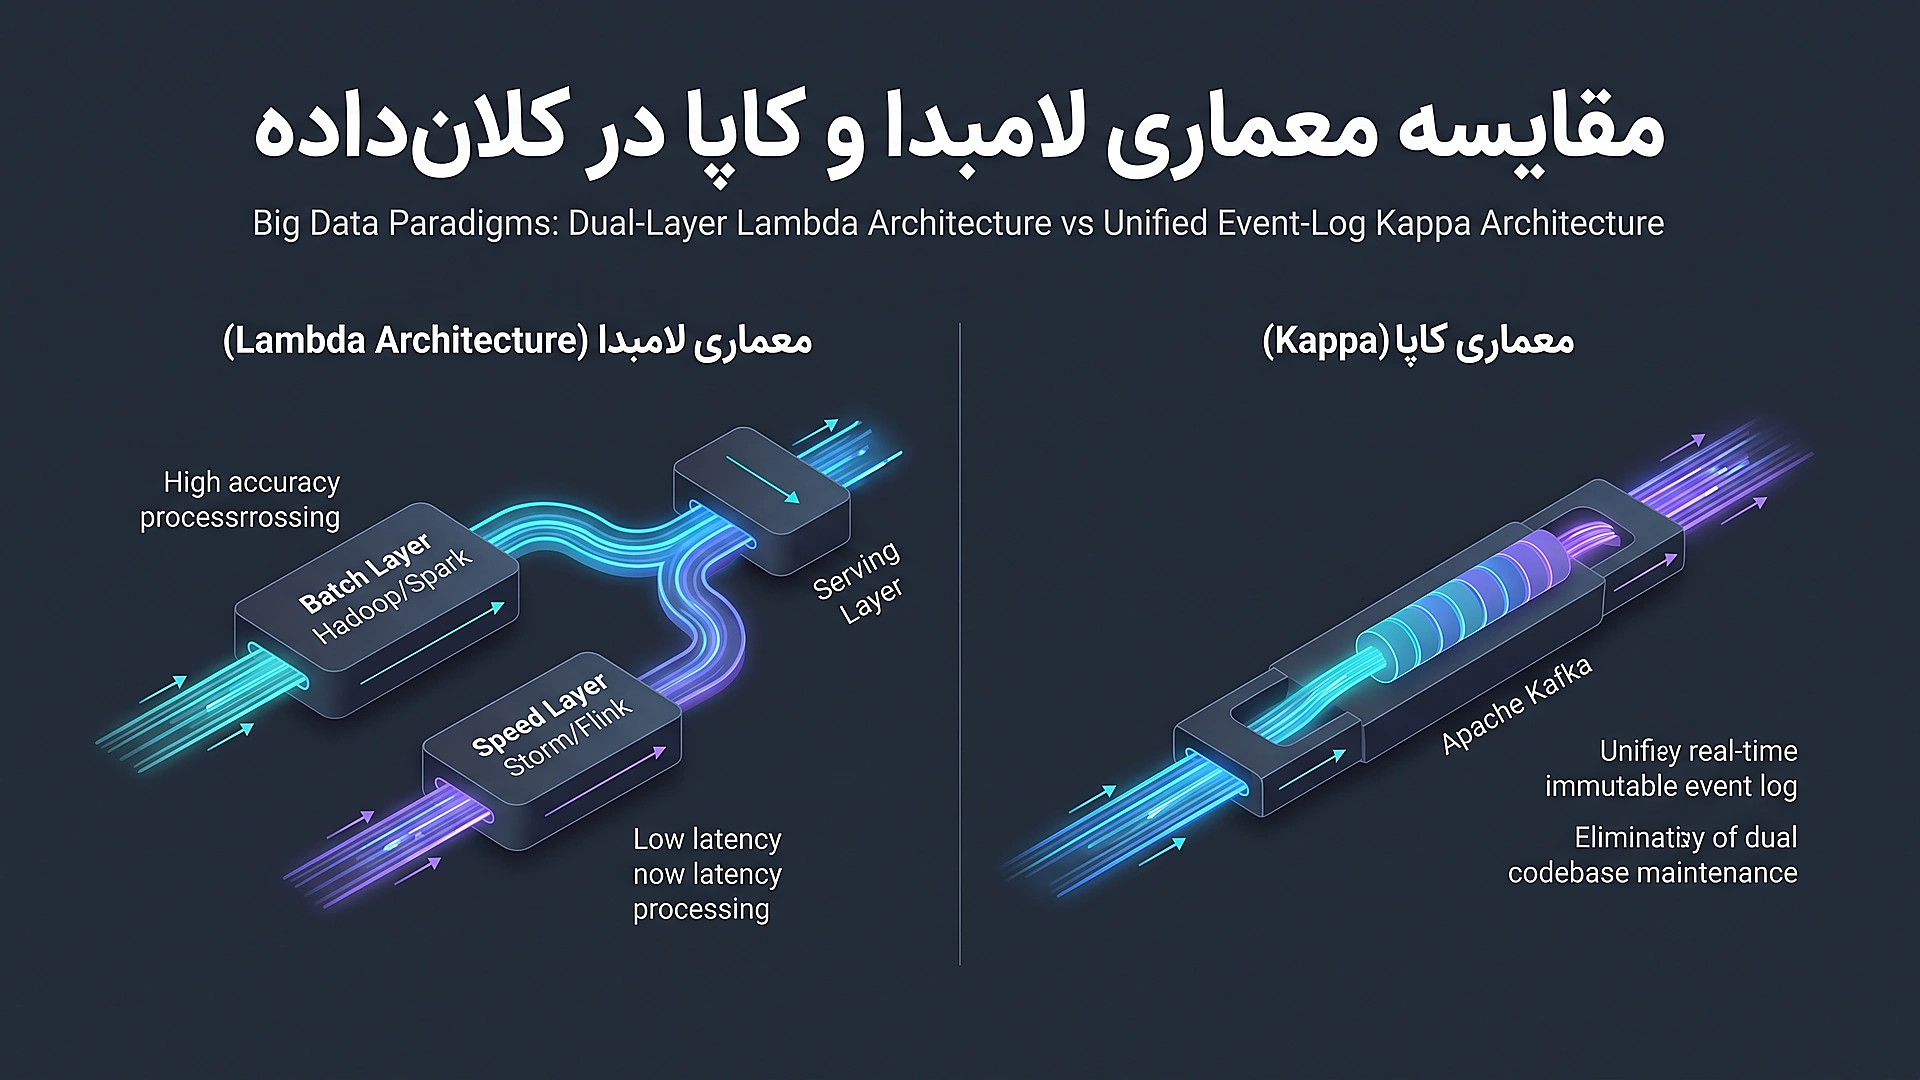
۱. پردازش دسته ای با مدل MapReduce و Spark
در سیستم های پردازش دستهای (Batch Processing)، ورودی ها مجموعه های کراندار (Bounded Datasets) هستند که در بازه های زمانی معین (مثلاً هر شب ساعت ۱۲) پردازش میشوند. موتورهایی مانند Apache Spark با بهینه سازی محاسبات در حافظه رم، حجم های ترابایتی را به صورت توزیع شده با عملگرهای تبدیل (Transformations) و تجمیع (Actions) پالایش میکنند. عیب ذاتی این مدل، تاخیر بالای آن در ارائه نتایج زنده است.
۲. پردازش جریانی و معماری کاپا (Kappa Architecture)
در نقطه مقابل، در پردازش جریانی (Stream Processing)، داده ها به صورت استریم های بیپایان و باز (Unbounded Streams) جریان دارند. ابزار هایی نظیر Apache Flink رویدادها را در لحظه ورود با تاخیر زیر ۱۰ میلیثانیه پردازش میکنند. مفاهیمی نظیر پنجره های زمانی (Tumbling, Sliding, Session Windows) و مفهوم زمان رخداد (Event Time) در برابر زمان پردازش (Processing Time) به سیستم ها اجازه میدهند حتی رویدادهایی که با تاخیر چنددقیقهای ناشی از قطعی شبکه موبایل میرسند را با دقت پردازش نمایند.
۳. تغییر داده به عنوان رویداد (Change Data Capture - CDC)
یکی از پیشرفتهترین الگو های داده محور، الگوی CDC با ابزار هایی نظیر Debezium است. به جای آنکه اپلیکیشن مستقیماً هم در دیتابیس بنویسد و هم پیام به صف ارسال کند (که خطر ناهماهنگی در تراکنش دوگانه را دارد)، دیتابیس تراکنش را ثبت میکند و موتور CDC لاگ باینری دیتابیس (WAL در PostgreSQL یا Binlog در MySQL) را خوانده و تغییرات را به صورت خودکار به صف کافکا پمپاژ میکند. این الگو پایه های معماری Event Sourcing و CQRS را تشکیل میدهد.
زمان، ساعت های منطقی و تراکنش های توزیع شده: از TrueTime تا الگوی Saga
در سیستم های توزیع شده، مفهوم «زمان» یکی از فریبندهترین متغیرهاست. هیچ ساعت فیزیکی مشترکی میان سرور های وجود ندارد و هر نود ساعت کوارتز داخلی خود را دارد که به دلیل تغییرات دما و فرکانس نوسان ساز، دچار انحراف روزانه چند میلیثانیهای (Clock Drift) میشود.
۱. ساعت های منطقی لامپورت و بردارهای نسخه (Lamport Timestamps & Vector Clocks)
از آنجا که نمیتوان به برچسب های زمانی ساعت های سخت افزاری تکیه کرد، لزلی لامپورت مفهوم ساعت های منطقی (Logical Clocks) را ابداع نمود. در ساعت لامپورت، هر نود یک شمارنده عددی ساده دارد که با هر رخداد محلی یکی به آن میافزاید و هنگام ارسال پیام به سایر نودها، مقدار شمارنده را ضمیمه پیام میکند. نود دریافتکننده ساعت خود را برابر max(local_clock, received_clock) + 1 قرار میدهد. این مکانیزم ترتیب علیتی (Causal Ordering) رویدادها را بدون نیاز به ساعت فیزیکی تضمین میکند. بردارهای نسخه (Vector Clocks) این مفهوم را به آرایهای از شمارنده ها برای هر نود تعمیم میدهند تا رخدادهای همزمان (Concurrent Events) که هیچ تقدم و تاخری نسبت به هم ندارند به دقت شناسایی شوند.
۲. معماری Google Spanner و رابط سخت افزاری TrueTime
شرکت گوگل برای حل مسئله ساعت در پایگاه داده جهانی Spanner، رویکرد متفاوتی را اتخاذ کرد: به جای پذیرش نادقیق بودن ساعت، دقت فیزیکی را به سطح فوق بشری ارتقا داد! گوگل در تمامی دیتاسنترهای خود گیرنده های ماهوارهای GPS و ساعت های اتمی فوقالعاده پایدار سزیم و روبیدیوم نصب کرد. رابط TrueTime API به جای برگرداندن یک زمان قطعی، بازه زمانی نامعلومی به شکل [earliest, latest] ارائه میدهد که تضمین میکند زمان واقعی قطعاً در این بازه قرار دارد (با خطایی کمتر از ۷ میلیثانیه). در صورت وجود شک، تراکنش به اندازه پهنای بازه خطا صبر میکند (Commit Wait) تا ترتیب زمانی تراکنش ها با اطمینان ۱۰۰ درصدی تضمین شود.
۳. تراکنش های دوفازی (۲PC) در برابر الگوی حماسه (Saga Pattern)
در سیستم های چندپایگاه دادهای، برای اجرای یک تراکنش میان چندین سرویس، پروتکل کلاسیک تعهد دو فازی (Two-Phase Commit - ۲PC) سال ها به کار گرفته میشد. در ۲PC یک هماهنگکننده (Coordinator) ابتدا از تمام سرویس های میپرسد که آیا آماده تعهد هستند (فاز Prepare) و در صورت پاسخ مثبت همگی، دستور ذخیره قطعی را صادر میکند (فاز Commit). عیب بزرگ ۲PC، مسدودکننده بودن آن (Blocking Protocol) است؛ اگر هماهنگکننده پس از فاز اول کرش کند، تمامی سرویس های قفل باقی میمانند و منابع سیستم آزاد نمیشوند.
در معماری های مدرن مایکروسرویس، الگوی Saga جایگزین ۲PC شده است. الگو های ساگا تراکنش سراسری را به مجموعهای از تراکنش های محلی کوچکتر تفکیک میکنند. هر تراکنش محلی دیتابیس خود را بهروزرسانی کرده و یک پیام یا رویداد به سرویس بعدی میفرستد. در صورت شکست در هر مرحله، سیستم تراکنش های جبرانی معکوس (Compensating Transactions) را به ترتیب اجرا میکند تا اثرات تغییرات قبلی به صورت منطقی خنثی شود.
جدول مقایسه جامع فناوری های ذخیره سازی داده در سیستم های توزیع شده
برای انتخاب زیرساخت دادهای مناسب در پروژه هایی مقیاس پذیر، ماتریس مقایسهای زیر پایگاه های داده مطرح را بر اساس ویژگی های کلیدی DDIA تحلیل میکند:
| نام سیستم | مدل داده | توپولوژی رپلیکیشن | استراتژی شاردینگ | پروتکل اجماع | بهترین سناریوی کاربرد |
|---|---|---|---|---|---|
| PostgreSQL | رابطهای (RDBMS) | Single-Leader (همگام/ناهمگام) | دستی یا با اکستنشن Citus | با ابزار هایی نظیر Patroni (Raft/etcd) | تراکنش های مالی، داده های ساختیافته |
| Apache Cassandra | Wide-Column (ستون محور) | Leaderless (سبک Dynamo) | Consistent Hashing با Murmur۳ | نصاب نصاب اکثریت (Quorum) | نوشتن های حجیم سنسورها، تحلیل اینترنت اشیا |
| MongoDB | سندمحور (BSON Document) | Replica Sets (تکرهبر خودکار) | Range یا Hashed بر روی Shard Key | پروتکل مبتنی بر Raft | کاتالوگ محصولات، داده های دارای اسکیما پویا |
| CockroachDB | Distributed SQL (NewSQL) | Multi-Raft بر روی هر رِنج داده | اتوماتیک Range-based Splitting | Raft Consensus یکپارچه | تراکنش های جهانی با مقیاس پذیری خطی |
| Apache Kafka | Log-centric Event Stream | Leader-Follower بر روی هر پارتیشن | Hash-based Partitioning بر روی Key | Kafka Raft (KRaft Metadata Mode) | گذرگاه رویدادها، خط لوله داده های بلادرنگ |
چک لیست طلایی پایداری در سیستم های توزیع شده
برای تضمین بقای یک سامانه توزیع شده زیر بارهای سنگین ترافیکی، مهندسان معمار باید چکلیست اقدامات پیشگیرانه زیر را پیاده سازی نمایند:
- پایانناپذیری درخواست ها با مهلت زمانی و تلاش مجدد نمایی (Timeouts & Exponential Backoff): هر فراخوانی شبکه از راه دور (RPC یا HTTP) باید مجهز به تایماوت سختگیرانه باشد. تکرار درخواست ها نباید در فواصل ثابت انجام شود؛ بلکه باید با ضریب نمایی همراه با تلاطم تصادفی (Jitter) ارسال گردد تا از ایجاد حمله منع سرویس خودی (Self-inflicted DDoS) جلوگیری شود.
- کلیدهای تکرارناپذیری (Idempotency Keys): شبکه غیرقابل اعتماد ممکن است درخواست پرداخت کاربر را اجرا کند اما پاسخ تاییدیه را در راه بازگشت گم کند. ارسال یک توکن یکتا (Idempotency Key) توسط کلاینت تضمین میکند که تراکنش در صورت ارسال مجدد، تنها یک بار در دیتابیس اعمال خواهد شد.
- الگوی مدارشکن (Circuit Breaker): در صورت بروز کندی در یک مایکروسرویس پاییندستی، سیستم باید بلافاصله جریان درخواست ها را قطع کرده و پاسخ پشتیبان (Fallback) ارائه دهد تا از انباشته شدن ریسمان ها و سرریز حافظه جلوگیری کند.
امتیاز و نظرات
هنوز نظری ثبت نشده است. اولین نفر باشید.