
در چشم انداز مهندسی نرم افزار مدرن، گذار از مدل های آزمایشگاهی به سرویس های مقیاس پذیر پروداکشن بزرگ ترین چالش تیم های داده است.
رشته تخصصی MLOps (Machine Learning Operations) پاسخی استاندارد و تکرارپذیر به این نیاز مبرم محسوب می شود.
بر اساس گزارش های گارتنر، بیش از ۸۰ درصد مدل های هوش مصنوعی بدون خطوط لوله MLOps هرگز عملیاتی نمی شوند یا در ماه های نخست به علت انحراف آماری داده ها (Data Drift) اعتبار تجاری خود را از دست می دهند.
همان طور که در تحلیل های پیشین پیرامون آموزش داکر از صفر تا پروداکشن و معماری کلاستر های مدرن در آموزش کوبرنتیز و معماری کلاستر بررسی شد، کانتینرسازی زیرساخت شرط لازم برای پایداری سرویس ها است؛ اما در دنیای هوش مصنوعی، تلاقی سه وجهی کد، داده و مدل نیازمند ابزار ها و خطوط لوله تخصصی است که حاکمیت داده و تکرارپذیری محاسبات را در بالاترین مقیاس تضمین کند.
۱. چرخه حیات اند-تو-اند MLOps: گذار از نوت بوک به پروداکشن سازمانی
تفاوت بنیادین سیستم های هوش مصنوعی با نرم افزارهای سنتی، وابستگی شدید به توزیع داده ها است. در سیستم های کلاسیک رفتار برنامه منحصرا از منطق سورس کد تبعیت می کند.
اما در یادگیری ماشین، تغییرات تدریجی رفتار کاربران می تواند بدون تغییر حتی یک خط کد، پیش بینی های مدل را مخدوش ساخته و تصمیمات کلان بیزینس را مختل نماید.
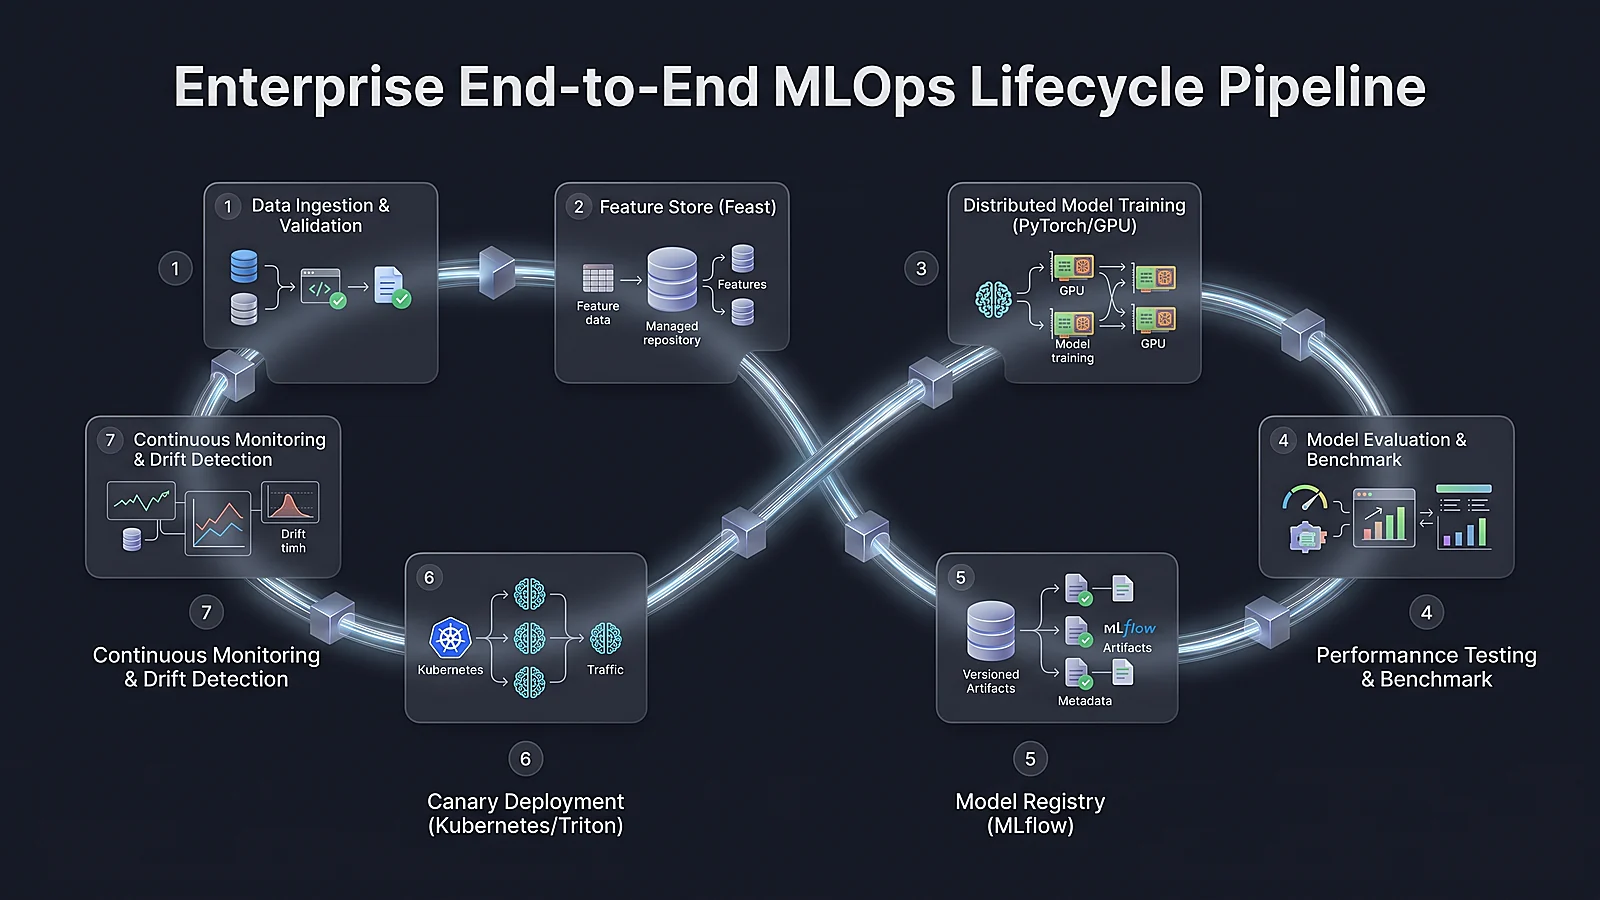
ارکان هفت گانه پایپ لاین پیوسته در معماری MLOps
برای دستیابی به یک خط لوله تمام خودکار که با استاندارد های سطح بلوغ MLOps گوگل (Level ۲ Continuous Training) هم خوانی داشته باشد، پیاده سازی ارکان هفت گانه زیر ضروری است:
- گردآوری و تایید صحت داده (Data Validation & Ingestion): دریافت داده ها از پایگاه های داده عملیاتی و استریم های آپاچی کافکا، بررسی توزیع آماری و کشف ناهنجاری های طرح واره (Schema Anomalies) با استفاده از ابزار هایی چون Great Expectations یا TensorFlow Data Validation.
- انبار ویژگی ها (Feature Store): ذخیره سازی متمرکز و استاندارد بردار های ویژگی (Features) برای جلوگیری از دوباره کاری و هم سو سازی کامل فرآیند های آموزش و استنتاج برخط.
- پایپ لاین آموزش توزیع شده (Distributed Training Pipeline): اجرای مراحل پیش پردازش و برازش مدل بر روی کلاستر های پردازش گرافیکی (GPU Clusters) به وسیله Kubeflow یا Ray Train.
- ارزیابی کیفی و دروازه های تایید (Model Evaluation Gates): سنجش سنجه های آماری (Accuracy, Precision, Recall, ROC-AUC) بر روی داده های تست خارج از توزیع و تضمین عدم سوگیری آماری (Fairness & Bias Mitigation).
- رجیستری مدل و شناسنامه متادیتایی (Model Registry & Lineage): نسخه بندی سفت و سخت وزن های مدل، هش گیت سورس کد، هش داده های آموزش و نگاشت دقیق پارامتر های هایپر با ابزار MLflow.
- سرو کانتینری و استنتاج بهینه (Optimized Serving): کامپایل گراف های محاسباتی به فرمت های ONNX یا TensorRT و استقرار روی سرور های با کارایی فوق بالا نظیر Triton Inference Server یا vLLM.
- پایش بلادرنگ و تریگر بازآموزی (Drift Monitoring & Feedback Loop): رهگیری انحراف داده ها (Data Drift) و انحراف مفهومی (Concept Drift) در ترافیک زنده و صدور سیگنال بازآموزی خودکار (Continuous Retraining).
۲. معماری Feature Store: پایان تناقض آموزش و سرویس دهی (Training-Serving Skew)
معضل پنهان و مخرب Training-Serving Skew زمانی رخ می دهد که ویژگی های زمان آموزش آفلاین، با ویژگی های زمان پاسخگویی زنده وب سرویس تفاوت محاسباتی داشته باشند.
حتی ناهماهنگی های کوچک در فرمت زمان یا شیوه پر کردن مقادیر تهی، منجر به پیش بینی های فاجعه بار مدل در محیط عملیاتی می گردد.
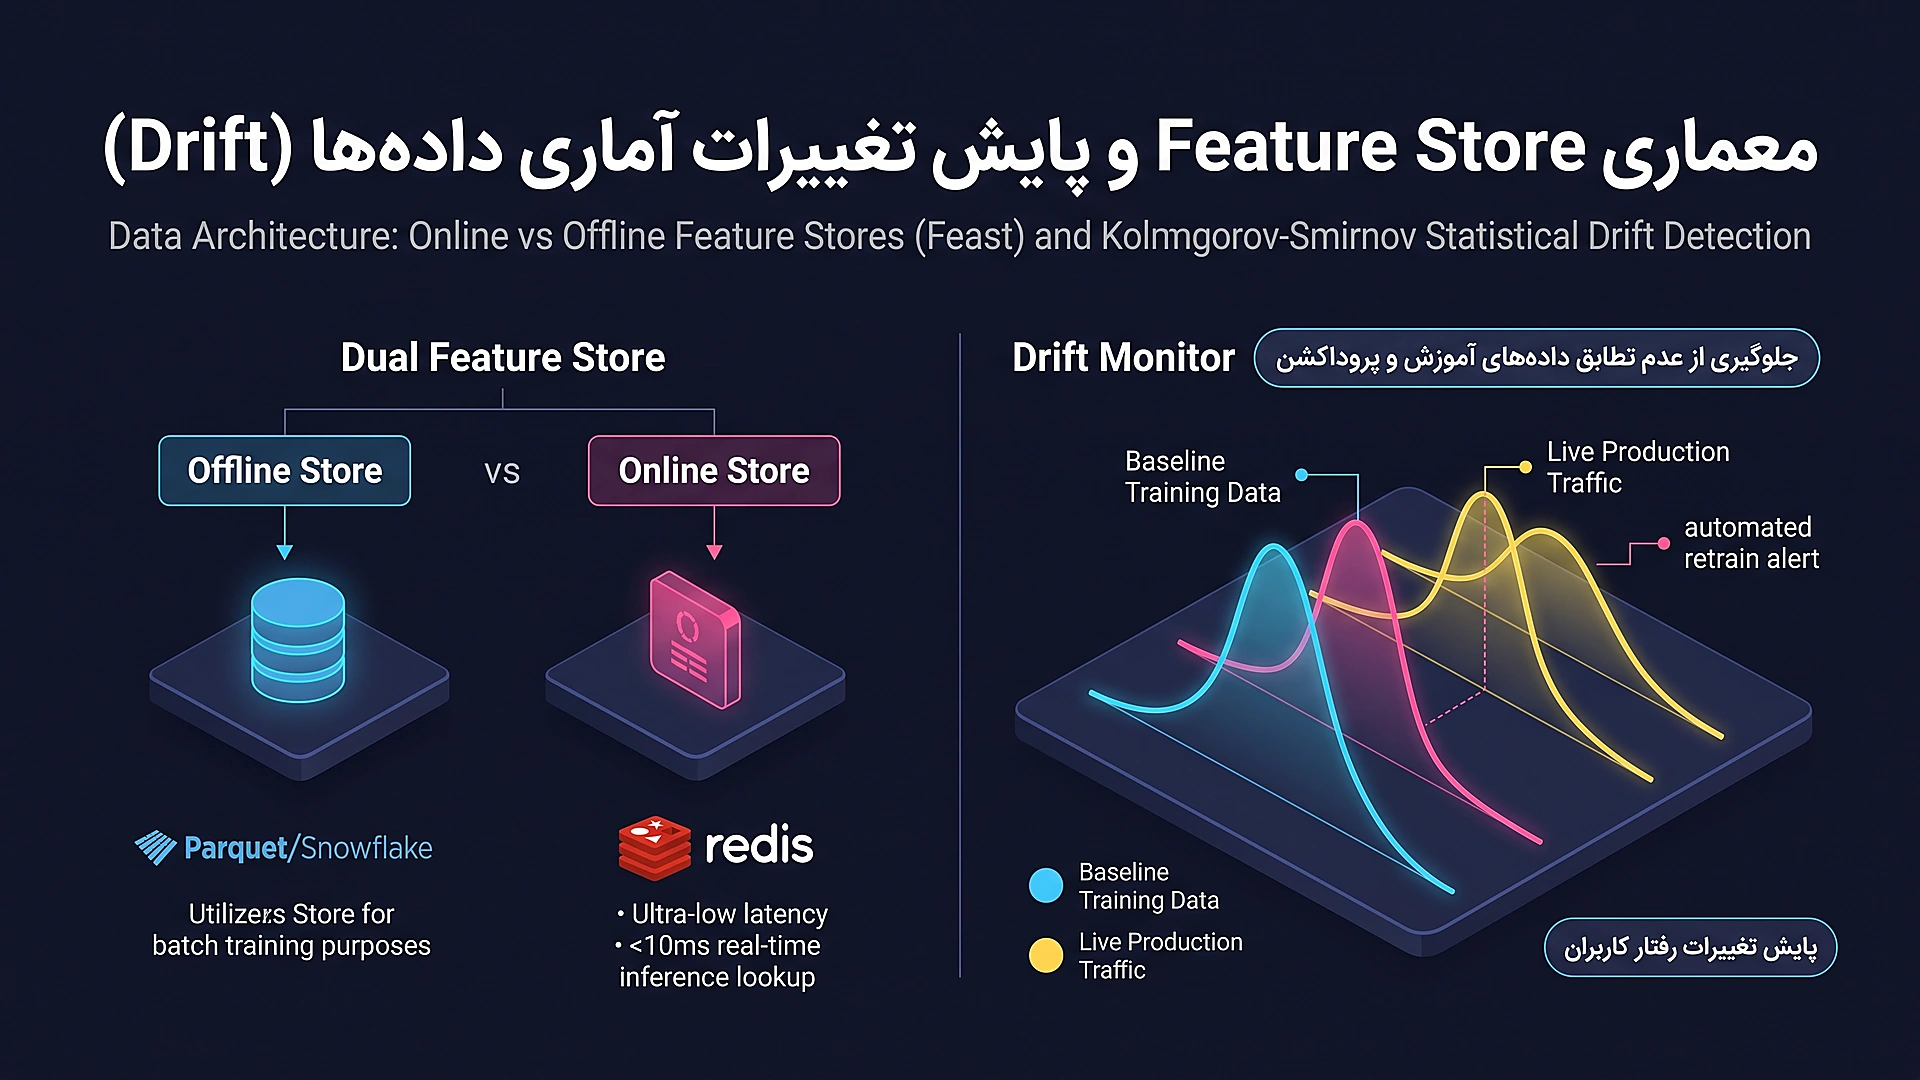
معماری دوگانه انبار ویژگی ها (Dual Storage Engine)
یک Feature Store سازمانی مدرن (نظیر Feast یا Hopsworks) از دو موتور ذخیره سازی مجزا برای پاسخ گویی به نیاز های متفاوت استفاده می کند:
- انبار آفلاین (Offline Store): پایگاه های داده تحلیلی ستونی نظیر Apache Parquet، Snowflake، ClickHouse یا Delta Lake. وظیفه اصلی این لایه نگه داری میلیارد ها رکورد تاریخی و ارائه قابلیت «سفر در زمان» (Time-Travel / Point-in-Time Correctness) است تا ویژگی ها دقیقا با همان مقداری که در لحظه وقوع تراکنش داشته اند برای آموزش استخراج شوند و معضل نشت داده (Data Leakage) رخ ندهد.
- انبار برخط (Online Store): پایگاه های داده کلید-مقدار فوق سریع درون حافظه نظیر Redis یا Cassandra. این لایه آخرین بردار ویژگی هر موجودیت (Entity) را نگه داری می کند و در زمان فراخوانی API استنتاج، ویژگی ها را با تاخیر زمانی زیر ۵ میلی ثانیه در اختیار مدل قرار می دهد.
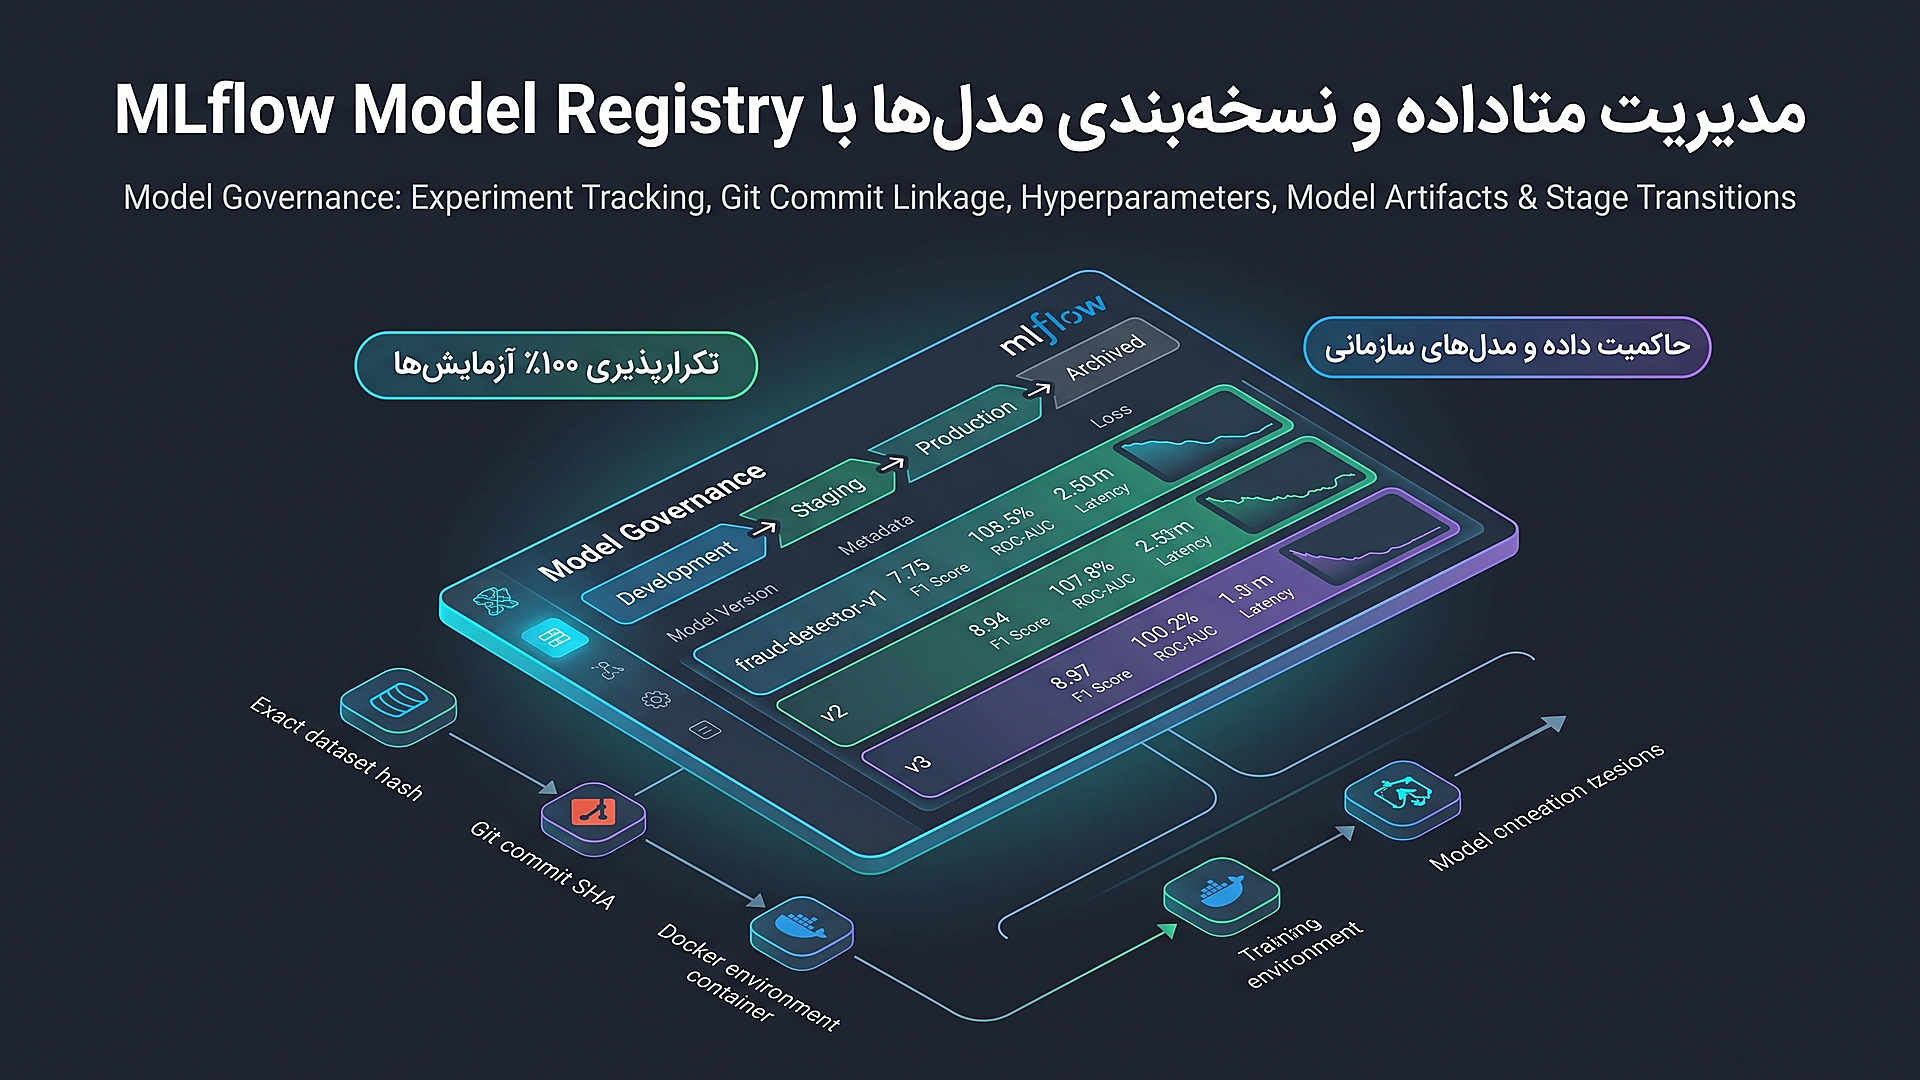
۳. تکرارپذیری ۱۰۰ درصدی: نسخه بندی چندگانه با DVC و MLflow Model Registry
در مهندسی سنتی، دستور git checkout <commit-hash> وضعیت کامل نرم افزار را بازسازی می کند. اما در هوش مصنوعی، کامپایل مجدد یک کد با دیتاستی که هفته گذشته تغییر کرده، مدلی کاملا متفاوت تولید خواهد کرد. بنابراین تکرارپذیری علمی و فنی مستلزم نسخه بندی هم زمان سه مولفه زیر است:
- کد و هایپرپارامترها: در سیستم کنترل نسخه گیت نگه داری می شوند.
- دیتاست ها و پایپ لاین های پیش پردازش: توسط ابزار DVC (Data Version Control) مدیریت می گردند. DVC فایل های چند ده گیگابایتی داده را در فضای ابری (S۳ یا MinIO) نگه داری کرده و صرفا هش های متنی
.dvcرا به کامیت های گیت الصاق می نماید. - آرتیفکت های باینری و متادیتای آموزش: در سرور مرکزی MLflow Model Registry به همراه لاگ سنجه ها ثبت می شوند.
نمونه کد پایتون: پیاده سازی خط لوله ثبت رسمی مدل در MLflow
قطعه کد زیر ساختار استاندارد اجرای آزمایش، استخراج سنجه های کلیدی و انتشار مدل تایید شده در رجیستری را نشان می دهد:
import mlflow
import mlflow.sklearn
from sklearn.metrics import f1_score, roc_auc_score

def register_enterprise_model(model, X_val, y_val, hyperparams, run_name="fraud_v2"):
    mlflow.set_tracking_uri("http://mlflow.internal.net:5000")
    mlflow.set_experiment("Production_Fraud_Engine")

    with mlflow.start_run(run_name=run_name) as run:
        # پیش بینی و ارزیابی سنجه ها
        predictions = model.predict(X_val)
        probs = model.predict_proba(X_val)[:, 1]

        f1 = f1_score(y_val, predictions)
        auc = roc_auc_score(y_val, probs)

        # لاگ پارامتر ها و خروجی های تحلیلی
        mlflow.log_params(hyperparams)
        mlflow.log_metric("f1_score", f1)
        mlflow.log_metric("roc_auc", auc)

        # ثبت مدل به همراه امضای ورودی و خروجی
        mlflow.sklearn.log_model(
            sk_model=model,
            artifact_path="model",
            registered_model_name="FraudDetectionModel"
        )
        print("Model successfully logged to MLflow Registry. Run ID:", run.info.run_id)
        return run.info.run_id
۴. مقایسه تخصصی ابزار های اکوسیستم MLOps در محیط های ابری و بومی
انتخاب ابزار مناسب در معماری MLOps به اندازه طراحی الگوریتم های یادگیری اهمیت دارد. استفاده از ابزار های بیش از حد پیچیده برای تیم های کوچک هزینه های عملیاتی را سرسام آور می کند، در حالی که فقدان ابزار های استاندارد در شرکت های بزرگ موجب سردرگمی و عدم پاسخ گویی تیم ها می گردد.
| حوزه عملیاتی | ابزار پیشتاز | نوع معماری | مزیت اصلی رقابتی | هزینه راه اندازی و پیچیدگی |
|---|---|---|---|---|
| ردیابی آزمایش و رجیستری | MLflow | متن باز / سرویس ابری | یکپارچگی بی نظیر با پایتون و استقلال از زیرساخت | متوسط (نصب با داکر و پایگاه داده) |
| نسخه بندی دیتاست | DVC (Data Version Control) | متن باز (Git-Integrated) | اتصال سفت و سخت نسخه داده به کامیت های گیت | پایین (استفاده از CLI و استوریج S۳) |
| انبار ویژگی ها | Feast / Hopsworks | موتور دوگانه (Dual Store) | حل قطعی خطای Training-Serving Skew با زمان صفر | متوسط تا بالا (نیازمند ردیس و کلیک هاوس) |
| ارکستراسیون پایپ لاین | Kubeflow Pipelines / Airflow | DAG مبتنی بر کانتینر کوبرنتیز | مدیریت توزیع شده منابع سرور و کش نتایج گام ها | بالا (نیازمند کلاستر عملیاتی کوبرنتیز) |
| سرو با تاخیر فوق پایین | Triton / vLLM / TorchServe | موتور استنتاج موازی چندمدلی | دسته بندی پویا (Dynamic Batching) بر بستر GPU | متوسط (تنظیم دقیق کانفیگ موتور های C++) |
| پایش انحراف (Drift Monitoring) | Evidently AI / Prometheus | تحلیل آماری سری زمانی | تشخیص زودهنگام افول دقت مدل بدون لیبل واقعی | پایین تا متوسط (پایش لاگ های استنتاج) |
۵. معماری لایه سرو استنتاج: شتاب دهی محاسبات با Triton و موتور ONNX Runtime
سرو مدل های یادگیری ماشین به وسیله فریم ورک های وب متداول نظیر Flask یا FastAPI، برای مقیاس های پرترافیک با بن بست های سنگین مواجه می شود. وب سرور های پایتون به دلیل قفل سراسری مفسر (GIL)، مصرف بالای رم و ناتوانی در مدیریت هم زمان صد ها صف استنتاج، تاخیر های ناپایداری ایجاد می کنند.
تکنیک های شتاب دهی استنتاج در مقیاس بالا
برای کاهش تاخیر استنتاج از ۲۰۰ میلی ثانیه به زیر ۱۵ میلی ثانیه و افزایش توان گذردهی سیستم (Throughput) تا ۱۰ برابر، مهندسان MLOps از راهکار های فنی زیر بهره می گیرند:
- تبدیل به ONNX (Open Neural Network Exchange): مدلی که در PyTorch یا TensorFlow آموزش دیده، به فرمت میانی استاندارد ONNX کامپایل می شود تا گراف محاسباتی آن مستقل از مفسر پایتون و با باینری های بهینه شده C++ اجرا گردد.
- کوانتیزاسیون اعداد اعشاری (Quantization): تبدیل وزن های ۳۲ بیتی (FP۳۲) به ۱۶ بیتی (FP۱۶) یا اعداد صحیح ۸ بیتی (INT۸). این کار حجم مصرف حافظه پردازنده گرافیکی را تا ۷۵ درصد کاهش داده و سرعت اجرای ضرب ماتریس ها را روی هسته های Tensor Core انویدیا چندین برابر می کند.
- دسته بندی پویا (Dynamic Batching): اگر ۱۰۰ کاربر در فاصله ۵ میلی ثانیه درخواست های مجزا ارسال کنند، سرور Triton این درخواست ها را در قالب یک بچ واحد ترکیب کرده و در یک پالس ساعت GPU پردازش می نماید. این رویکرد نرخ بهره وری کارت های گرافیک گران قیمت را از ۲۰ درصد به بالای ۹۰ درصد می رساند.
- ترکیب لایه ها (Layer Fusion): ادغام لایه های متوالی مانند Convolution، Bias Add و ReLU در یک عملیات واحد سخت افزاری تا دفعات خواندن و نوشتن روی حافظه رم VRAM به حداقل برسد.
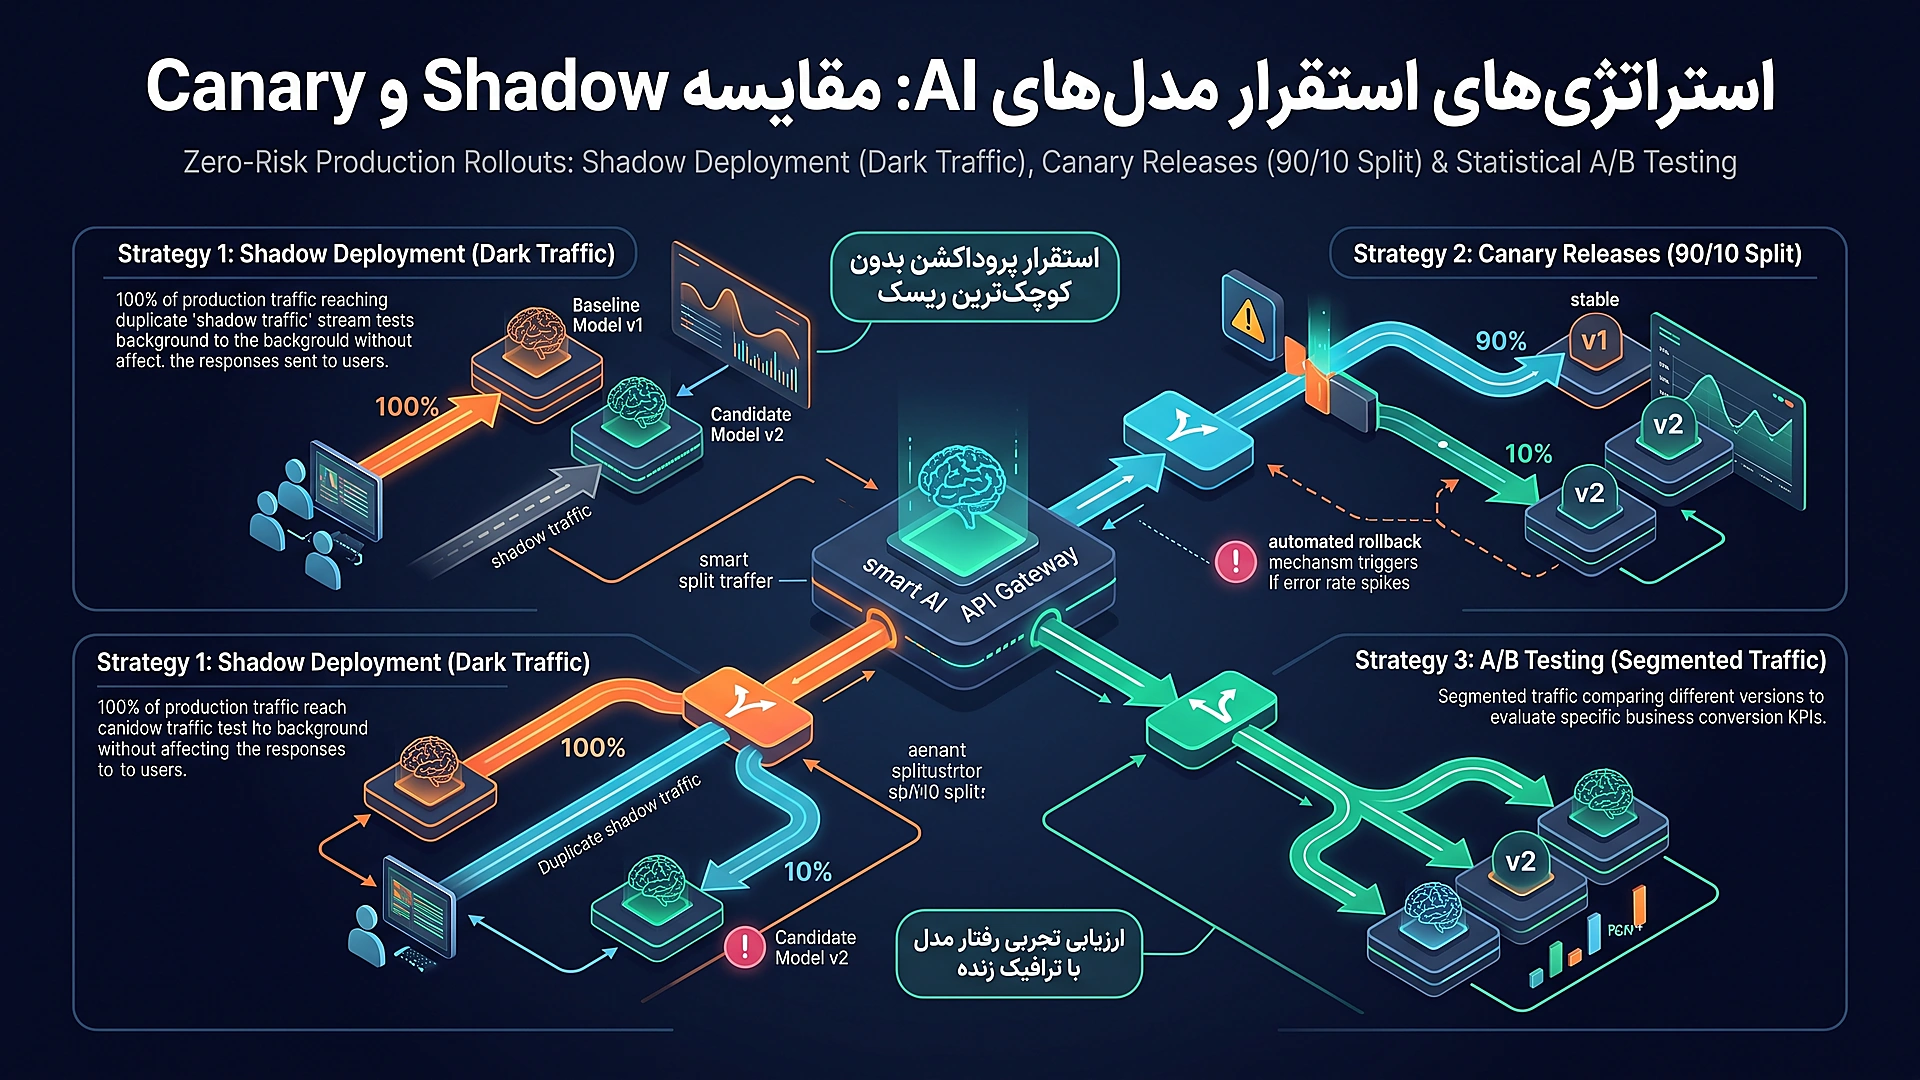
۶. الگو های استقرار عملیاتی مدل: استقرار سایه، آزمون قناری و A/B Testing
جایگزینی مستقیم مدل هوش مصنوعی قدیمی با نسخه جدید در یک جهش ناگهانی (Big-Bang Release)، ریسک فاجعه باری در سیستم های پرترافیک به همراه دارد. مدل جدید ممکن است در تست های ارزیابی دقت بالاتری نشان داده باشد، اما در مواجهه با رفتار نامتعارف کاربران دنیای واقعی با خطاهای پیش بینی نشده روبه رو شود.
۱. استقرار در حالت سایه (Shadow Deployment)
در الگوی استقرار سایه، ترافیک ورودی به صورت هم زمان برای مدل جاری و مدل جدید ارسال می گردد. خروجی مدل جدید صرفا در دیتابیس لاگ شده و کاربر تنها پاسخ مدل پایدار را مشاهده می کند.
مزیت بزرگ این رویکرد ریسک عملیاتی صفر مطلق است؛ زیرا رفتار مدل جدید تحت بار ترافیک واقعی پروداکشن ارزیابی می شود بدون آنکه خطایی متوجه تجربه کاربر شود.
۲. استقرار قناری (Canary Deployment)
پس از تایید پایداری مدل در حالت سایه، ترافیک واقعی به تدریج به مدل جدید هدایت می شود. به عنوان مثال، در گام نخست تنها ۵ درصد درخواست ها به مدل قناری ارسال شده و ۹۵ درصد همچنان به مدل قدیمی می روند. با مانیتورینگ نرخ خطاها، در صورت نبود مشکل این نسبت به ۲۵ درصد، ۵۰ درصد و در نهایت ۱۰۰ درصد افزایش می یابد.
۳. تست تصادفی A/B و سنجه های تجاری (Business A/B Testing)
در سناریو هایی مانند موتور های پیشنهاد دهنده محصولات، معیار برتری مدل سنجه های آماری دقت نیست، بلکه رفتار خرید کاربران است. در تست A/B، ترافیک کاربران به صورت تصادفی دو قسمت شده و شاخص های کلیدی کسب و کار نظیر نرخ تبدیل (Conversion Rate)، ارزش سبد خرید و نرخ کلیک در یک بازه زمانی دوهفته ای مورد مقایسه آماری قرار می گیرند.
۷. مانیتورینگ پروداکشن: مهار انحراف داده ها (Data Drift) و انحراف مفهومی (Concept Drift)
در نرم افزارهای سنتی، کد وضعیت HTTP ۲۰۰ و تاخیر کم نشانه سلامت سیستم است. اما در یادگیری ماشین، مدل ممکن است با تاخیر ۵ میلی ثانیه پاسخ دهد اما تمام پیش بینی های آن کاملا بی ربط باشند!
این افت خاموش کارایی بر اثر دو عامل انحراف آماری رخ می دهد:
- انحراف داده ها (Data Drift / Covariate Shift): توزیع آماری ویژگی های ورودی بدون تغییر در رابطه ورودی و خروجی دگرگون می شود. به عنوان نمونه، ورود ناگهانی گروه سنی متفاوتی از کاربران به اپلیکیشن که الگو های درآمدی متفاوتی نسبت به جامعه نمونه آموزش دارند.
- انحراف مفهومی (Concept Drift): رابطه ریاضی میان ویژگی های ورودی و برچسب های هدف تغییر می کند. به عنوان مثال، در دوران بحران های اقتصادی یا تغییر قوانین مالیاتی، رابطه میان درآمد و ریسک اعتباری به کلی دگرگون می شود؛ در این شرایط داده های ورودی مشابه با گذشته رفتاری کاملا متفاوت از خروجی نشان می دهند.
تکنیک های آماری تشخیص انحراف بدون نیاز به برچسب های واقعی
در پروداکشن، برچسب های واقعی (True Labels) غالبا با تاخیر زمانی طولانی (هفته ها یا ماه ها) به دست می آیند. بنابراین پایشگر های MLOps باید تغییرات را صرفا از روی ویژگی های ورودی استنتاج کنند:
- آزمون کولموگروف-اسمیرنوف (Kolmogorov-Smirnov Test): آزمونی ناپارامتری برای مقایسه توابع توزیع تجمعی ویژگی های پیوسته در بازه جاری نسبت به بازه مبنای آموزش. اگر مقدار p-value کمتر از ۰.۰۵ شود، فرض یکسانی توزیع ها رد می شود.
- شاخص پایداری جمعیت (Population Stability Index - PSI): سنجه ای استاندارد در صنایع بانکی برای سنجش میزان جابه جایی توزیع امتیازات. مقدار PSI بالای ۰.۲۵ به منزله انحراف بحرانی داده ها بوده و مستلزم توقف سرویس و بازآموزی فوری است.
- فاصله واسترشتاین (Wasserstein Distance / Earth Mover's Distance): محاسبه حداقل کار لازم برای تبدیل توزیع هندسی داده های ورودی زنده به توزیع داده های مرجع در فضای چندبعدی.
۸. استراتژی جامع تست در MLOps: از تست واحد داده تا آزمون های رفتاری مدل
کیفیت نرم افزار های هوش مصنوعی را نمی توان صرفا با تست های واحد کد تامین نمود؛ در یک معماری بالغ MLOps چهار لایه تست مستقل به شرح زیر پیاده سازی می گردد:
- تست های یکپارچگی داده (Data Integrity Tests): اعتبارسنجی مقادیر گمشده (Nulls)، بررسی رعایت دامنه مجاز متغیرها (Min/Max Constraints) و انطباق انواع داده با اسکیمای مورد انتظار. ابزار هایی مانند Great Expectations این تست ها را به عنوان گیت پیش از آموزش اجرا می کنند.
- تست های رفتاری مدل (Behavioral Model Testing): آزمون های جعبه سیاه مبتنی بر سناریو های خاص. آزمون های جهت دار (Directional Expectation Tests) بررسی می کنند که آیا با افزایش متغیر ریسک، احتمال پذیرش وام کاهش می یابد یا خیر؛ آزمون های پایداری (Invariance Tests) بررسی می کنند که تغییر متغیر های بی اثر مانند نام کوچک کاربر تاثیری در خروجی نداشته باشد.
- تست های کارایی و بارگذاری سخت افزاری (Inference Benchmark Tests): سنجش توان عملیاتی، تاخیر در چارک های ۹۹ درصدی (P۹۹ Latency) و مصرف حافظه رم کارت های گرافیک تحت بار هم زمان هزاران درخواست در ثانیه.
- تست های رگرسیون کیفی (Quality Regression Tests): مقایسه عملکرد مدل کاندید با نسخه مستقر جاری روی مجموعه داده ای از نمونه های حیاتی (Golden Test Set) تا اطمینان حاصل شود که اصلاح یک باگ باعث تخریب پیش بینی های پیشین نشده است.
همان طور که در معماری و پیاده سازی RAG در سیستم های هوش مصنوعی تشریح شد، ارزیابی کیفیت خروجی سیستم های هوشمند نیازمند شاخص های ترکیبی ریاضی و رفتاری است.
ایجاد پایپ لاین های تست خودکار به مهندسان اطمینان می دهد که مدل های جدید در تمامی شرایط لبه ای، عملکرد پایداری از خود نشان خواهند داد.
۹. حاکمیت، امنیت داده و انطباق قانونی در چرخه حیات هوش مصنوعی سازمانی
سیستم های MLOps به دلیل پردازش مقادیر عظیمی از داده های محرمانه کاربران با الزامات امنیتی و قانونی سخت گیرانه ای روبه رو هستند. پیاده سازی الزامات استاندارد های بین المللی مانند GDPR و چارچوب امنیتی AI Risk Management مستلزم اتخاذ تدابیر زیر است:
- حفظ حریم خصوصی تفاضلی (Differential Privacy): افزودن نویز های آماری کنترل شده به داده های آموزش جهت جلوگیری از بازسازی هویت اشخاص حقیقی از طریق حملات معکوس سازی مدل (Model Inversion Attacks).
- گمنام سازی و برچسب زدایی خودکار (Data Anonymization): پاک سازی داده های حساس هویتی (PII) در همان گام ابتدایی پایپ لاین پیش پردازش و ذخیره داده های پالایش شده در انبار ویژگی ها.
- ردیابی زنجیره تامین مدل (AI Bill of Materials - AIBOM): مستندسازی دقیق کلیه کتابخانه های متن باز، نسخه پایتون، هش داکر ایمیج و مبدا دیتاست ها به منظور تضمین امنیت سایبری در برابر حملات مسموم سازی مدل (Data Poisoning) و در های پشتی (Backdoors).
- کنترل دسترسی مبتنی بر نقش (RBAC) در رجیستری: محدود ساختن صلاحیت ارتقای مدل به محیط پروداکشن صرفا به مهندسان ارشد MLOps و مدیران کنترل کیفیت محصول به همراه ثبت وقایع ممیزی غیرقابل تغییر (Immutable Audit Trails).
- ارزیابی اخلاقی و عدالت الگوریتمی (Fairness & Bias Auditing): سنجش مستمر برابری آماری پیش بینی ها در میان گروه های مختلف کاربران و مستندسازی اثرات تصمیم گیری مدل ها در کارت های شناسنامه مدل (Model Cards) جهت پاسخ گویی شفاف به نهاد های نظارتی.
۱۰. پرسش های متداول در زمینه مهندسی MLOps و معماری خطوط لوله هوش مصنوعی
۹. ماتریس مقایسه الگو های استقرار و ارزیابی مدل در محیط های تولیدی
انتخاب استراتژی استقرار بهینه در مهندسی MLOps رابطه مستقیمی با حساسیت داده ها، هزینه محاسباتی GPU و ریسک خطای مدل در تجربه کاربری دارد.
| روش استقرار | ریسک عملیاتی | سربار منابع سرور | سرعت بازخورد واقعی | بهترین سناریوی کاربرد |
|---|---|---|---|---|
| استقرار سایه (Shadow) | صفر مطلق | ۱۰۰٪ اضافه (تکرار محاسبات) | متوسط تا بالا | مدل های حساس مالی و اعتبارسنجی های حیاتی |
| استقرار قناری (Canary) | بسیار پایین (محدود به درصد کم) | ناچیز (متناسب با ترافیک هدایت شده) | فوق العاده سریع | سرویس های پرترافیک با قابلیت مانیتورینگ بلادرنگ |
| آزمون تصادفی (A/B Testing) | کنترل شده و محاسبه شده | ناچیز | وابسته به حجم نمونه آماری | مدل های ریکامندر و بهینه سازی نرخ تبدیل فروش |
| الگوی Multi-Armed Bandit | حداقل سازی ضرر تجاری | ناچیز (تخصیص پویا بر اساس بازده) | بلادرنگ و انطباقی | تبلیغات کلیکی و قیمت گذاری پویای آنلاین |
همان طور که در جدول بالا تشریح شد، تیم های پیشرو در بارهای کاری به شدت حساس ابتدا از استقرار سایه برای سنجش تاخیر سخت افزاری و پایداری کلاستر استفاده می کنند و سپس مدل را وارد استقرار قناری تدریجی می نمایند.
توصیه معمارانه در مدیریت کلاستر های Kubernetes و KServe
استفاده از کوبرنتیز و KServe در کنار ابزار های کانتینرسازی استاندارد، امکان مقیاس پذیری خودکار از صفر (Scale-to-Zero) برای مدل های کم ترافیک و تخصیص بهینه منابع GPU را برای سازمان ها به ارمغان می آورد.
۱۰. مکانیزم های بازگشت خودکار (Automated Rollback) در رخداد انحراف های بحرانی
یک پایپ لاین بالغ MLOps هرگز متکی به مداخله دستی مهندسان در هنگام رخداد بحران های عملکردی نیست. سامانه های نظارتی پیوسته فاصله واسرستین (Wasserstein Distance) و آزمون کولموگروف-اسمیرنوف (KS-Test) را روی توزیع فیچرها محاسبه می نمایند.
در صورتی که انحراف آماری از آستانه امن عبور کند، ترافیک استنتاج به صورت خودکار ظرف کمتر از چند ثانیه به نسخه پایدار پیشین (Fall-back Model) هدایت می شود و هم زمان یک تسک بازآموزی خودکار در خط لوله فعال می گردد.
یکپارچه سازی متریک های توزیع داده با ابزار های مانیتورینگ Prometheus و داشبوردهای Grafana، دید جامعی از سلامت آماری ویژگی ها و نرخ افت دقت مدل در گذر زمان برای مهندسان فراهم می آورد.
هشدار در خصوص بازآموزی با داده های آلوده (Feedback Loop Poisoning)
در مدل های بازآموزی خودکار، باید فیلترهای اعتبارسنجی سختی برای پاکسازی داده های ورودی اعمال شود تا از بازخورد رفتارهای ساختگی یا خطاهای گذرا در وزن های مدل جلوگیری شود.
۱۱. پیاده سازی خط لوله CI/CD/CT با Kubeflow Pipelines و گیت هاب اکشنز
در یک معماری پروداکشن بالغ، فرآیند آموزش و بازآموزی مدل ها به صورت تسک های مجزا در بستر Kubeflow Pipelines تعریف می شوند. هر مرحله نظیر استخراج داده، اعتبارسنجی مقادیر، آموزش، و ارزیابی نهایی در قالب کانتینر های مستقل اجرا می گردد.
با پیاده سازی وب هوک های گیت هاب اکشنز، هرگونه تغییر در سورس کد یا ثبت دیتاست جدید، پایپ لاین CT را فراخوانی می کند. در صورت احراز معیارهای کیفی، مدل جدید به صورت خودکار به Model Registry ارسال شده و برای استقرار مرحله ای آماده می شود.
مزیت جداسازی پایپ لاین آموزش از سرویس دهی
جداسازی زیرساخت محاسباتی آموزش (GPU-Heavy) از زیرساخت سرویس دهی (Latency-Critical)، هزینه های ابری سازمان را تا ۴۰ درصد کاهش داده و از تاثیر بار محاسباتی آموزش بر زمان پاسخگویی به کاربران نهایی جلوگیری می کند.
تفاوت بنیادین میان DevOps و MLOps چیست؟
نقش Feature Store در خطوط لوله هوش مصنوعی چیست و چه زمانی به آن نیاز داریم؟
چرا ابزار هایی مانند DVC برای داده ها استفاده می شوند و از گیت به تنهایی استفاده نمی کنیم؟
تفاوت Data Drift و Concept Drift چیست و چگونه شناسایی می شوند؟
سرور استنتاج Triton نسبت به وب فریم ورک های سنتی مانند FastAPI چه برتری هایی دارد؟
استقرار سایه (Shadow Deployment) چگونه از شکست های پروداکشن جلوگیری می کند؟
سطح بلوغ MLOps Level ۲ به چه معناست؟
نقش کوبرنتیز در پایپ لاین های MLOps چیست؟
جمع بندی: نقشه راه تثبیت برتری پایدار با استقرار خودکار هوش مصنوعی
موفقیت استراتژی هوش مصنوعی با خروجی نوت بوک های تحقیقاتی سنجیده نمی شود، بلکه ملاک واقعی، پایداری و بازآموزی سریع مدل ها در پروداکشن است.
با معماری استاندارد MLOps، نسخه بندی داده ها و رصد پیوسته انحراف آماری، ریسک های سرمایه گذاری هوش مصنوعی به صفر می رسد.
امتیاز و نظرات
هنوز نظری ثبت نشده است. اولین نفر باشید.