
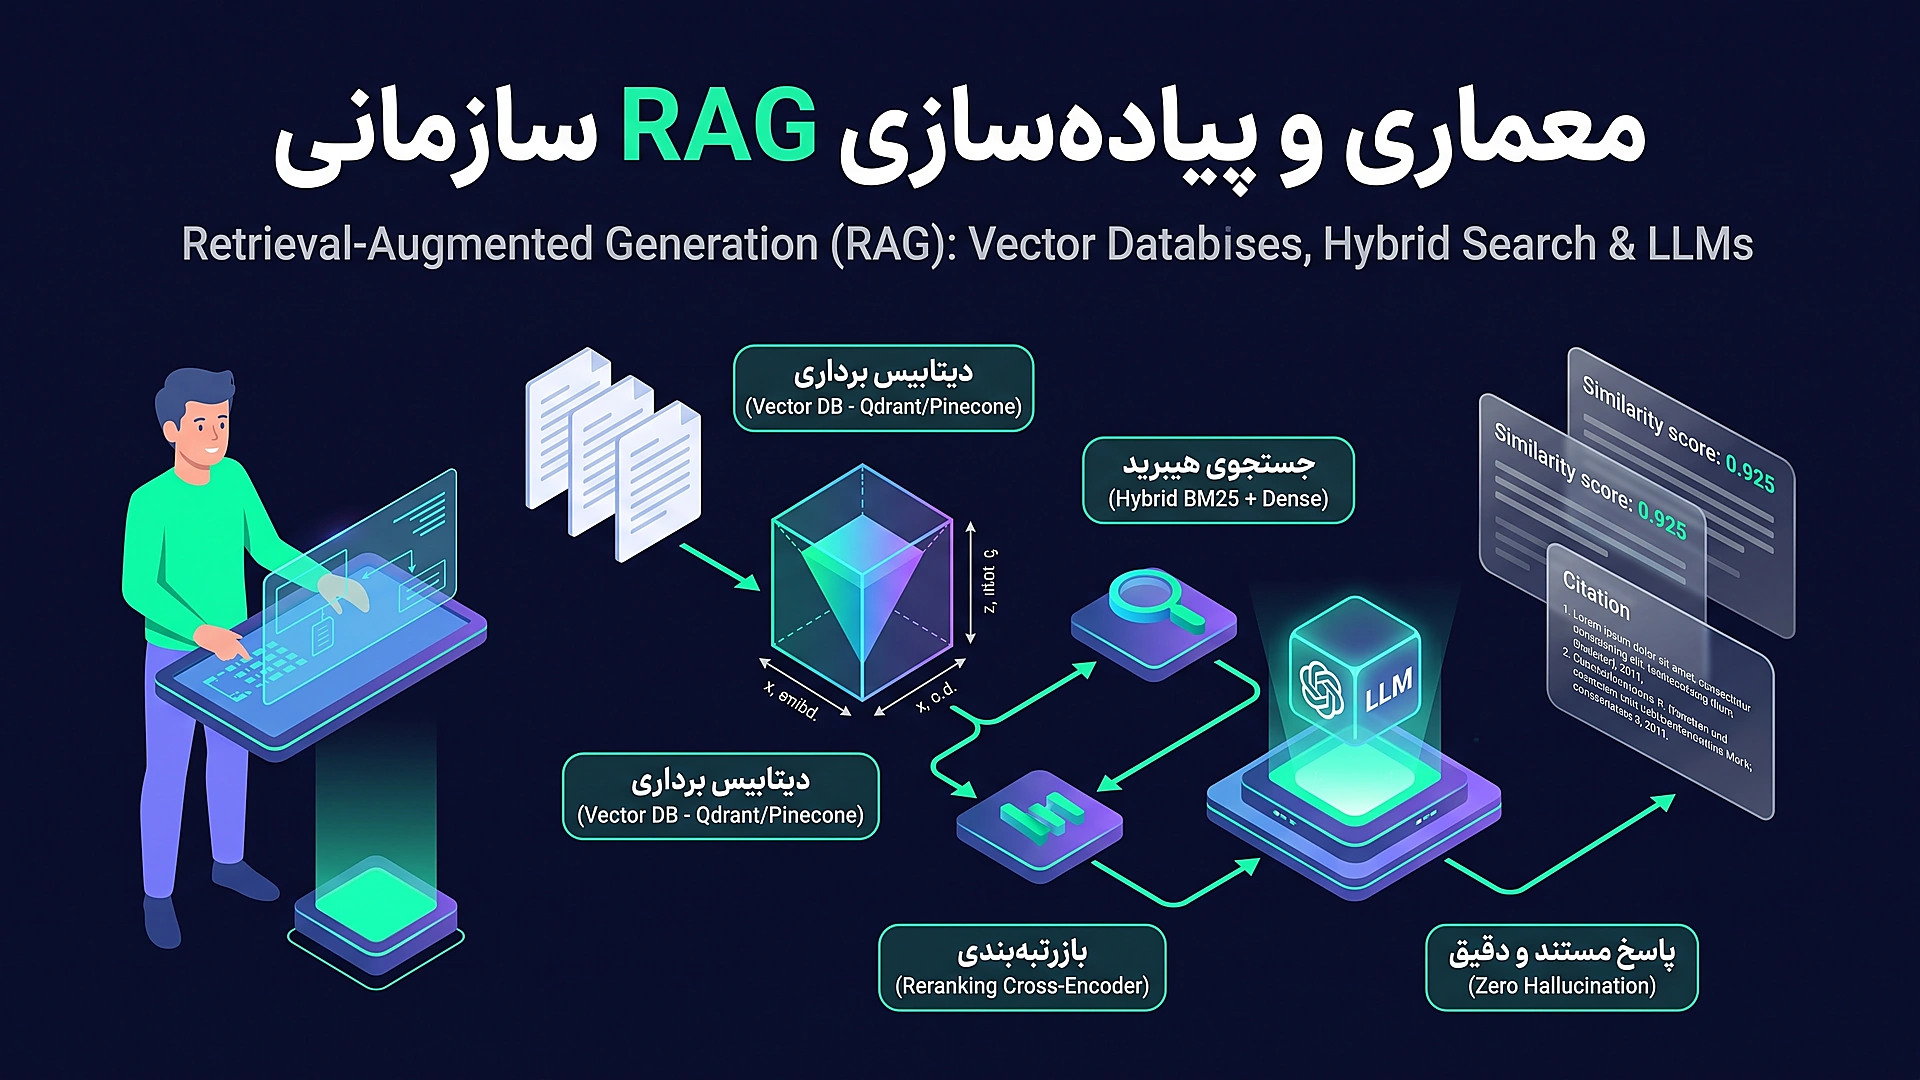
چرا سیستمهای RAG به ستون فقرات هوش مصنوعی سازمانی تبدیل شدهاند؟
مدلهای زبانی بزرگ (LLMs) با وجود درک زبانی شگفتانگیز، دو محدودیت بنیادین در محیطهای واقعی کسبوکار دارند: عدم دسترسی به دادههای خصوصی و محرمانه سازمانی و پدیده توهم آماری (Hallucination). روش فاینتیونینگ (Fine-Tuning) برای رفع این چالش، هزینهای گزاف به سازمان تحمیل میکند و در برابر تغییرات روزمره اطلاعات به شدت شکننده است. معماری تولید مبتنی بر بازیابی یا RAG (Retrieval-Augmented Generation) پاسخی مهندسی، پایدار و کمهزینه به این دغدغه است که اسناد، پایگاههای داده و لاگهای سازمان را در کسر کوچکی از ثانیه جستجو کرده و حقایق مستند را پیش از تولید پاسخ به مدل زبانی تزریق مینماید.
مقدمه: پارادایم هوش مصنوعی مولد سازمانی و چالش پایگاه دانش اختصاصی
هنگامی که یک مهندس نرمافزار یا مدیر فنی تصمیم میگیرد یک چتبات پشتیبانی هوشمند، تحلیلگر کدهای مخزن یا سامانه جستجوی اسناد حقوقی و مالی برای شرکت خود طراحی کند، نخستین گزینهای که به ذهن متبادر میشود فراخوانی API مدلهای پیشرفتهای چون GPT-۴o، Claude ۳.۵ یا استقرار مدلهای منبعباز نظیر Llama ۳ و DeepSeek است. اما در همان گام نخست، سیستم با شکست مواجه میشود؛ مدل پیشآموزشدیده از ساختار پایگاهداده داخلی، تغییرات هفتگی سیاستهای مالی، سورسکدهای داخلی گیتلب و اسناد محرمانه مشتریان هیچگونه اطلاعی ندارد.
آموزش مجدد یا Fine-Tuning مدل بر روی این دادهها نه تنها نیازمند کلاسترهای گرانقیمت GPU و تخصص پیشرفته یادگیری عمیق است، بلکه مدلهای فاینتیونشده همچنان مستعد تولید دادههای ساختگی و تحریف حقایق با اطمینان کامل هستند. علاوه بر این، کنترل سطح دسترسی کارمندان (Role-Based Access Control) در مدلهای فاینتیونشده تقریبا ناممکن است.
اینجاست که معماری RAG به عنوان استاندارد بلامنازع صنعت هوش مصنوعی ظهور میکند. در این الگو، مغز تحلیلگر و استدلالگر مدل زبانی را از حافظه دادهای آن تفکیک میکنیم؛ مدل زبانی نقش موتور استدلال (Reasoning Engine) را ایفا میکند، در حالی که پایگاه دادههای برداری (Vector Databases) و پایگاههای دانش سازمانی نقش حافظه موثق، بهروز و قابل حسابرسی را بر عهده دارند.
معماری بنیادین و چرخه حیات داده در سیستم های RAG
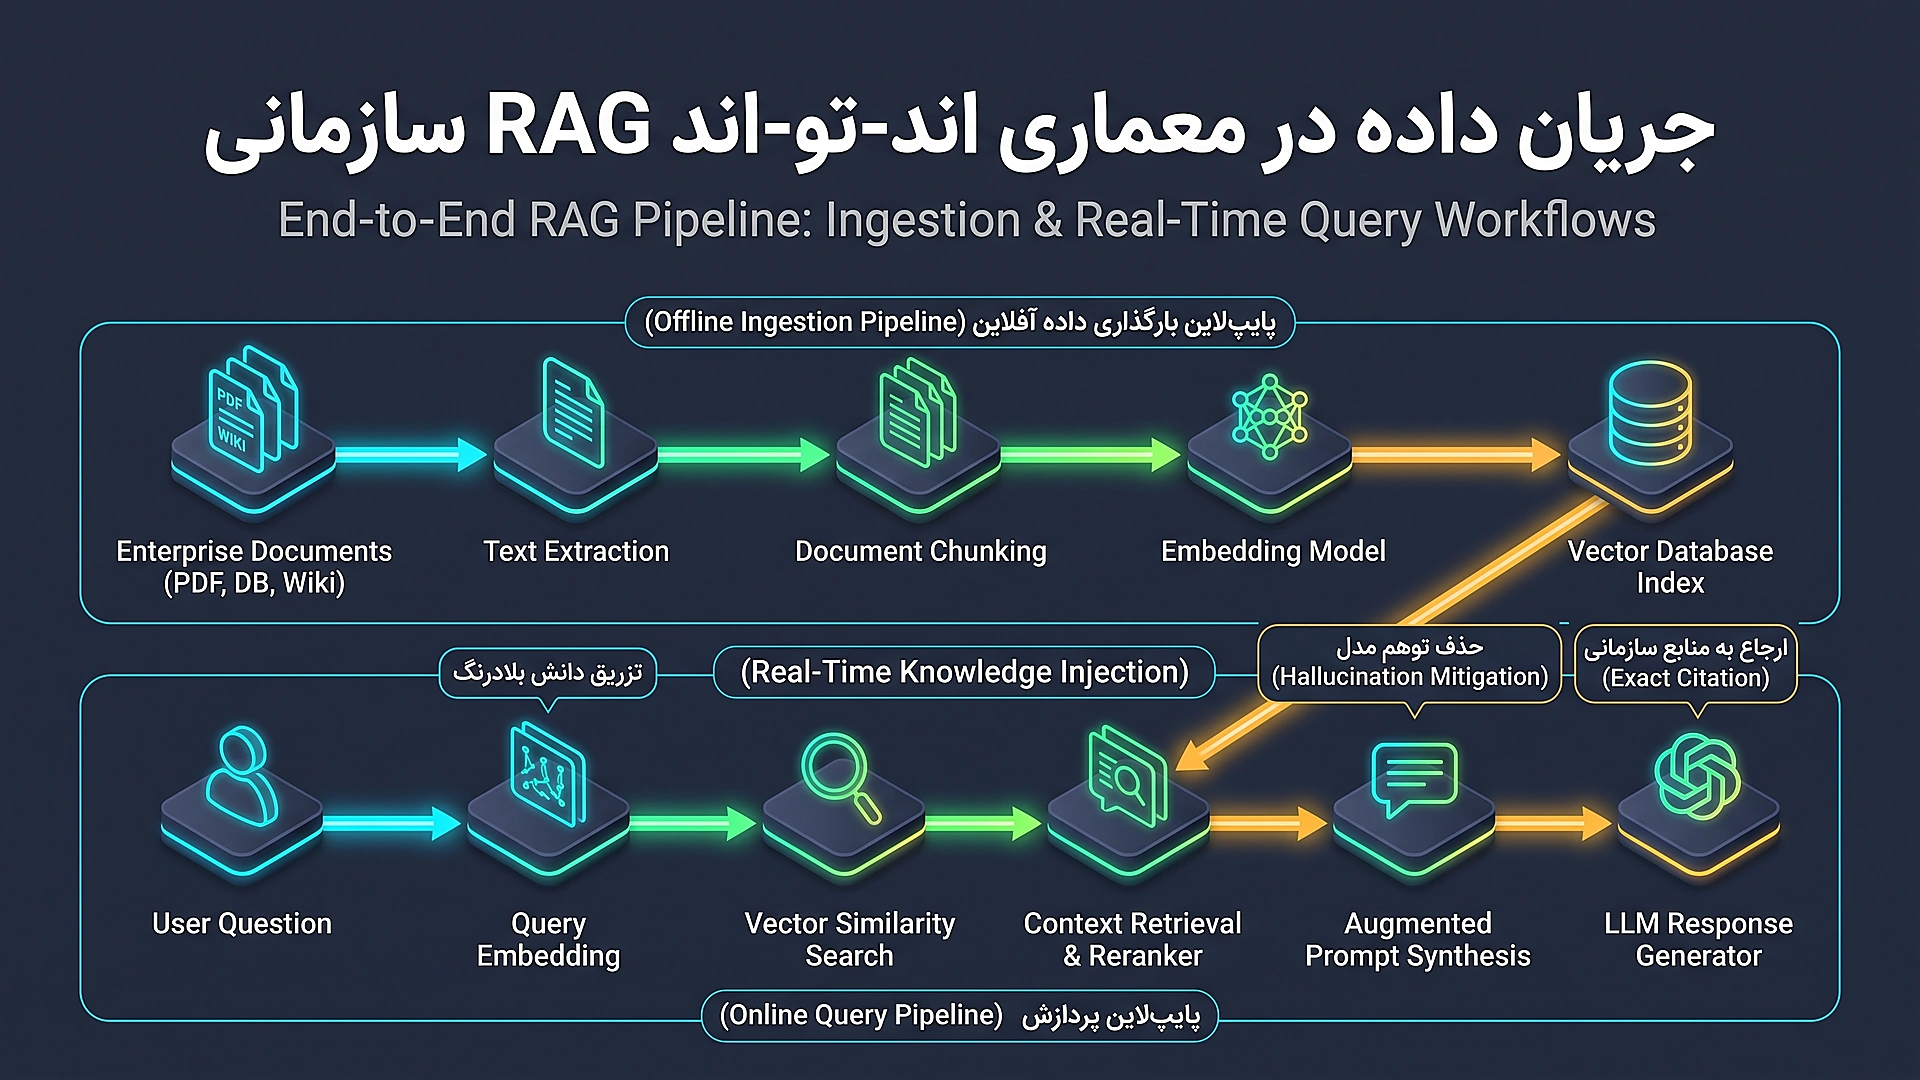
یک سیستم RAG در سطح سازمانی، یک اسکریپت ساده پایتون برای اتصال به OpenAI نیست؛ بلکه یک معماری نرمافزاری دوار و توزیعشده است که از دو چرخه مجزا اما هماهنگ تشکیل میشود:
جریان بارگذاری داده های خام و پردازش موازی
جریان بارگذاری (Ingestion Pipeline) به عنوان یک فرآیند غیرهمگام (Asynchronous) در پسزمینه سیستم اجرا میشود. در این چرخه، دادههای خام سازمانی در قالب فایلهای PDF، مستندات کانفلوئنس (Confluence)، لاگهای سیستمی، دیتابیسهای رابطهای و سورسکدها توسط لودرهای تخصصی استخراج میشوند. سپس مراحل پاکسازی، نرمالسازی و قطعهبندی معنایی (Semantic Chunking) صورت میگیرد. هر قطعه متن از طریق یک مدل امبدینگ به یک بردار متراکم عددی تبدیل شده و همراه با متادیتاهای دقیق (مانند تاریخ انتشار، سطح دسترسی و لینک مرجع) درون دیتابیس برداری ایندکسگذاری میشود.
جریان پرسوجوی بلادرنگ و غنیسازی کانتکست
جریان دوم، چرخه جستجو و تولید در زمان اجرای کاربر (Query Execution Pipeline) است. هنگامی که کاربر سؤالی را مطرح میکند، درخواست او ابتدا بازآرایی و پالایش شده و سپس به فضای برداری نگاشت میشود. سیستم با بهرهگیری از الگوریتمهای جستجوی تقریبی نزدیکترین همسایهها (ANN)، مرتبطترین قطعات مستندات را استخراج میکند. سپس نتایج توسط فیلترهای ریرنکینگ ارزیابی شده و برترین قطعات به همراه پرسش اولیه درون یک پرامپت غنیشده قرار میگیرند و برای سنتز نهایی به مدل زبانی ارسال میشوند.
چالش توهم در مدل های زبانی بزرگ و مکانیزم Groundedness
توهم (Hallucination) ویژگی ذاتی مدلهای زبانی مبتنی بر ترنسفورمر است. این مدلها به جای محاسبه حقیقت مطلق، احتمال آماری کلمه بعدی (Next-Token Prediction) را پیشبینی میکنند. هنگامی که مدل با کمبود دادههای معتبر در مورد یک سناریوی خاص مواجه شود، الگوهای محتمل نحوی را کنار هم قرار میدهد تا پاسخی ظاهراً منطقی اما کاملاً نادرست خلق کند.
در کاربردهای پزشکی، مالی، حقوقی و مهندسی سیستم، یک توهم کوچک میتواند به خسارتهای جبرانناپذیر منجر شود. مفهوم Groundedness (پایبندی به شواهد) در RAG تضمین میکند که تمامی ادعاهای مطرحشده در پاسخ مدل، منحصراً برگرفته از قطعات متن بازیابیشده باشند. با تعریف گاردریلها (Guardrails) و دستورات سیستمی اکید، مدل موظف میشود در صورتی که اطلاعات لازم در کانتکست بازیابیشده وجود نداشت، صراحتاً عدم آگاهی خود را اعلام کند و از فرضیهبافی اجتناب ورزد.
استراتژیهای پیشرفته چانکینگ و تقسیمبندی معنایی اسناد سازمانی
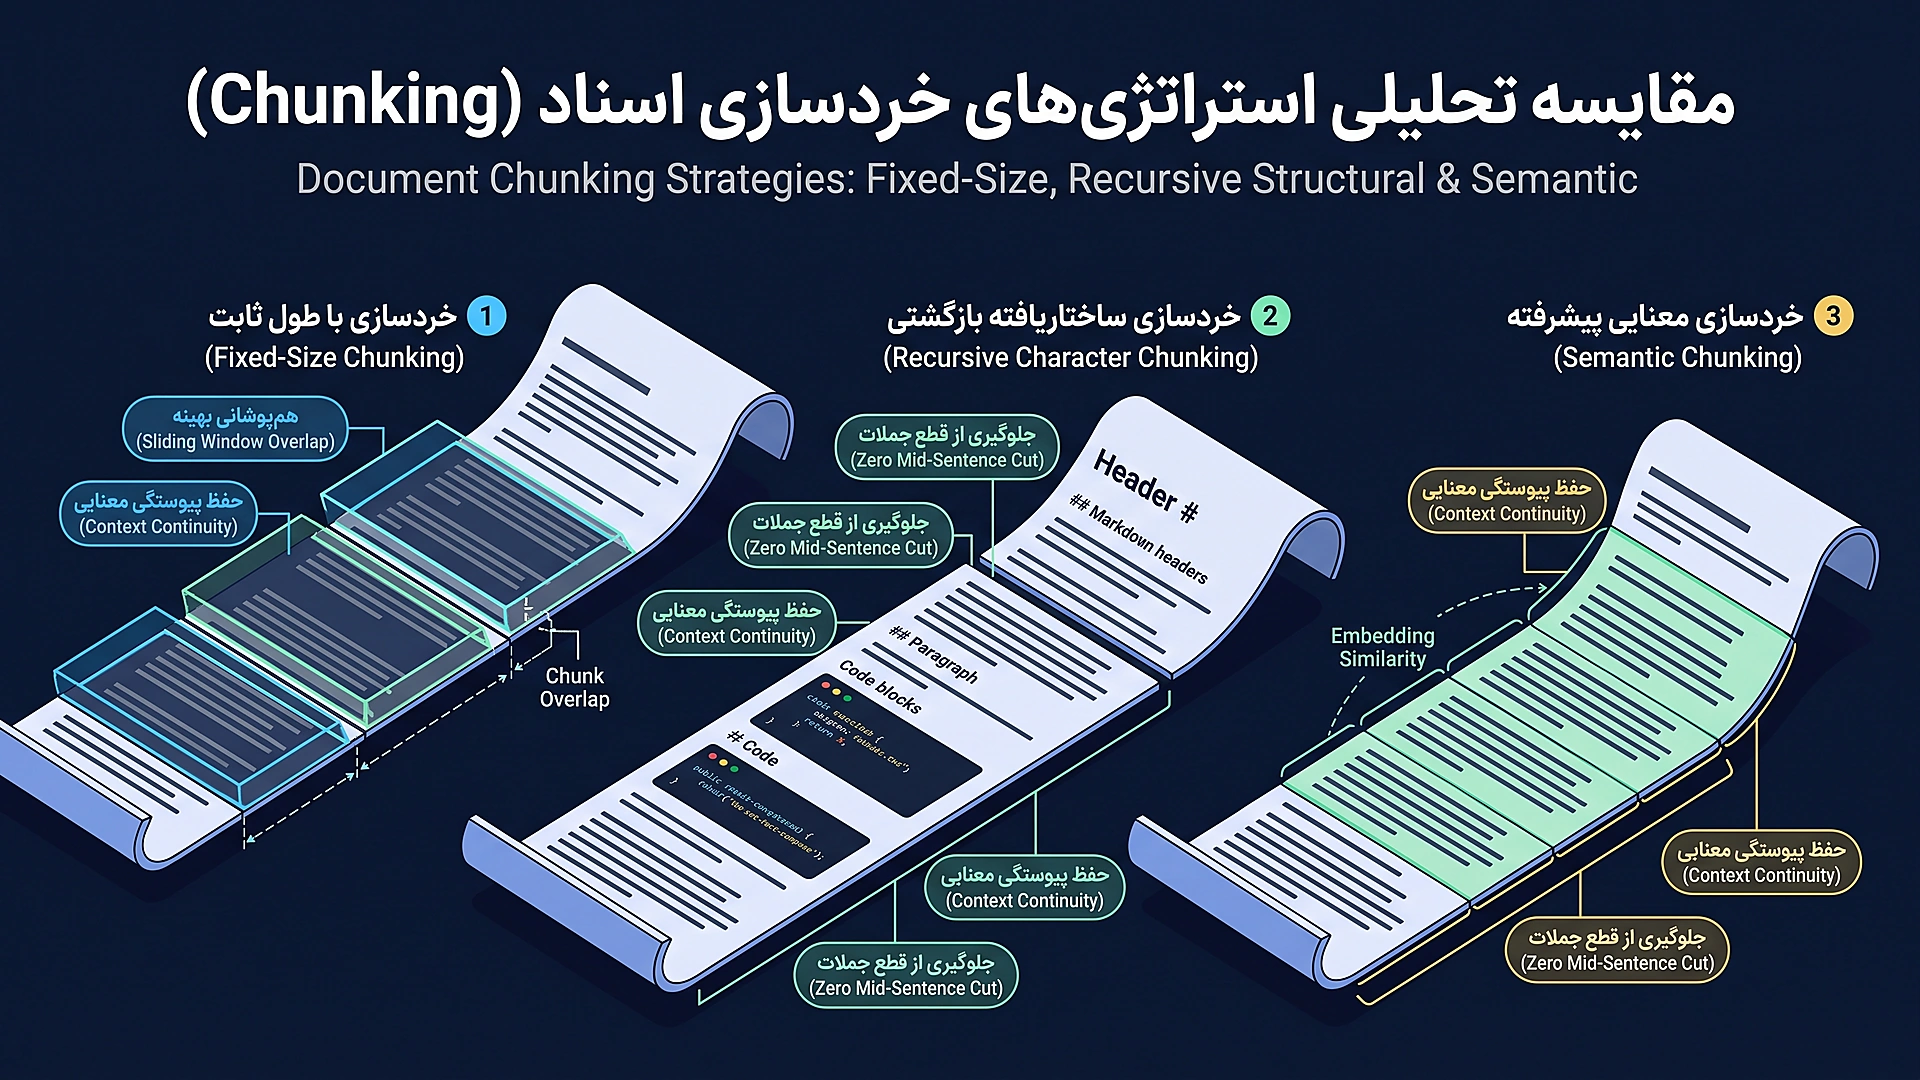
بزرگترین خطای توسعهدهندگان در پیادهسازی پروژههای RAG، بیتوجهی به مرحله چانکینگ (Chunking) است. اگر قطعات متن بیش از حد بزرگ باشند، پنجره کانتکست مدل پر از نویزهای نامربوط شده و هزینه توکنها افزایش مییابد. از سوی دیگر، اگر قطعات بیش از حد کوچک باشند، مفاهیم کلیدی شکسته شده و معنای پاراگراف از دست میرود.
چانکینگ بازگشتی ساختاریافته (Recursive Character Splitting)
در این روش، متن با استفاده از سلسلهمراتبی از جداکنندهها (Separators) خرد میشود. ابتدا تلاش میشود متن بر اساس پاراگرافهای کامل (دو خط خالی متوالی) تفکیک گردد. اگر قطعه حاصل همچنان از سقف مجاز توکنها بزرگتر بود، تقسیم بر اساس خطوط، سپس جملات، سپس کلمات و در نهایت کاراکترها صورت میگیرد. همچنین با تعریف همپوشانی لغزنده (Sliding Window Overlap) در حدود ۱۵ تا ۲۰ درصد، حقایقی که در مرز مشترک دو قطعه قرار دارند مخدوش نمیشوند.
from typing import List
from langchain_text_splitters import RecursiveCharacterTextSplitter
from langchain_core.documents import Document

def build_semantic_chunker(
    target_chunk_size: int = ۶۰۰,
    overlap_tokens: int = ۱۲۰
) -> RecursiveCharacterTextSplitter:
    """
    Configures an enterprise-grade recursive chunker.
    Uses multi-tier boundary separators to preserve syntax and logical paragraphs.
    """
    separators = [
        "\n\n",           # Markdown / Paragraph boundary
        "\n",             # Line break boundary
        "(?<=\.\s)",      # Sentence termination lookbehind (English/Latin)
        "؛\s|،\s",       # Persian/Arabic complex punctuation pauses
        "\.\s",          # Persian period terminator
        " ",              # Word delimiter
        ""                # Character fallback (failsafe)
    ]

    return RecursiveCharacterTextSplitter(
        chunk_size=target_chunk_size,
        chunk_overlap=overlap_tokens,
        length_function=len,
        separators=separators,
        is_separator_regex=True,
        keep_separator=True
    )

# Example: Ingesting raw technical documentation
raw_text = """
[Enterprise Knowledge Base: High-Availability Architecture]
All critical microservices must communicate via gRPC with mutual TLS (mTLS) enabled.
In case of network partition, circuit breakers configured with resilience۴j
must immediately transition to HALF-OPEN after a ۳۰-second backoff threshold.
"""

splitter = build_semantic_chunker()
chunks: List[Document] = splitter.create_documents(
    texts=[raw_text],
    metadatas=[{"source": "network_architecture_sop.md", "tier": "enterprise_core"}]
)

print(f"Generated {len(chunks)} optimized chunks with intact contextual boundaries.")
چانکینگ معنایی بر پایه فاصله امبدینگها (Semantic Splitting)
روش مدرنتر، چانکینگ معنایی است. در این رویکرد، سند به جملات مجزا تفکیک شده و بردار امبدینگ هر جمله محاسبه میشود. سپس فاصله کسینوسی بین جملات متوالی سنجیده میشود. در نقاطی که جهش ناگهانی در فاصله برداری رخ میدهد (که نشاندهنده تغییر موضوع بحث است)، مرز قطعه تعیین میگردد. این روش انسجام مفهومی حداکثری ایجاد میکند.
امبدینگهای متنی متراکم و نگاشت معنایی در فضای برداری
مدلهای امبدینگ (Embedding Models) موتور ترجمه متون انسانی به زبان ریاضی و هندسی هستند. برخلاف مدلهای کلاسیک کلیدواژهای مانند TF-IDF که تنها حضور فیزیکی کلمات را میشمارند، مدلهای متراکم (Dense Embeddings) کلمات و جملات را به فضاهای چندبعدی (بین ۳۸۴ تا ۱۵۳۶ بُعد) نگاشت میکنند.
در این فضای هندسی، مفاهیمی که بار معنایی یکسانی دارند، حتی با وجود استفاده از کلمات کاملاً متفاوت، در فاصلهای بسیار نزدیک به یکدیگر قرار میگیرند. به عنوان مثال، عبارت «روش راهاندازی سرویس در لینوکس» با عبارت «نحوه استقرار کانتینر در سرور اوبونتو» زاویه برداری بسیار کوچکی تشکیل میدهند.
کالبدشکافی دیتابیسهای برداری پیشرو و الگوریتمهای ایندکس HNSW
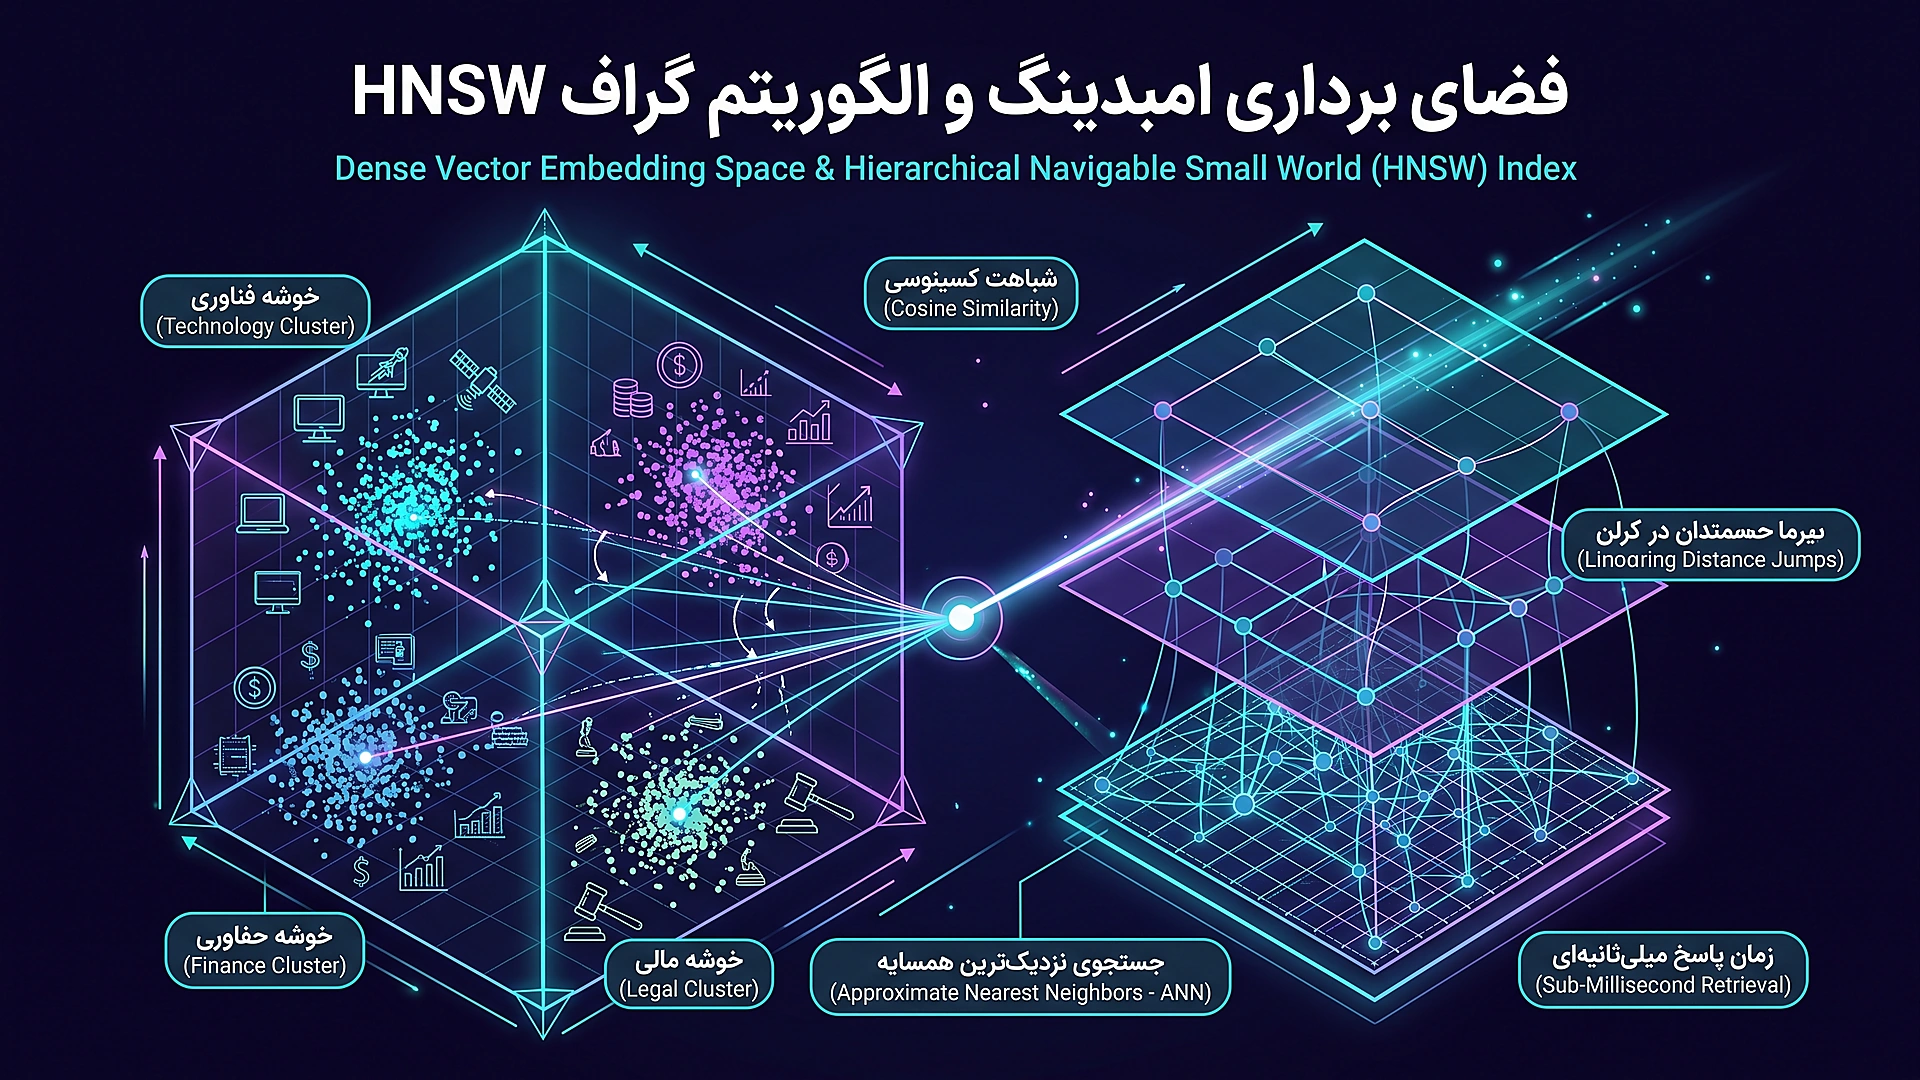
پایگاههای داده رابطهای سنتی مانند PostgreSQL برای مقایسه برابری یا بازه مقادیر طراحی شدهاند. اما در یک پایگاه داده برداری، ما به دنبال یافتن K بردار با کمترین زاویه یا فاصله نسبت به بردار پرسش کاربر هستیم. مقایسه بردار پرسش با میلیونها بردار ذخیرهشده (روش جستجوی همهجانبه Brute-Force یا Flat) به دلیل پیچیدگی زمانی O(N)، در پروداکشن عملی نیست و پاسخدهی را به چندین ثانیه میرساند.
مکانیزم گرافهای سلسلهمراتبی کوچکدنیای ناوبریپذیر (HNSW)
الگوریتم HNSW (Hierarchical Navigable Small World) انقلابی در سرعت بازیابی برداری ایجاد کرده است. ساختار این الگوریتم شباهت زیادی به ساختار Skip List دارد؛ چندین لایه از گرافهای متصل روی هم قرار میگیرند. لایههای بالایی دارای گرههای کم و اتصالات طولانی هستند که به موتور جستجو اجازه میدهد با پرشهای سریع، ناحیه کلی مربوط به مفهوم را پیدا کند. سپس جستجو به لایههای متراکمتر زیرین منتقل شده و نزدیکترین همسایهها را با زمان اجرای لگاریتمی O(log N) و در کمتر از ۱۰ میلیثانیه پیدا میکند.
import uuid
from typing import List, Dict, Any
from qdrant_client import QdrantClient
from qdrant_client.http import models

# Connect to local or cluster Qdrant instance
client = QdrantClient(host="localhost", port=۶۳۳۳, timeout=۱۰.۰)

COLLECTION_NAME = "enterprise_rag_knowledge"
EMBEDDING_DIMENSION = ۷۶۸  # Standard dimension for BGE-base / Nomic-embed

def initialize_vector_collection(client: QdrantClient):
    """Initializes collection with tailored HNSW indexing graph parameters."""
    if not client.collection_exists(COLLECTION_NAME):
        client.create_collection(
            collection_name=COLLECTION_NAME,
            vectors_config=models.VectorParams(
                size=EMBEDDING_DIMENSION,
                distance=models.Distance.COSINE
            ),
            # Fine-tune HNSW graph connectivity for production sub-۱۵ms latency
            hnsw_config=models.HnswConfigDiff(
                m=۱۶,               # Number of bi-directional links per node
                ef_construct=۱۲۸,   # Neighbors evaluated during index construction
                full_scan_threshold=۱۰۰۰۰,
                on_disk=True        # Offload graph to NVMe SSD for terabyte scale
            ),
            optimizers_config=models.OptimizersConfigDiff(
                default_segment_number=۴,
                memmap_threshold=۲۰۰۰۰
            )
        )
        print(f"Collection '{COLLECTION_NAME}' successfully initialized with HNSW.")

def upsert_knowledge_batch(
    client: QdrantClient,
    chunks: List[str],
    vectors: List[List[float]],
    metadatas: List[Dict[str, Any]]
):
    """Atomic batch upsert with structured metadata payloads for payload filtering."""
    points = [
        models.PointStruct(
            id=str(uuid.uuid۴()),
            vector=vector,
            payload={
                "content": text,
                **meta
            }
        )
        for text, vector, meta in zip(chunks, vectors, metadatas)
    ]

    client.upsert(
        collection_name=COLLECTION_NAME,
        points=points,
        wait=True
    )
معیارهای سنجش شباهت: کسینوسی در برابر ضرب داخلی و اقلیدسی
برای اندازهگیری میزان نزدیکی بردارها سه معیار رایج ریاضی وجود دارد:
- شباهت کسینوسی (Cosine Similarity): کسینوس زاویه بین دو بردار را میسنجد و مستقل از طول بردار است. برای متون با طول متغیر بهترین انتخاب است.
- ضرب داخلی (Dot Product): در صورتی که بردارها از قبل نرمالسازی شده و به طول واحد (Unit Length) تبدیل شده باشند، مقدار ضرب داخلی دقیقاً با شباهت کسینوسی برابر بوده و محاسبات سختافزاری آن با دستورات موازی SIMD فوقالعاده سریعتر است.
- فاصله اقلیدسی (L۲ Distance): فاصله خطی بین نقاط را در فضای چندبعدی محاسبه میکند و به طول متن حساس است.
پیادهسازی عملی استراتژی جستجوی ترکیبی یا هیبرید با BM۲۵ و بردارها
جستجوی صرفاً برداری با تمام مزایای معنایی خود، دارای یک نقص بزرگ به نام «لغزش معنایی (Semantic Drift)» است. مدلهای برداری در تطبیق کدهای خطای تخصصی (نظیر ERR_CONNECTION_REFUSED)، شماره فاکتورها، شناسههای ملی، نام اختصاری محصولات و اسامی خاص به شدت ضعیف عمل میکنند.
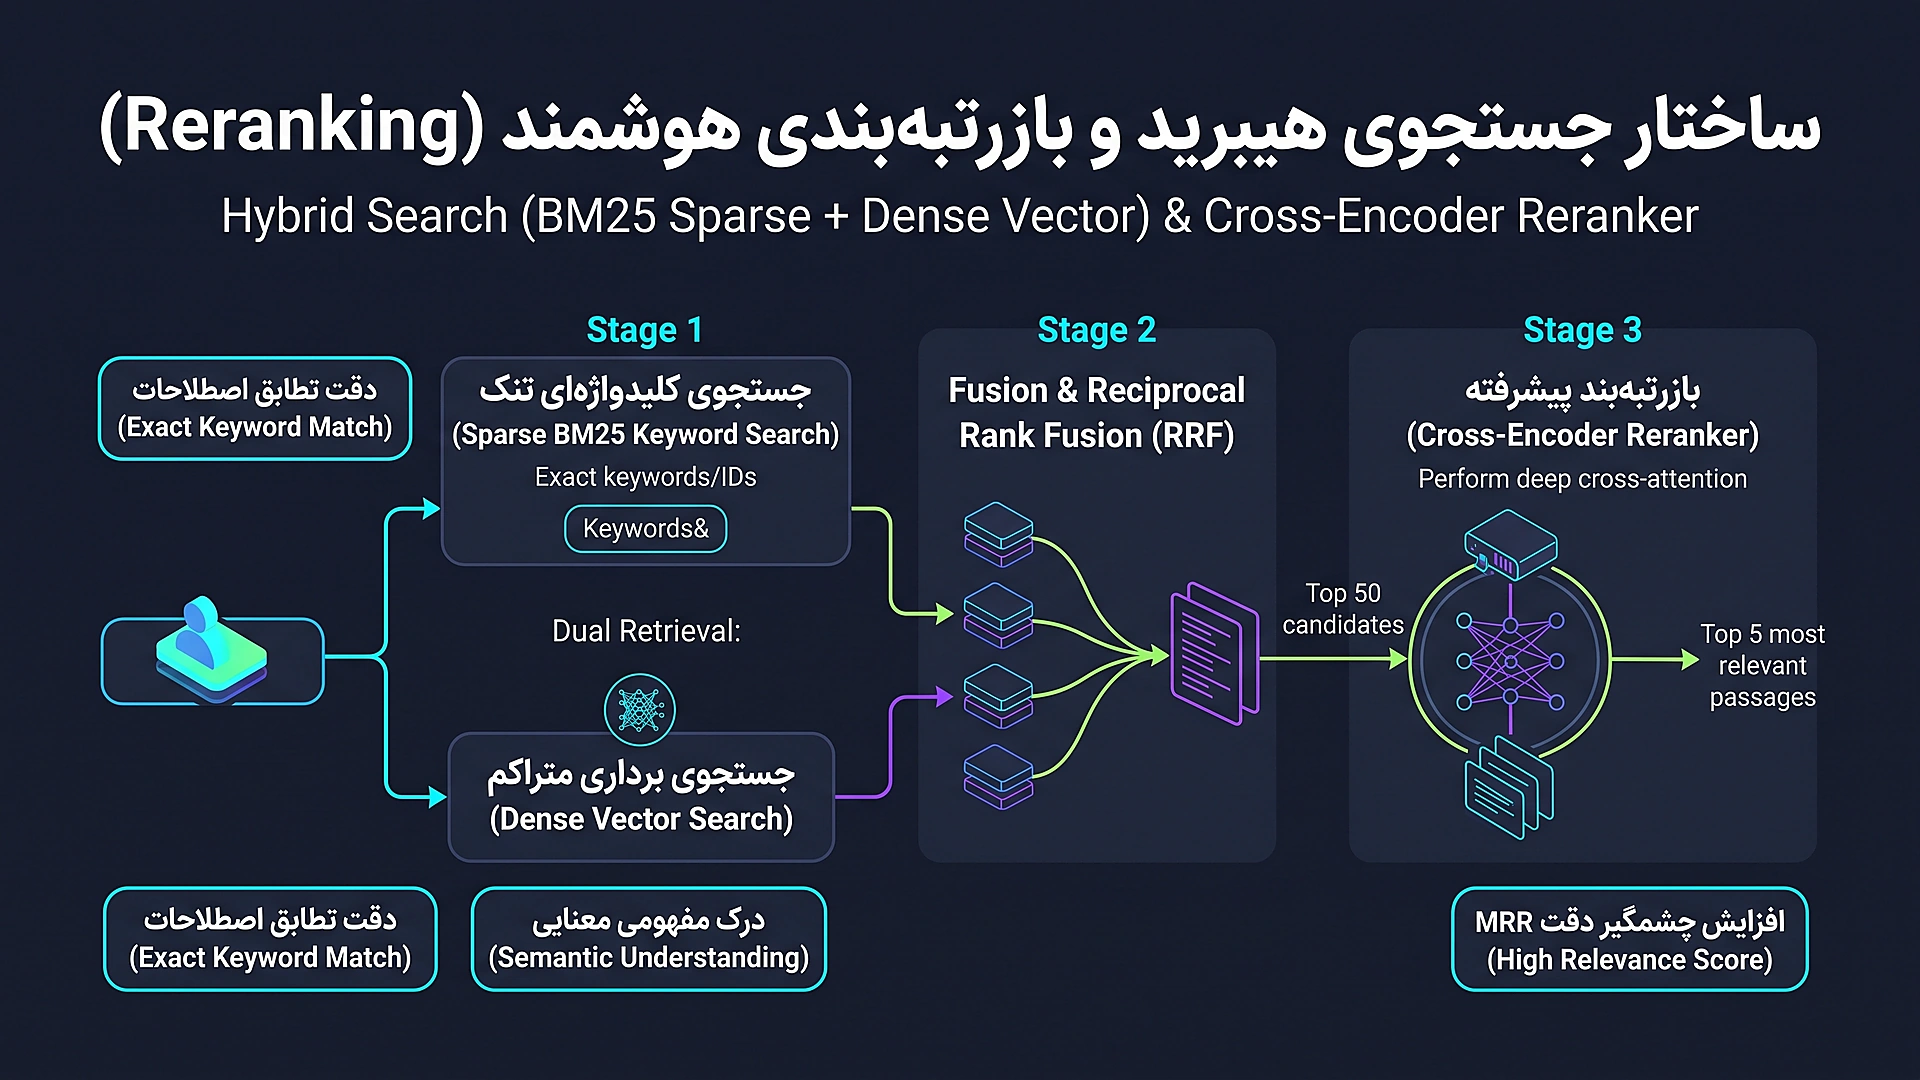
راهکار طلایی در سیستمهای پروداکشن، جستجوی ترکیبی (Hybrid Search) است. در این شیوه، پرسش کاربر به طور همزمان توسط الگوریتم واژگانی BM۲۵ (جستجوی دقیق کلیدواژه) و موتور برداری HNSW (جستجوی معنایی) جستجو میشود. سپس نتایج حاصل با الگوریتم ادغام رتبهبندی معکوس یا RRF (Reciprocal Rank Fusion) یکپارچهسازی میشوند:
from typing import List, Dict, Tuple
from collections import defaultdict
from rank_bm۲۵ import BM۲۵Okapi

class HybridRetriever:
    """
    Combines Lexical (BM۲۵) and Dense Vector retrieval using Reciprocal Rank Fusion.
    Guarantees both exact keyword recall and deep semantic matching.
    """
    def __init__(self, corpus: List[str], qdrant_client, collection_name: str, embedder):
        self.corpus = corpus
        self.client = qdrant_client
        self.collection_name = collection_name
        self.embedder = embedder

        # Tokenize corpus for BM۲۵ inverted index
        tokenized_corpus = [doc.lower().split() for doc in corpus]
        self.bm۲۵ = BM۲۵Okapi(tokenized_corpus)

    def reciprocal_rank_fusion(
        self,
        dense_results: List[Tuple[int, float]],
        sparse_results: List[Tuple[int, float]],
        k: int = ۶۰
    ) -> List[Tuple[int, float]]:
        """Implements RRF algorithm: RRF_score = sum(۱ / (k + rank))"""
        rrf_scores = defaultdict(float)

        # Score Dense candidate ranks
        for rank, (doc_idx, _) in enumerate(dense_results, start=۱):
            rrf_scores[doc_idx] += ۱.۰ / (k + rank)

        # Score Sparse BM۲۵ candidate ranks
        for rank, (doc_idx, _) in enumerate(sparse_results, start=۱):
            rrf_scores[doc_idx] += ۱.۰ / (k + rank)

        # Sort documents by fused RRF score descending
        sorted_docs = sorted(rrf_scores.items(), key=lambda item: item[۱], reverse=True)
        return sorted_docs

    def retrieve(self, query: str, top_k: int = ۱۰) -> List[str]:
        # ۱. Sparse BM۲۵ candidate scoring
        tokenized_query = query.lower().split()
        bm۲۵_scores = self.bm۲۵.get_scores(tokenized_query)
        sparse_ranked = sorted(enumerate(bm۲۵_scores), key=lambda x: x[۱], reverse=True)[:۵۰]

        # ۲. Dense Vector candidate scoring
        query_vector = self.embedder.embed_query(query)
        search_hits = self.client.search(
            collection_name=self.collection_name,
            query_vector=query_vector,
            limit=۵۰
        )
        dense_ranked = [(hit.payload["corpus_index"], hit.score) for hit in search_hits]

        # ۳. Fuse rankings via RRF
        fused = self.reciprocal_rank_fusion(dense_ranked, sparse_ranked, k=۶۰)
        return [self.corpus[doc_idx] for doc_idx, score in fused[:top_k]]
افزایش چشمگیر دقت بازیابی با فیلتر ریرنکینگ و کراسانکوردرها
مدلهای برداری استاندارد از معماری Bi-Encoder استفاده میکنند؛ یعنی پرسش کاربر و اسناد به طور کاملاً مستقل از هم به بردار تبدیل میشوند. این استقلال سرعت بالایی به همراه دارد اما برهمکنش عمیق میان کلمات سوال و کلمات سند را نادیده میگیرد.
برای حل این مشکل، لایهای از مدلهای کراسانکوردر (Cross-Encoder Rerankers) را در انتهای پایپلاین بازیابی مستقر میکنیم. کراسانکوردر متن پرسش و متن هر سند کاندید را با هم به عنوان یک جفت واحد وارد لایههای توجه ترنسفورمر میکند و ارتباط دقیق آنها را میسنجد. اضافه کردن این مرحله دقت کانتکست نهایی را تا بیش از ۳۰ درصد ارتقا میدهد:
from typing import List, Dict
from sentence_transformers import CrossEncoder

class NeuralReranker:
    """
    Cross-Encoder pipeline to re-score query-document pairs simultaneously.
    Provides complete full-attention cross-interaction between query and candidate.
    """
    def __init__(self, model_name: str = "cross-encoder/ms-marco-MiniLM-L-۶-v۲"):
        self.model = CrossEncoder(model_name, max_length=۵۱۲)

    def rerank(
        self,
        query: str,
        documents: List[Dict[str, str]],
        top_n: int = ۴
    ) -> List[Dict[str, str]]:
        """
        Re-scores and filters retrieved candidates down to Top-N high-fidelity context.
        """
        if not documents:
            return []

        # Construct paired input: [[query, doc_۱], [query, doc_۲], ...]
        pairs = [[query, doc["content"]] for doc in documents]

        # Compute multi-layer cross-attention scores
        scores = self.model.predict(pairs)

        # Attach normalized relevance score to each document
        for doc, score in zip(documents, scores):
            doc["rerank_score"] = float(score)

        # Sort strictly by cross-encoder score
        ranked_docs = sorted(documents, key=lambda x: x["rerank_score"], reverse=True)
        return ranked_docs[:top_n]
کانتینرسازی و استقرار پروداکشن دیتابیسهای برداری با داکر
موتورهای برداری نظیر Qdrant، Chroma و Weaviate برای ارائه کارایی پایدار در محیطهای سازمانی نیازمند پیکربندی سختگیرانه حافظه، تخصیص هستههای CPU و ذخیرهسازی مانا روی دیسکهای پرسرعت NVMe هستند. استفاده از داکر و داکر کامپوز به شما امکان میدهد این دیتابیسها را با متغیرهای محیطی بهینه و والیومهای امن کانتینریزه کرده و به آسانی در سرورهای ابری یا درونسازمانی مستقر نمایید.
# Production Docker Stack for Qdrant Vector Engine & Embedding Cache
services:
  qdrant:
    image: qdrant/qdrant:v1.9.0
    container_name: production_qdrant_engine
    restart: unless-stopped
    ports:
      - "6333:6333"   # REST API & Web Dashboard
      - "6334:6334"   # Ultra-fast gRPC RPC Interface
    environment:
      - QDRANT__SERVICE__HTTP_PORT=6333
      - QDRANT__SERVICE__GRPC_PORT=6334
      - QDRANT__STORAGE__STORAGE_PATH=/qdrant/storage
      - QDRANT__LOG_LEVEL=INFO
    volumes:
      - qdrant_storage_data:/qdrant/storage
    deploy:
      resources:
        limits:
          cpus: '4.0'
          memory: 8G
        reservations:
          cpus: '1.0'
          memory: 2G
    healthcheck:
      test: ["CMD-SHELL", "curl -f http://localhost:6333/readyz || exit 1"]
      interval: 15s
      timeout: 5s
      retries: 3
      start_period: 10s

volumes:
  qdrant_storage_data:
    driver: local
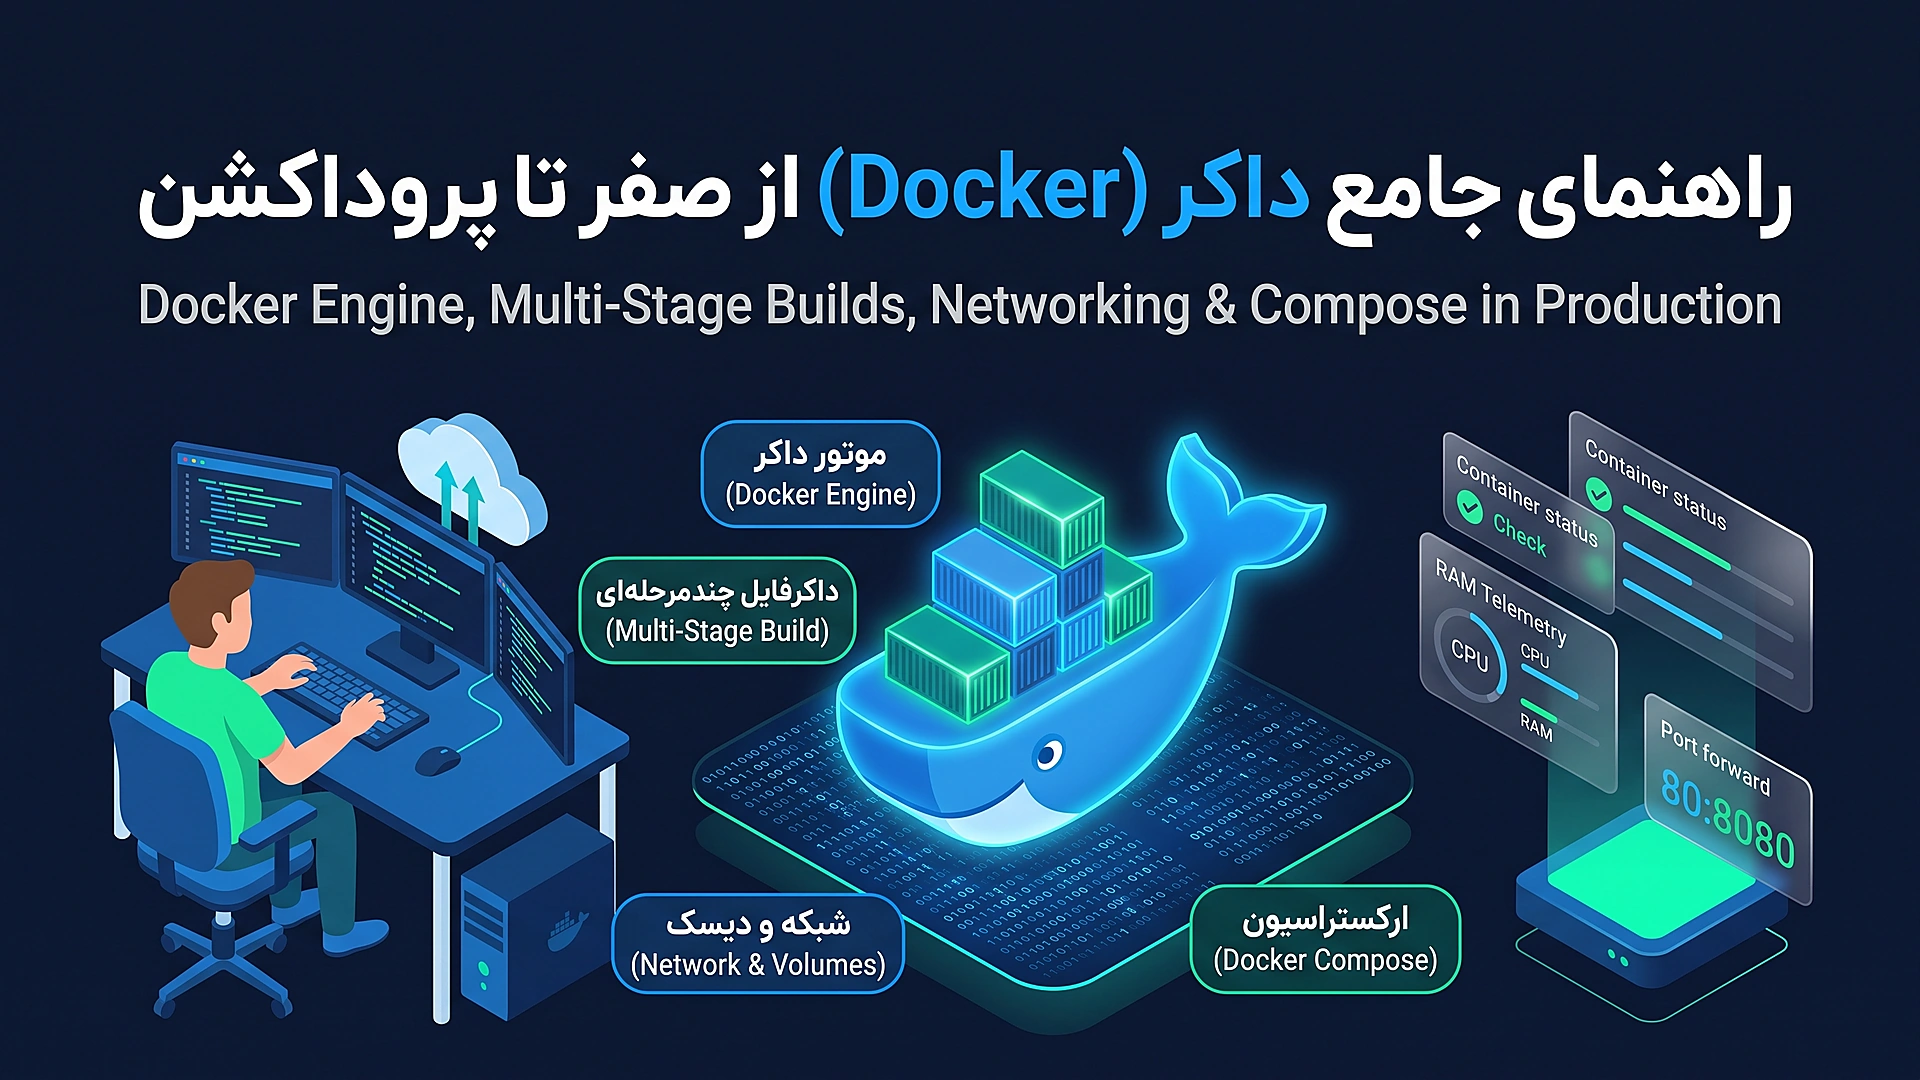
برای تسلط عمیق بر مبانی کانتینرسازی، والیومها، ایزولهسازی شبکههای داخلی و بهینهسازی کانتینرهای پروداکشن، مطالعه راهنمای جامع داکر در سایت اکیداً پیشنهاد میشود:
معماری تمیز در طراحی میکروسرویس های هوش مصنوعی و پایپ لاین RAG
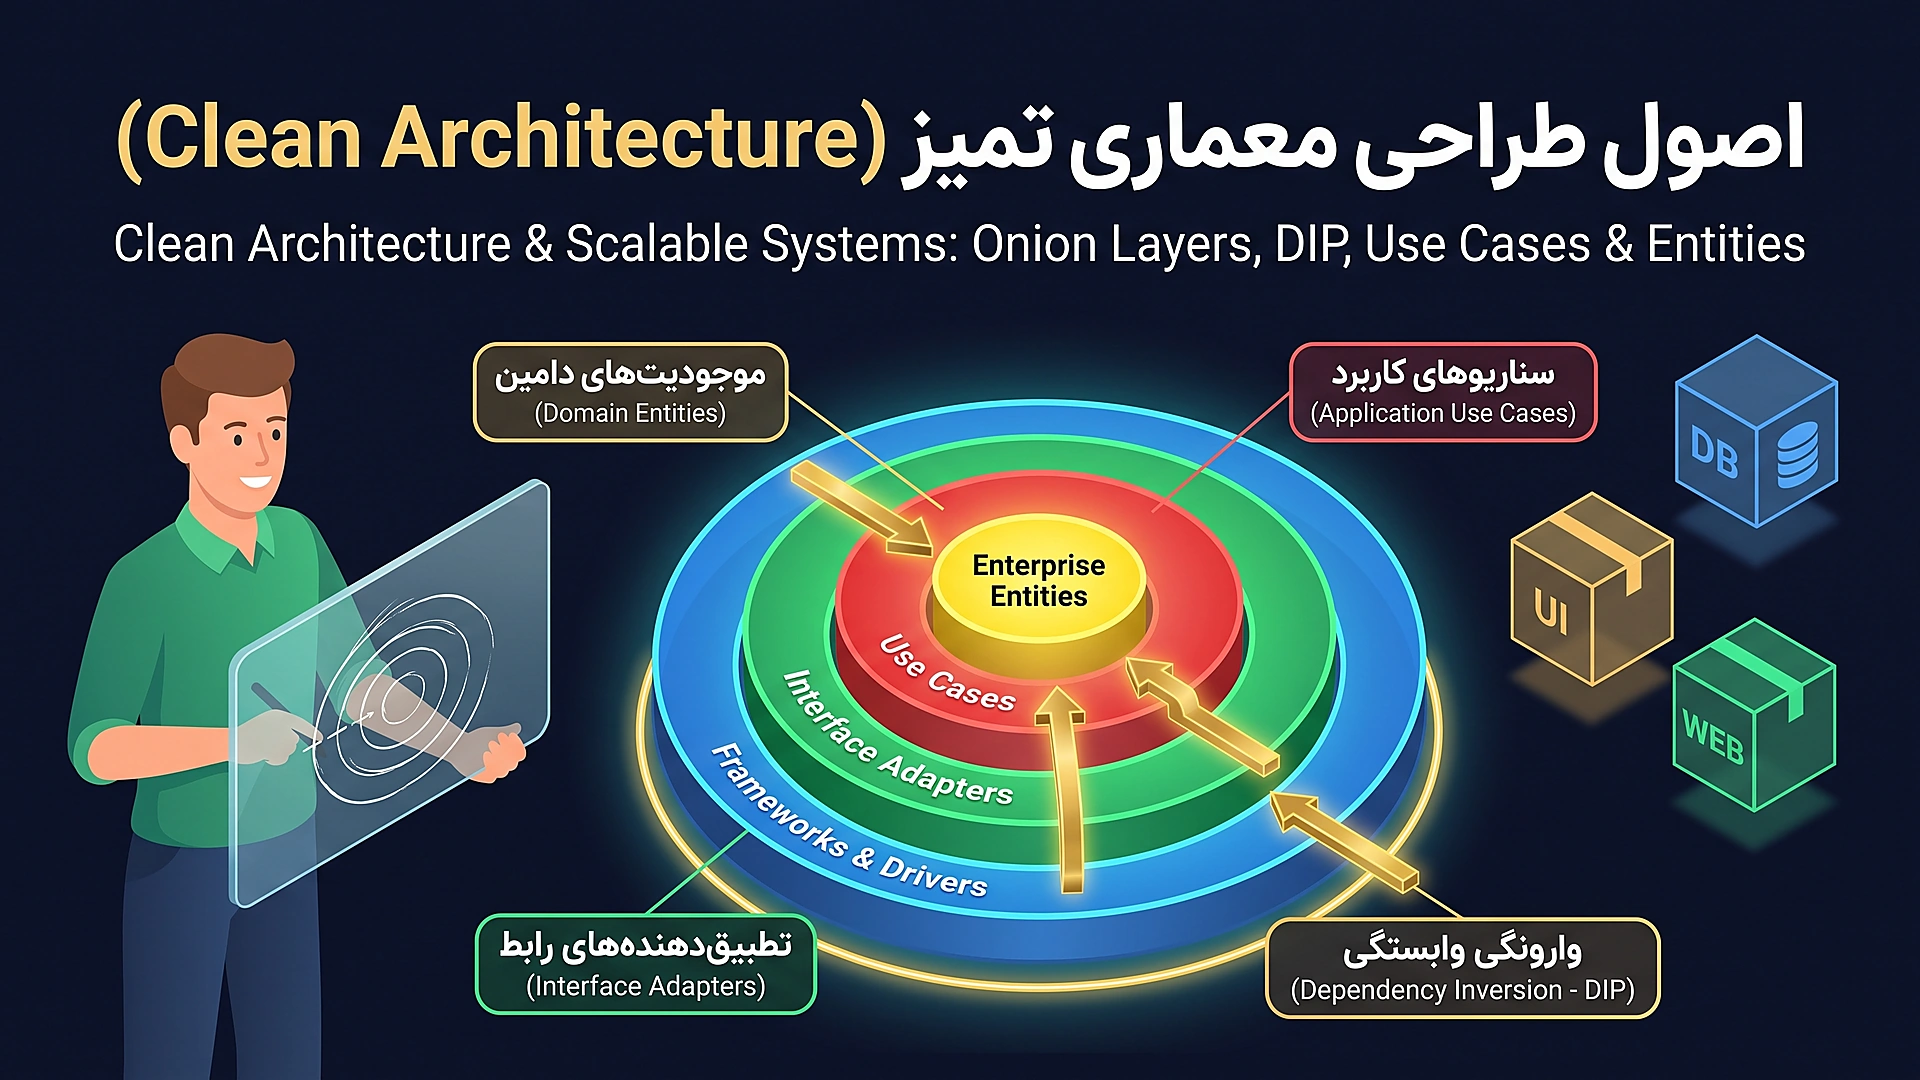
سیستمهای RAG در شرکتهای بزرگ به سرعت دچار درهمتنیدگی کدهای پایپلاین با منطق تجاری میشوند. اگر لایههای پایپلاین RAG، کدهای استخراج داده، درایور دیتابیس برداری و کلاینتهای API مدلهای زبانی از ساختار تفکیک دغدغهها تبعیت نکنند، با تغییر مدل زبانی از OpenAI به یک مدل داخلی، کل سرویس از کار خواهد افتاد.
با بهکارگیری اصول معماری تمیز (Clean Architecture)، ماژولهای پایپلاین RAG را به لایههای مستقل Domain (موجودیتها و منطق پاسخگویی)، Use Cases (جریان پرسوجو و اعتبارسنجی)، و Infrastructure (درایورهای Qdrant، مدلهای HuggingFace و اینترفیسهای وب) تفکیک میکنیم. با تعریف اینترفیسهای انتزاعی نظیر VectorStoreRepository و LLMGateway، پایگاه داده برداری و مدل زبانی به سادگی و بدون دستکاری در لایههای کسبوکار تعویضپذیر خواهند بود.
چارچوب استاندارد ارزیابی RAG Triad با فریم ورک Ragas
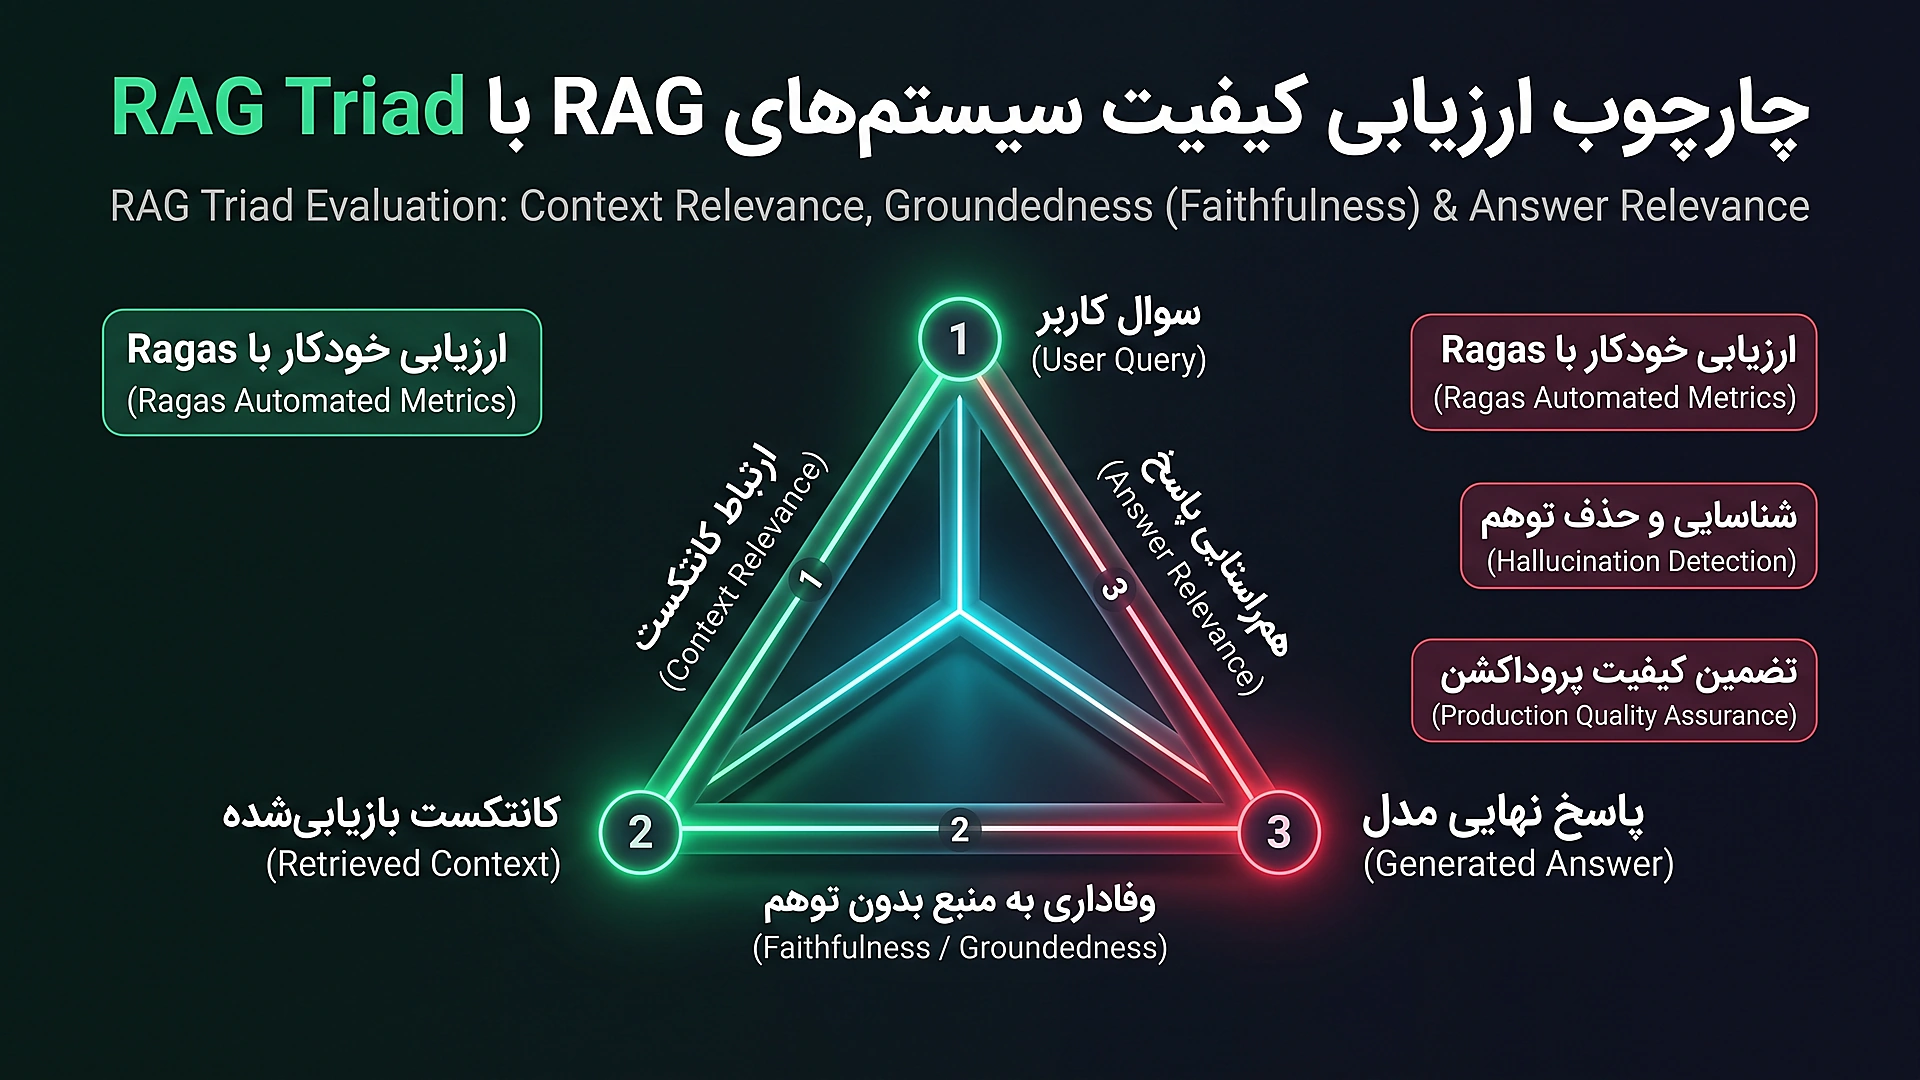
توسعه یک پایپلاین هوش مصنوعی بدون سیستم ارزیابی خودکار مانند رانندگی با چشمان بسته است. فریمورکهای استاندارد ارزیابی مانند Ragas عملکرد سیستم را بر پایه مفهوم بنیادین «سهگانه RAG» به صورت مستمر و خودکار میسنجند:
| شاخص ارزیابی | پرسش محوری شاخص | محدوده بحرانی در پروداکشن | اقدام اصلاحی در صورت افت |
|---|---|---|---|
| Context Precision | آیا قطعات بازیابیشده فقط حاوی اطلاعات مرتبط بدون نویز اضافه هستند؟ | > ۰.۸۵ | کوچکتر کردن قطعات متن و اضافه کردن کراسانکوردر |
| Faithfulness | آیا تمامی ادعاهای خروجی از روی کانتکست مستند قابل اثبات است؟ | > ۰.۹۵ | کاهش دمای مدل (Temperature=۰) و سختگیرانهتر کردن پرامپت |
| Answer Relevance | آیا پاسخ نهایی مستقیماً نیت اصلی کاربر را بدون طفره پاسخ داده است؟ | > ۰.۹۰ | بهبود تکنیکهای بازآرایی پرامپت و استفاده از Chain-of-Thought |
نتیجهگیری و افقهای نوین: گذار به سیستم های Agentic RAG
معماری RAG از یک الگوی ساده بازیابی و چسباندن متن فراتر رفته و به زیرساخت کلیدی نسل جدید سیستمهای نرمافزاری مبدل شده است. سازمانهایی که امروز زیرساخت دادههای برداری خود را با تفکیک صحیح لایهها، چانکینگ ساختاریافته، جستجوی هیبرید و ارزیابی خودکار پیادهسازی کنند، در برابر تغییرات سریع مدلهای زبانی آینده کاملاً بیمه خواهند بود.
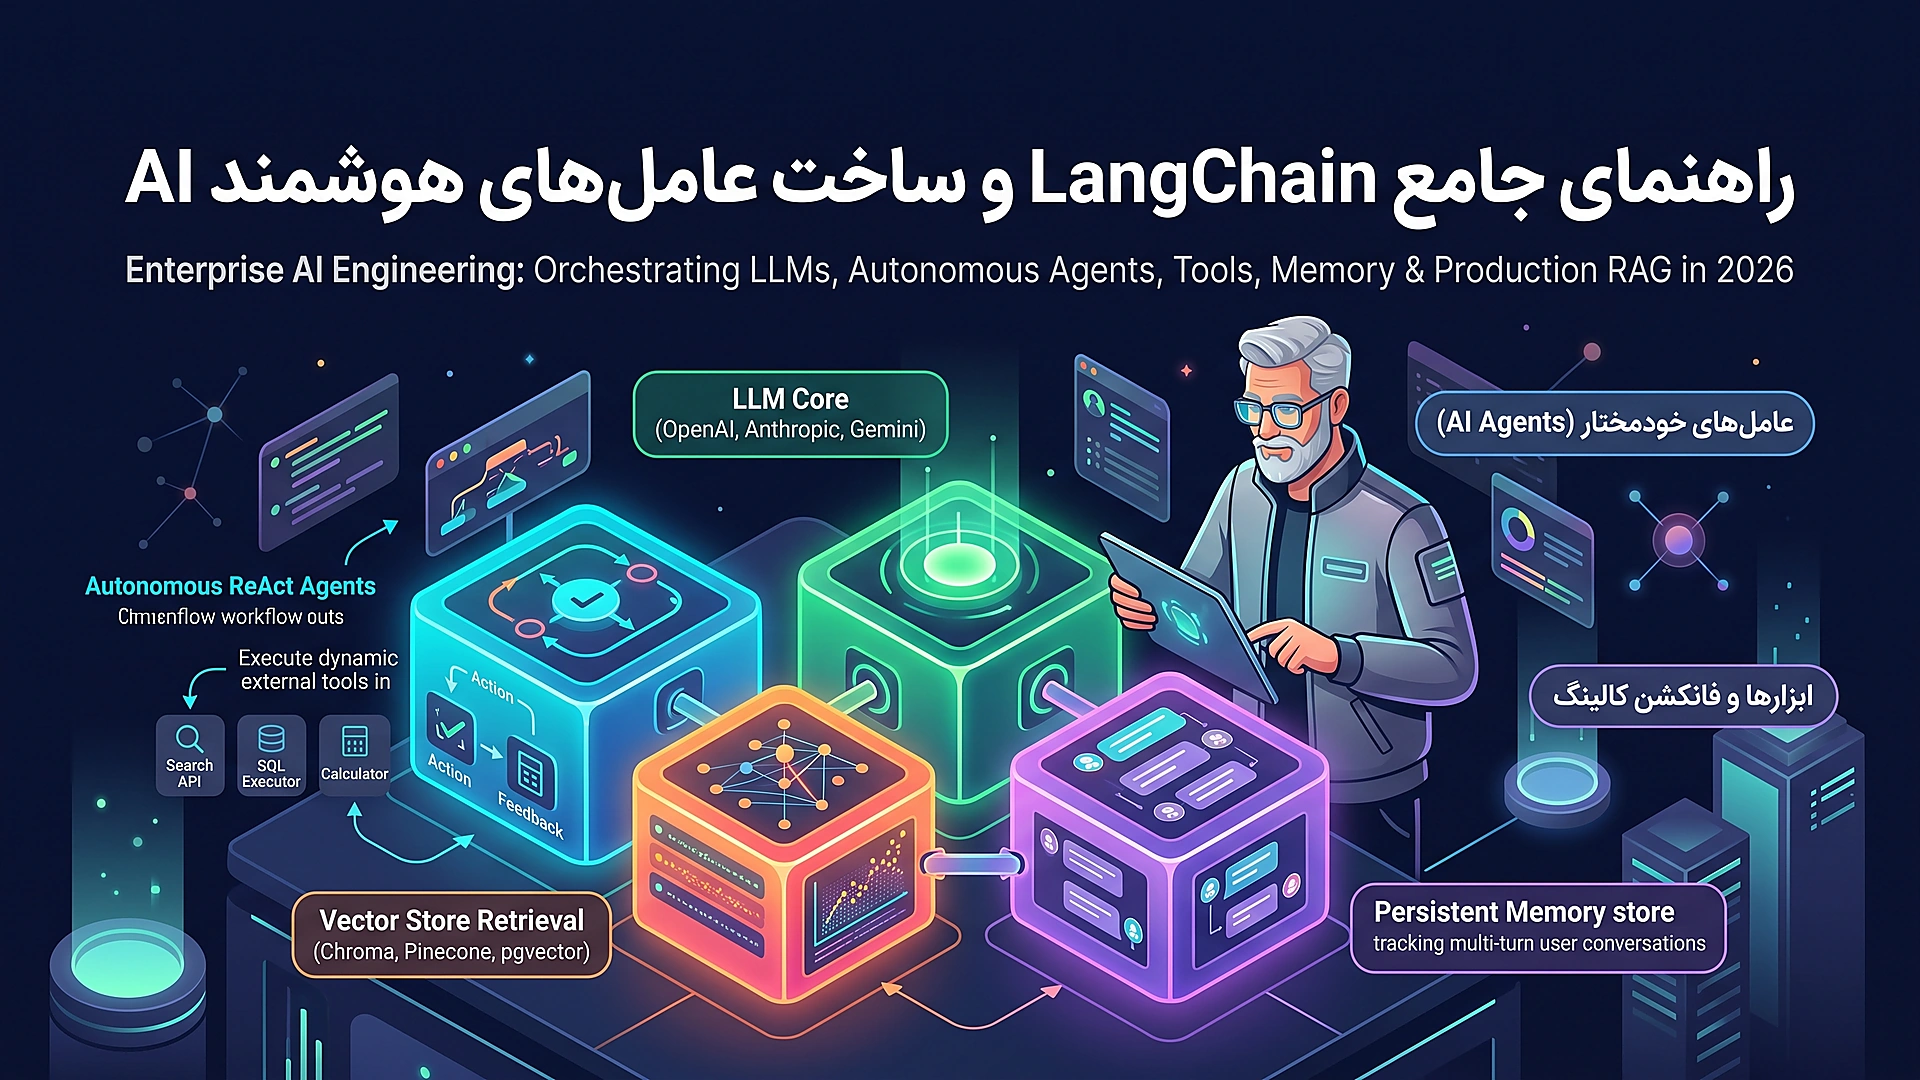
افق بعدی این فناوری، Agentic RAG است؛ سامانههایی متشکل از چندین ایجنت هوشمند که پیش از پاسخ، تصمیم میگیرند آیا به بازیابی اطلاعات نیاز دارند یا خیر، در صورت نیاز پرسش را به چندین زیرمسئله شکسته، از منابع متنوع دادههای موازی واکشی کرده و صحت نتایج را به صورت بازگشتی خود-ارزیابی مینمایند. پیادهسازی اصولی این پایپلاین نقطه ورود تیمهای مهندسی به جهان پردازش هوشمند و ارزشآفرینی پایدار در عصر هوش مصنوعی است.
امتیاز و نظرات
هنوز نظری ثبت نشده است. اولین نفر باشید.