
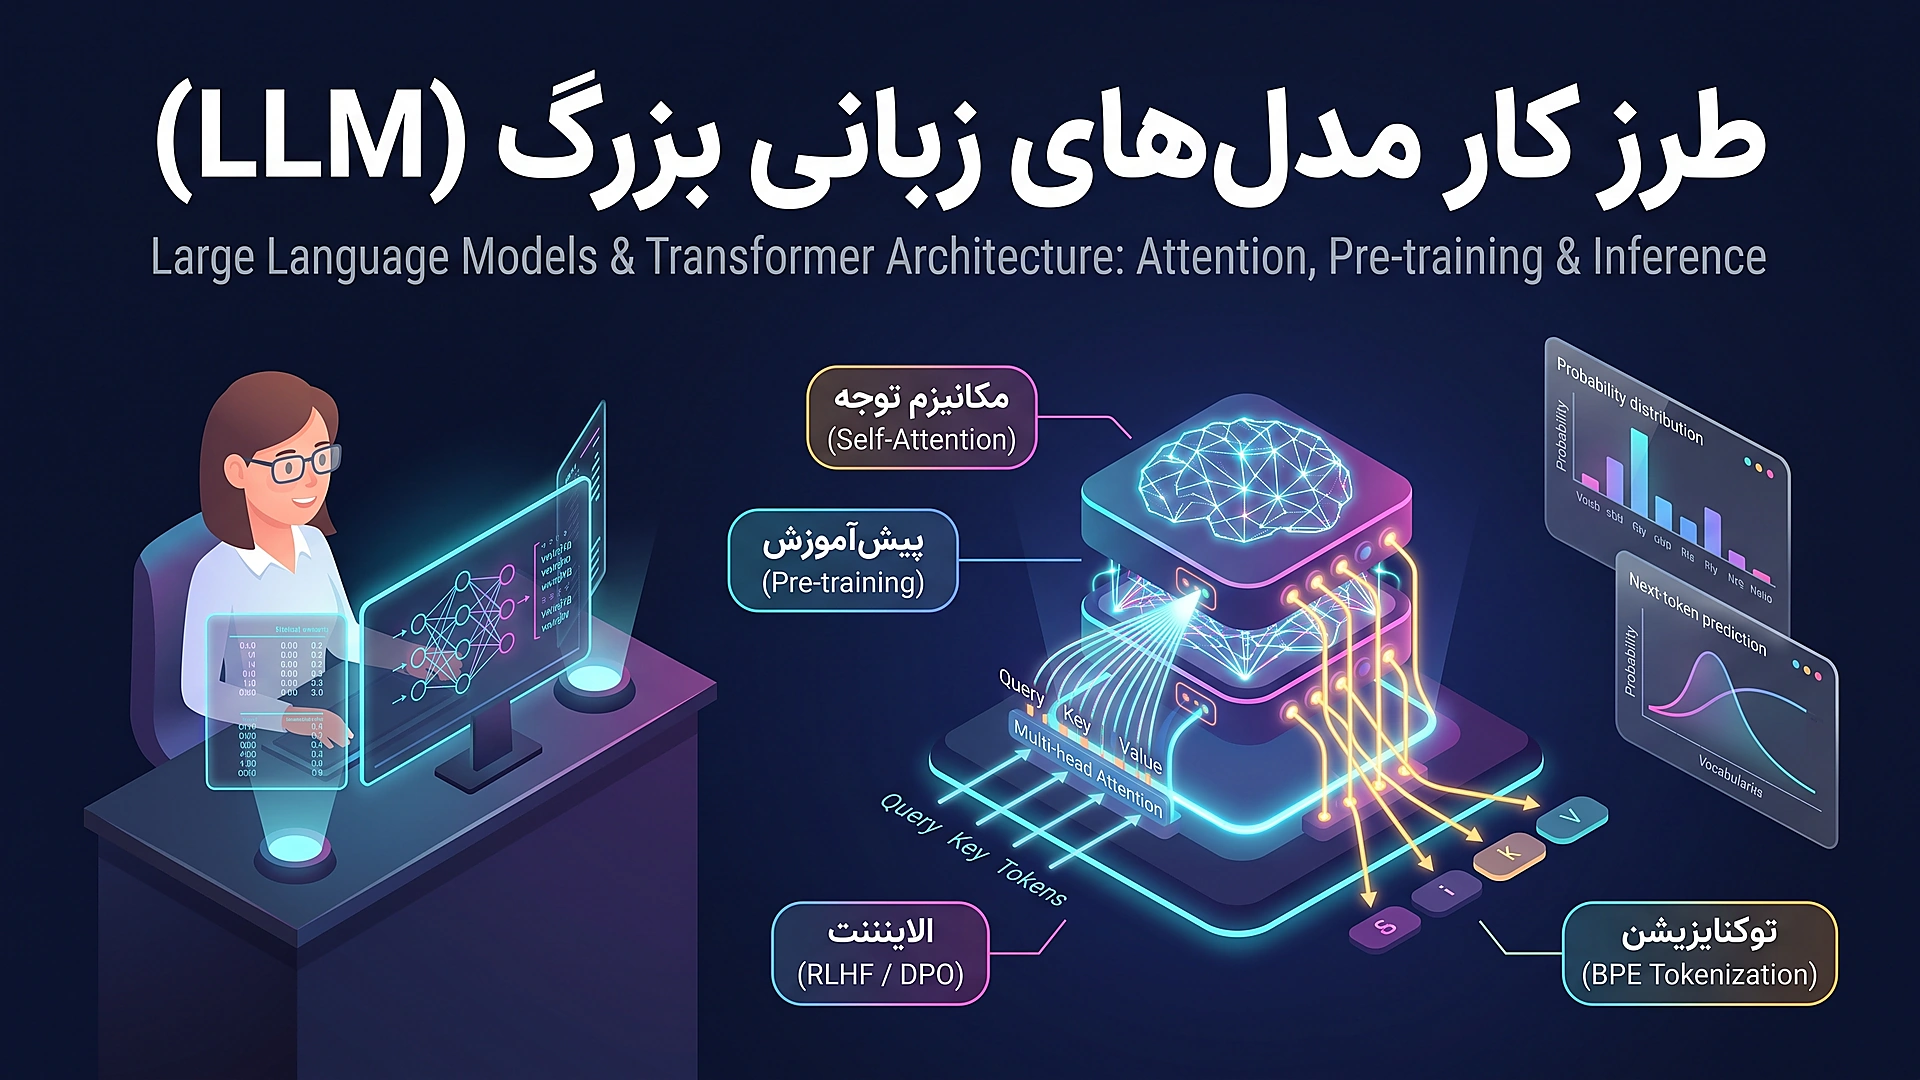
چرا یک مهندس نرمافزار ارشد باید نحوه کار درونی LLMها را بداند؟
بسیاری از توسعهدهندگان به مدلهای زبانی بزرگ (LLMs) نظیر GPT-۴o، Claude ۳.۵ یا Llama ۳ به عنوان یک جعبه سیاه جادویی یا یک وبسرویس REST ساده نگاه میکنند. اما زمانی که پای بهینهسازی هزینههای میلیونی توکن، رفع خطاهای مهلک توهم (Hallucination)، کاهش تأخیر زمان پاسخ (Latency) و طراحی سیستمهای مقیاسپذیر هوشمند به میان میآید، درک عمیق محاسبات ماتریسی ترنسفورمر، الگوریتمهای توکنایزیشن، مکانیزم حافظه KV Cache و پارامترهای نمونهبرداری به یک ضرورت مهندسی غیرقابل چشمپوشی تبدیل میشود.
مقدمه: عبور از جعبه سیاه مدلهای زبانی در مهندسی نرمافزار
هوش مصنوعی در سالهای اخیر از یک شاخه تئوریک در آزمایشگاههای دانشگاهی، به قلب تپنده معماریهای نرمافزاری مدرن مهاجرت کرده است. ما روزانه برای تولید کد، تحلیل دادهها، ترجمه اسناد و پاسخگویی به مشتریان از مدلهای زبانی استفاده میکنیم. اما در لایههای زیرین این ابزارها چه میگذرد؟ آیا این سیستمها به راستی «فکر» میکنند یا یک موتور محاسباتی احتمالاتی بینهایت پیشرفته هستند؟
پاسخ مهندسی دقیق این است: مدلهای زبانی بزرگ (Large Language Models)، شبکههای عصبی عمیق مبتنی بر ترنسفورمر هستند که به عنوان موتورهای پیشبینی خودبازگشتی توکن بعدی (Auto-Regressive Next-Token Predictors) کار میکنند. وظیفه اصلی مدل این است که با دریافت دنبالهای از نشانههای متنی، محتملترین توکن بعدی را بر پایه میلیاردها ضرب داخلی ماتریسی محاسبه کند. درک اینکه این کلمات چگونه به عدد تبدیل میشوند، چگونه در لایههای توجه پردازش میگردند و چگونه توکن نهایی انتخاب میشود، کلید ساخت سیستمهای پایدار هوش مصنوعی است.
توکنایزیشن و تبدیل متن به بردار (Tokenization & Byte-Pair Encoding)
کامپیوترها و پردازندههای گرافیکی (GPUs) قادر به درک حروف، کلمات یا متون زبان طبیعی نیستند؛ آنها منحصراً با اعداد صحیح، شناور و محاسبات برداری سر و کار دارند. اولین گام در هر پایپلاین مدل زبانی، خردسازی متن به واحدهای بنیادین به نام توکن (Token) است.
الگوریتم BPE و فشردهسازی واژگان
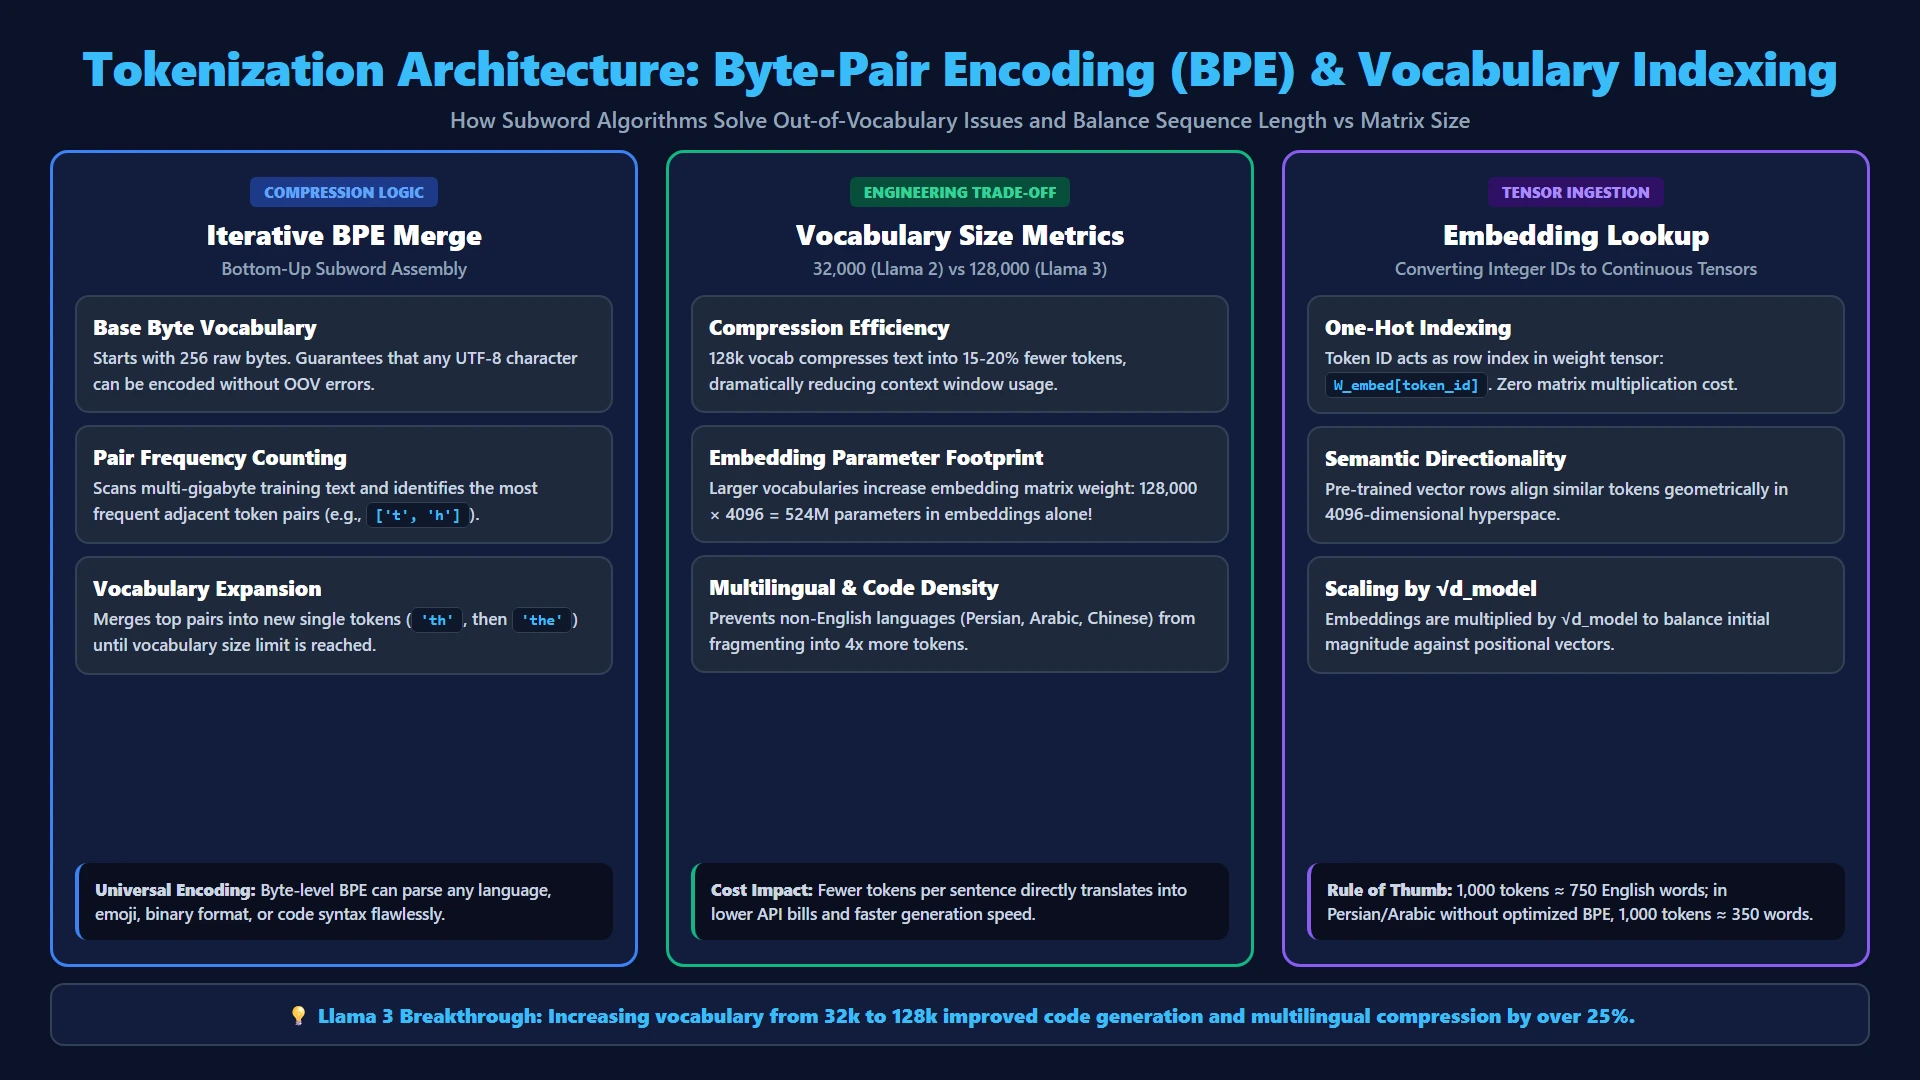
رویکردهای ابتدایی مانند تقسیم متن بر اساس فاصله (Word-level) با چالش واژگان ناشناخته (Out-Of-Vocabulary) مواجه میشدند و رویکرد کاراکتری (Character-level) طول توالی را به شدت طولانی میکرد که هزینه محاسباتی O(N^۲) ترنسفورمر را منفجر میساخت. راهکار استاندارد صنعت، Byte-Pair Encoding (BPE) است.
در الگوریتم BPE در سطح بایت (Byte-level BPE)، ابتدا تمام متون به ۲۵۶ بایت پایه استاندارد UTF-۸ نگاشت میشوند. سپس طی آموزش توکنایزر روی ترابایتها متن، جفتبایتهایی که بیشترین تکرار را کنار هم دارند (مانند th و سپس the) با یکدیگر ادغام شده و یک نشانه جدید در واژگان (Vocabulary) ثبت میکنند. این فرآیند تا رسیدن به ظرفیت مشخصی از واژگان (مثلاً ۳۲,۰۰۰ در Llama ۲ یا ۱۲۸,۰۰۰ در Llama ۳ و GPT-۴) ادامه مییابد. مزیت این رویکرد، توانایی پردازش بینقص هر زبان ناشناخته، ایموجی، رشته کد یا فایل بدون بروز خطای OOV است.
import tiktoken

def inspect_tokenization_mechanics(text: str):
    """
    Demonstrates Byte-Pair Encoding (BPE) tokenization, token IDs,
    and byte-level subword boundary reconstruction using tiktoken (cl۱۰۰k_base).
    """
    encoding = tiktoken.get_encoding("cl۱۰۰k_base")

    # Encode text into discrete integer token IDs
    token_ids = encoding.encode(text)

    print(f"Original Text: {text}")
    print(f"Total Tokens: {len(token_ids)}")
    print("-" * ۵۰)

    # Inspect individual subwords and byte representations
    for idx, token_id in enumerate(token_ids):
        token_bytes = encoding.decode_single_token_bytes(token_id)
        token_str = token_bytes.decode('utf-۸', errors='replace')
        print(f"Token #{idx:۰۲d} | ID: {token_id:<۶} | Byte Representation: {repr(token_str)}")

# Example: Technical sentence with code and Persian words
sample_prompt = "def calculate_loss(pred, target): return cross_entropy(pred, target)"
inspect_tokenization_mechanics(sample_prompt)
فضای برداری امبدینگ و نگاشت معنایی توکنها
پس از تبدیل متن به شناسههای عددی، شناسه هر توکن به عنوان اندیس در یک ماتریس وزن غولپیکر به نام ماتریس امبدینگ (Embedding Matrix) عمل میکند. اگر واژگان مدل دارای ۱۲۸,۰۰۰ توکن و بعد مدل (d_model) برابر ۴۰۹۶ باشد، ماتریس امبدینگ دارای ۵۲۴ میلیون پارامتر اختصاصی است. با قرار گرفتن شناسه در این جدول، یک بردار پیوسته ۴۰۹۶ بعدی استخراج میشود که بار معنایی و گرامری اولیه آن کلمه را در یک فضای هندسی چندبعدی بازنمایی میکند.
کالبدشکافی مکانیزم توجه (Attention Mechanism) و فرمول ریاضی آن
پیش از ظهور مقاله تاریخی Attention Is All You Need در سال ۲۰۱۷ توسط محققان گوگل، شبکههای بازگشتی (RNN و LSTM) متون را کلمه به کلمه پردازش میکردند. این فرآیند ترتیبی نه تنها مانع پردازش موازی روی GPUها میشد، بلکه با رسیدن به کلمه پنجاهم، اطلاعات کلمه اول به دلیل مشکل فراموشی گرادیان محو میگردید.
مکانیزم توجه خودکار (Self-Attention) این بنبست را شکست؛ در این مکانیزم، هر کلمه در یک جمله میتواند به طور همزمان و در کسر ثانیه با تمام کلمات دیگر جمله گفتگو کند و میزان ارتباط خود را بسنجد.
محاسبه ماتریسهای Query، Key و Value
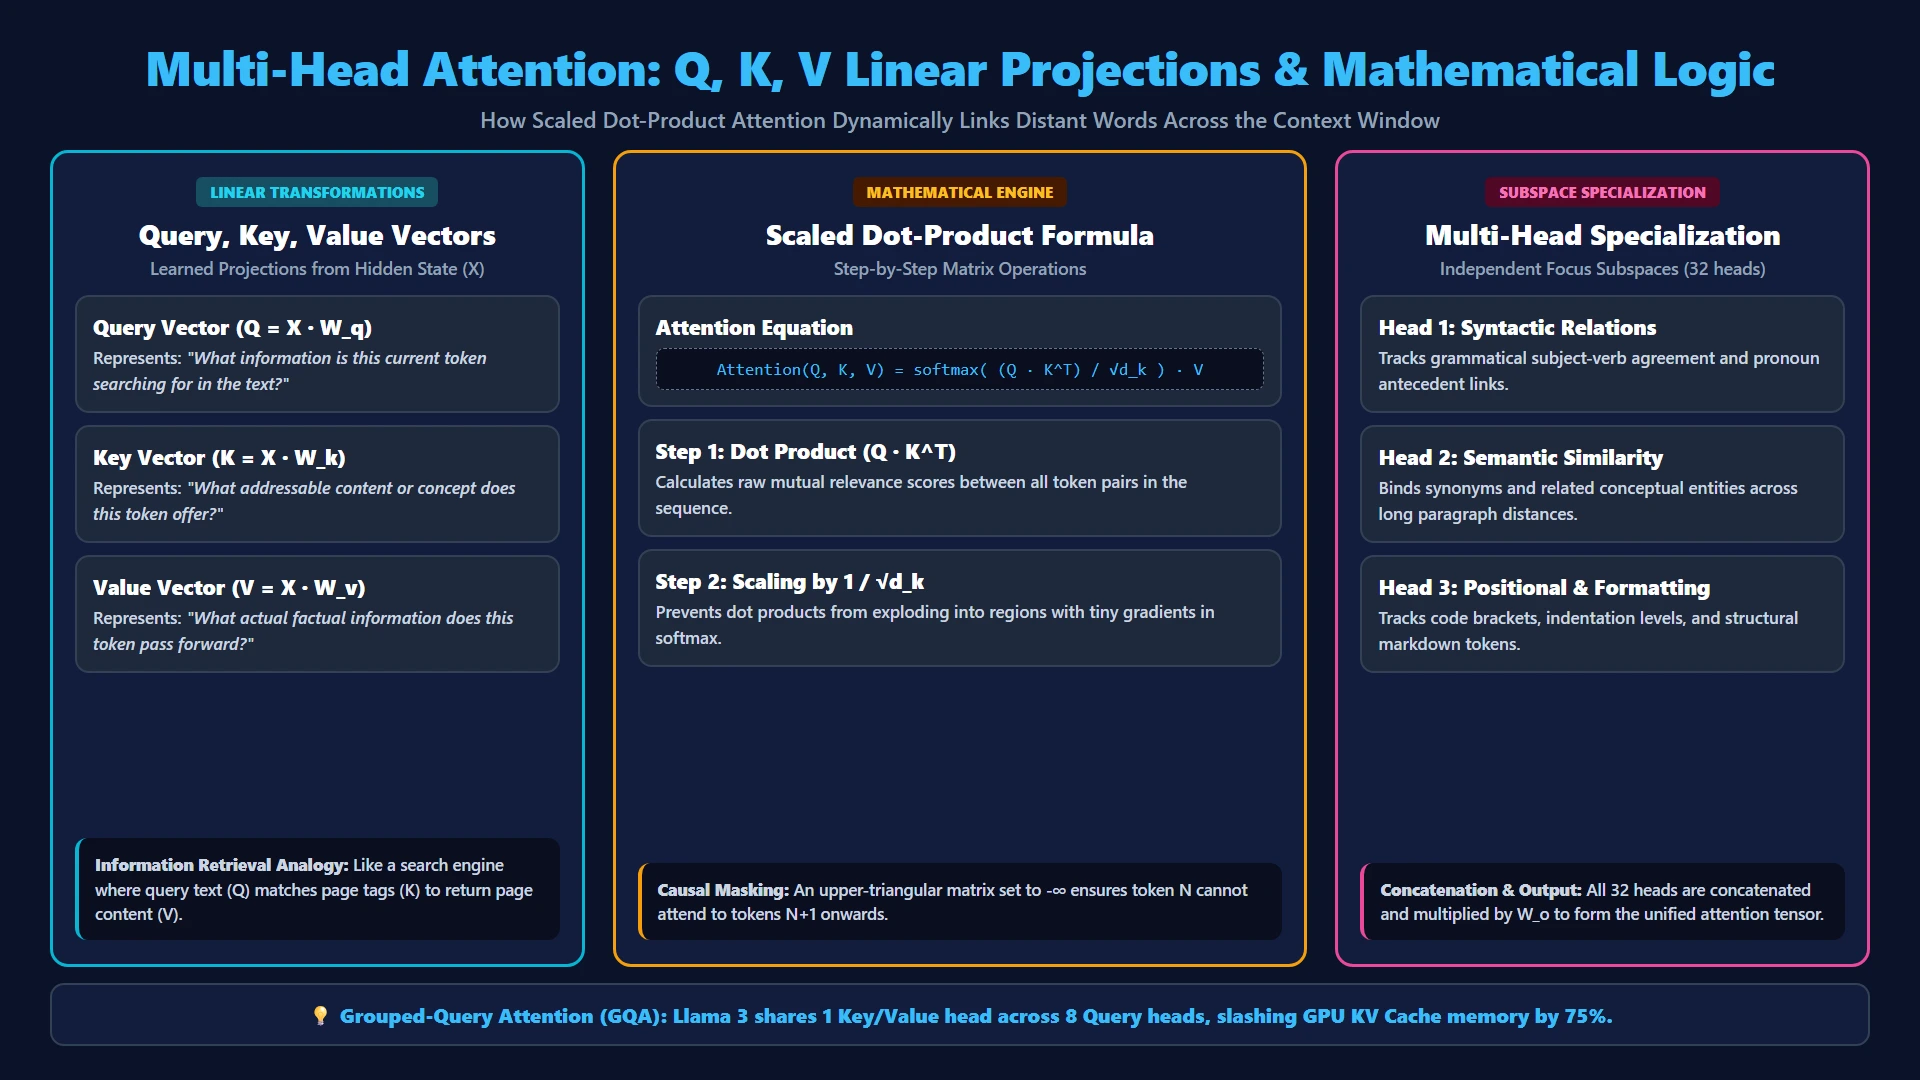
برای درک شهودی مکانیزم توجه، یک سامانه بازیابی اطلاعات یا موتور جستجو را تصور کنید:
- Query (پرسش): برداری که میگوید «این توکن به دنبال چه اطلاعاتی در کانتکست پیرامون خود میگردد؟»
- Key (کلید): برداری که اعلام میکند «این توکن چه نوع محتوا و هویتی را به دیگران ارائه میدهد؟»
- Value (ارزش): محتوای واقعی و داده معنایی خام که در صورت همخوانی، منتقل خواهد شد.
هر بردار توکن ورودی در سه ماتریس وزن آموزشپذیر (W_q, W_k, W_v) ضرب میشود تا بردارهای Q، K و V تولید شوند. سپس ضرب داخلی Query یک کلمه با Key کلمات دیگر محاسبه میشود. هرچه زاویه بین این دو بردار کوچکتر باشد، حاصلضرب بزرگتر بوده و نشان میدهد این دو کلمه پیوند مفهومی عمیقی دارند. این مقادیر بر جذر بعد کلید (√d_k) تقسیم میشوند تا از انفجار گرادیان در تابع Softmax جلوگیری شود.
import math
import torch
import torch.nn as nn
import torch.nn.functional as F

class MultiHeadSelfAttention(nn.Module):
    """
    Scaled Dot-Product Multi-Head Self-Attention Block.
    Implements causal masking to prevent future token leakage in Decoder LLMs.
    """
    def __init__(self, d_model: int = ۴۰۹۶, n_heads: int = ۳۲):
        super().__init__()
        assert d_model % n_heads == ۰, "d_model must be divisible by n_heads"
        self.d_model = d_model
        self.n_heads = n_heads
        self.d_k = d_model // n_heads

        # Linear projections for Query, Key, and Value
        self.w_q = nn.Linear(d_model, d_model, bias=False)
        self.w_k = nn.Linear(d_model, d_model, bias=False)
        self.w_v = nn.Linear(d_model, d_model, bias=False)
        self.w_o = nn.Linear(d_model, d_model, bias=False)

    def forward(self, x: torch.Tensor, mask: bool = True) -> torch.Tensor:
        batch_size, seq_len, _ = x.shape

        # ۱. Project and reshape to [batch, n_heads, seq_len, d_k]
        q = self.w_q(x).view(batch_size, seq_len, self.n_heads, self.d_k).transpose(۱, ۲)
        k = self.w_k(x).view(batch_size, seq_len, self.n_heads, self.d_k).transpose(۱, ۲)
        v = self.w_v(x).view(batch_size, seq_len, self.n_heads, self.d_k).transpose(۱, ۲)

        # ۲. Scaled Dot-Product Attention: (Q · K^T) / sqrt(d_k)
        scores = torch.matmul(q, k.transpose(-۲, -۱)) / math.sqrt(self.d_k)

        # ۳. Apply Causal Upper-Triangular Mask (Auto-regressive property)
        if mask:
            causal_mask = torch.triu(torch.full((seq_len, seq_len), float('-inf'), device=x.device), diagonal=۱)
            scores = scores + causal_mask

        # ۴. Softmax probability distribution over context
        attention_weights = F.softmax(scores, dim=-۱)

        # ۵. Multiply weights by Value vectors and concatenate heads
        context = torch.matmul(attention_weights, v)
        context = context.transpose(۱, ۲).contiguous().view(batch_size, seq_len, self.d_model)

        # ۶. Final linear output projection
        return self.w_o(context)
مکانیزم توجه چندسر (Multi-Head Attention)
در عمل، یک لایه توجه واحد کافی نیست؛ زیرا یک کلمه ممکن است همزمان دارای روابط دستوری (فاعل و فعل)، روابط معنایی (مترادفها)، و مراجع ضمیر باشد. در Multi-Head Attention، بردارها به چندین بخش موازی (مثلاً ۳۲ یا ۶۴ سر) شکسته میشوند. هر سر توجه در یک زیرفضای مستقل تخصص مییابد؛ یک سر توجه روابط فاعل و فعل را ردیابی میکند و سر دیگر تطابق براکتهای باز و بسته در کدهای پایتون را زیر نظر میگیرد.
معماری بلوک ترنسفورمر: لایههای Feed-Forward، اتصالات Residual و نرمالسازی
مدلهای مدرن نظیر Llama ۳ و GPT-۴ از استک کردن دهها بلوک دیکودر متوالی روی هم تشکیل شدهاند (مثلاً ۳۲ لایه در مدل ۸B و ۱۲۶ لایه در مدل ۴۰۵B). دادههای متنی پس از عبور از لایه توجه، وارد اجزای تثبیتکننده حیاتی میشوند:
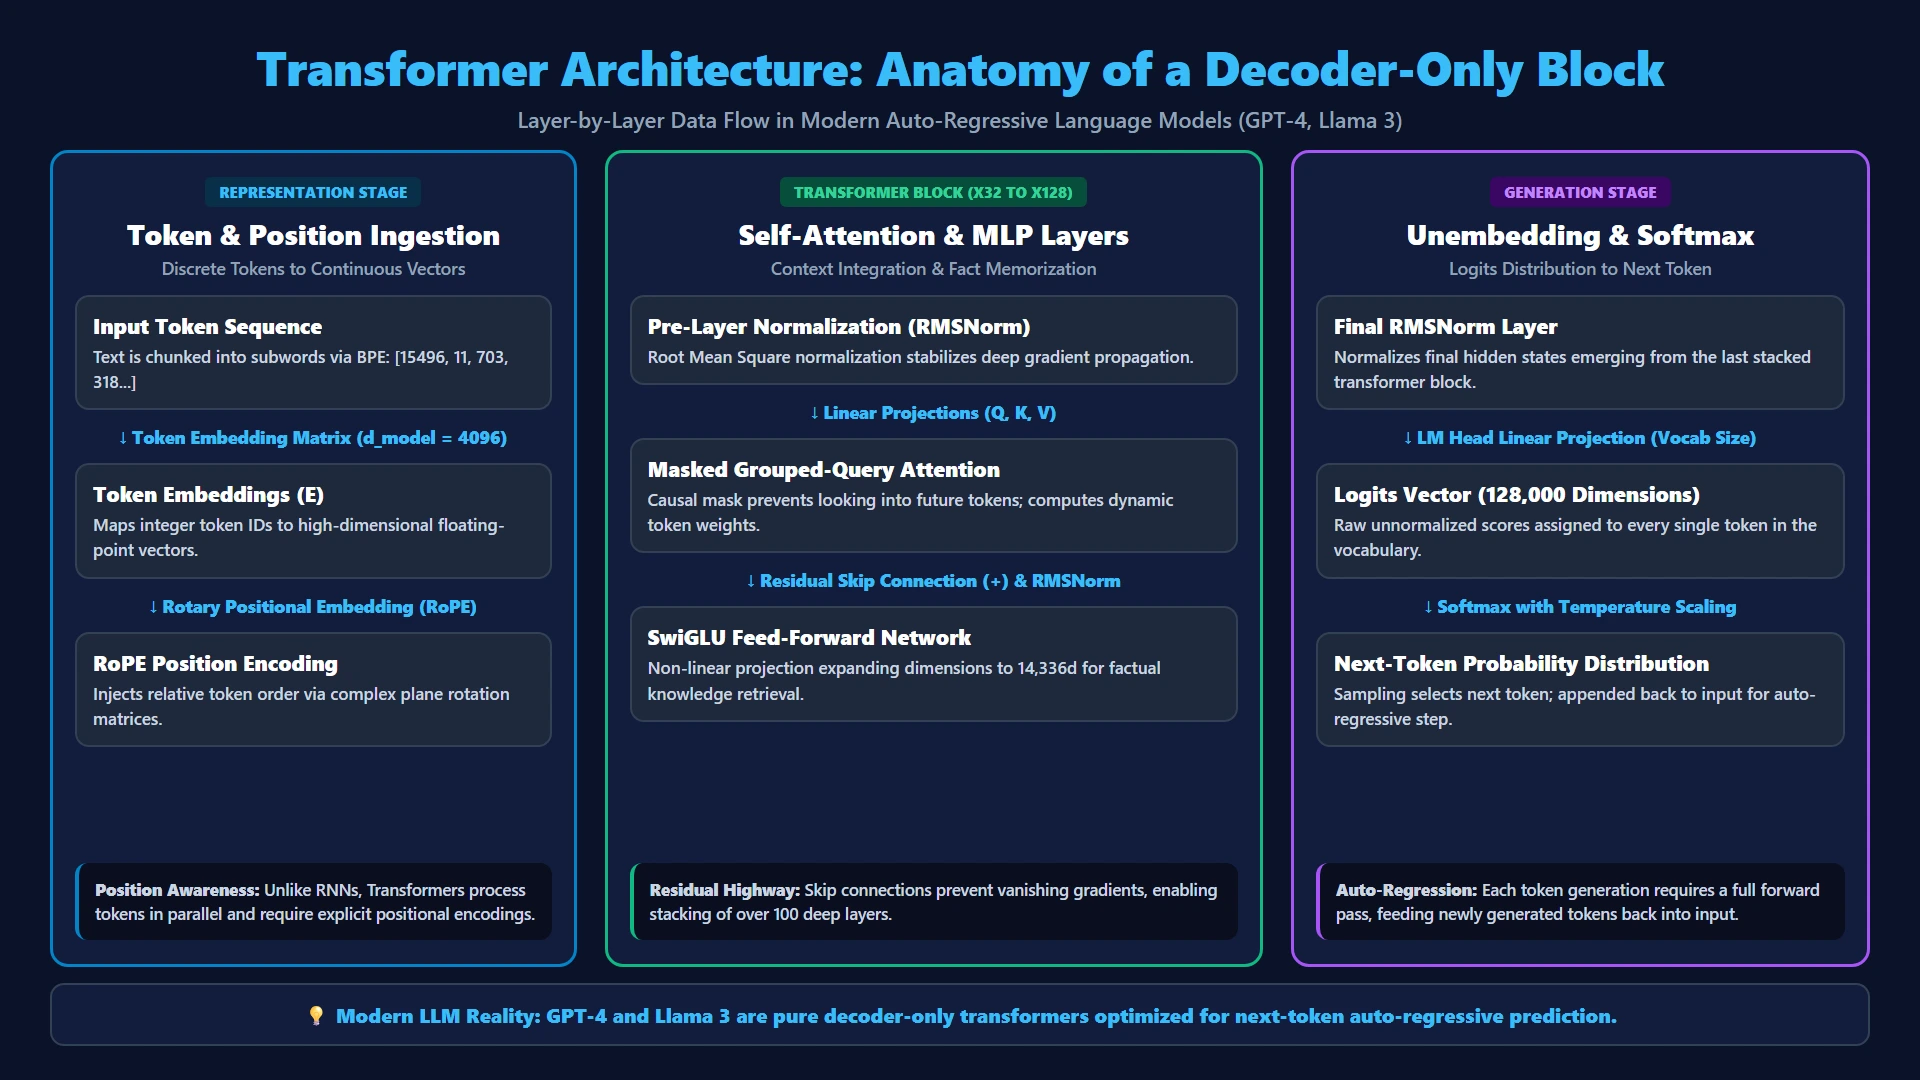
اتصالات میانبر (Residual Skip Connections) ستون فقرات پایداری آموزش در مدلهای صد لایهای هستند. در این ساختار، بردار ورودی قبل از ورود به لایه توجه، مستقیماً به خروجی آن اضافه میشود (x + SubLayer(x)). این بزرگراه اطلاعاتی باعث میشود سیگنال خطا و گرادیانها در طول پسانتشار (Backpropagation) بدون تضعیف به لایههای اولیه برسند.
همچنین شبکه عصبی پیشخور (Feed-Forward Network یا MLP) با تابع فعالساز SwiGLU بعد بردار را تا بیش از ۳ برابر منبسط کرده و فشرده میکند. تحقیقات بیومکانیک شبکههای عصبی نشان میدهد حافظه دانشی، حقایق علمی و دایرهالمعارف مدل عمدتاً در وزنهای لایه FFN ذخیره میشوند، در حالی که لایه Attention وظیفه مسیریابی و استدلال را بر دوش دارد.
چرخه حیات مدلهای زبانی: از پیشآموزش تا تراز نهایی
تبدیل گیگابایتها متن بیساختار اینترنت به یک دستیار هوشمند، مؤدب و کدنویس نیازمند عبور از سه مرحله آموزش دقیق و مهندسیشده است:
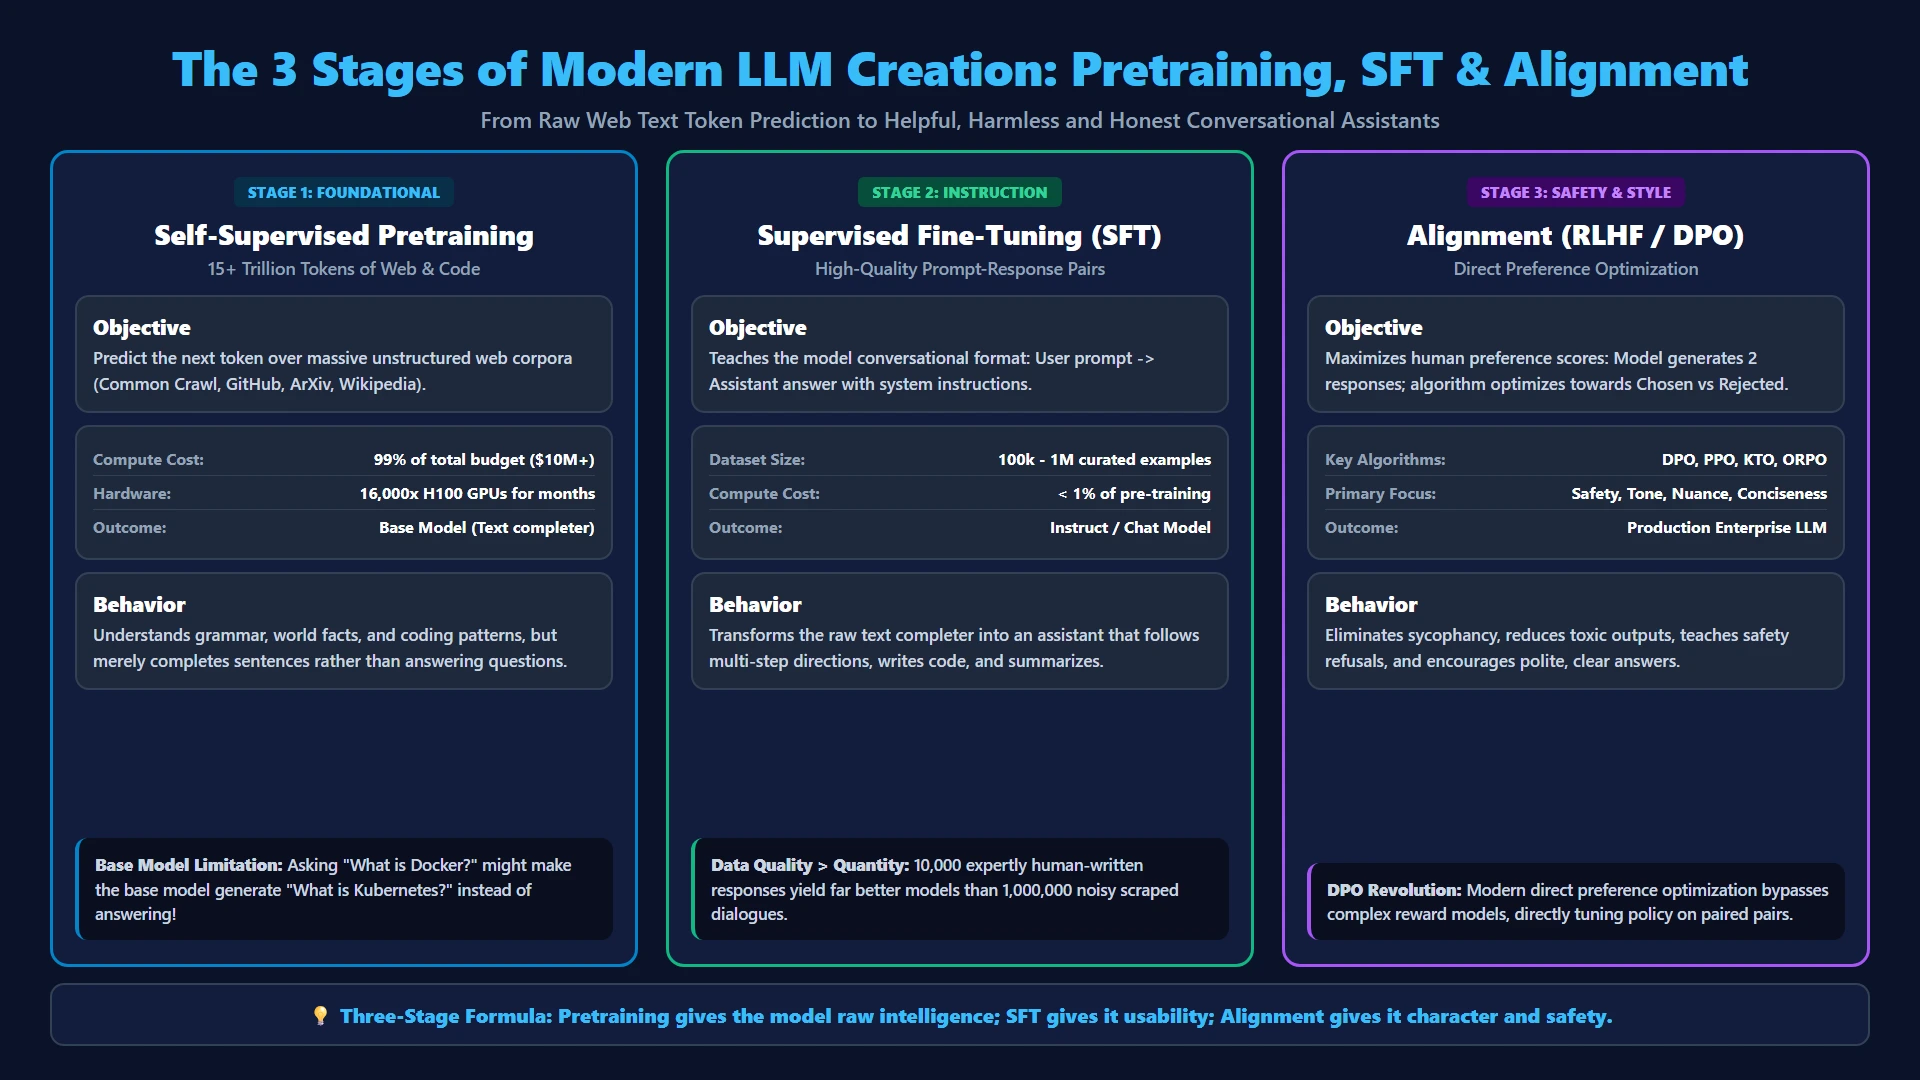
مرحله پیشآموزش اولیه (Self-Supervised Pre-training)
در این گام، مدل بر روی ۱۵ تا ۲۰ تریلیون توکن از اسناد وب، مقالات ویکیپدیا، مخازن کد گیتهاب و کتب علمی آموزش داده میشود. هیچ برچسب دستی انسانی وجود ندارد؛ مدل صرفاً کلمه بعدی متن را حدس میزند و خطای خود را با تابع Cross-Entropy کاهش میدهد. بیش از ۹۹ درصد هزینه مالی و زمانی پروژه (میلیونها دلار و کلاسترهای ۱۶,۰۰۰ عددی Nvidia H۱۰۰) در این مرحله صرف میشود. خروجی این فاز، مدل پایه (Base Model) است که صرفاً یک موتور پیشبینی متن است؛ یعنی اگر از او بپرسید «پایتون چیست؟»، ممکن است سوال را ادامه دهد و بنویسد «جاوا چیست؟» به جای آنکه پاسخ سوال را ارائه کند!
تنظیم دقیق دستورمحور (Supervised Fine-Tuning - SFT)
برای تبدیل مدل پایه به دستیار گفتگو، مدل روی صدها هزار جفت «پرسش و پاسخ باکیفیت انسانی» با دستورات سیستمی مشخص (System Instructions) بازآموزی میشود. در این مرحله مدل یاد میگیرد چگونه به پرسشها پاسخ مستقیم دهد، کدهای تمیز تولید کند و ساختار گفتگو را درک نماید. کیفیت داده در مرحله SFT بسیار مهمتر از حجم آن است؛ ده هزار نمونه بینقص خروجی بسیار بهتری از یک میلیون گفتگوی شلوغ وب تولید میکند.
همراستاسازی با ترجیحات انسانی (RLHF و DPO)
آخرین گام، آموزش با بازخورد انسانی (Reinforcement Learning from Human Feedback) یا الگوریتم مدرن DPO (Direct Preference Optimization) است. در این فرآیند، برای یک پرسش، مدل دو پاسخ متفاوت تولید میکند و ارزیاب انسانی مشخص میکند کدام پاسخ مفیدتر، صادقانهتر و بیخطرتر است. مدل یاد میگیرد از تملقگویی، تولید کدهای آسیبپذیر امنیتی، راهنماییهای خطرناک و زیادهگویی پرهیز کند.
پارامترهای نمونهبرداری و دیکودینگ: کنترل خلاقیت و تکرار در خروجی
در مرحله استنتاج (Inference)، خروجی نهایی مدل یک بردار از اعداد خام به نام Logits است که به ازای تکتک توکنهای واژگان امتیازدهی شده است. نحوه تبدیل این اعداد به کلمه بعدی با پارامترهای دیکودینگ کنترل میشود:
import torch
import torch.nn.functional as F

def sample_next_token(
    logits: torch.Tensor,
    temperature: float = ۰.۷,
    top_k: int = ۵۰,
    top_p: float = ۰.۹,
    repetition_penalty: float = ۱.۱۵,
    generated_tokens: list = None
) -> int:
    """
    Advanced Auto-Regressive Decoding Engine.
    Applies repetition penalties, temperature scaling, Top-K, and Nucleus (Top-P) filtering.
    """
    # ۱. Apply Repetition Penalty to prevent degenerate loops
    if generated_tokens and repetition_penalty != ۱.۰:
        for token_id in set(generated_tokens):
            if logits[token_id] < ۰:
                logits[token_id] *= repetition_penalty
            else:
                logits[token_id] /= repetition_penalty

    # ۲. Temperature Scaling (Lower = Deterministic, Higher = Creative)
    logits = logits / max(temperature, ۱e-۵)

    # ۳. Top-K Filtering: Keep only top K highest probability tokens
    if top_k > ۰:
        top_k_threshold = torch.topk(logits, min(top_k, logits.size(-۱)))[۰][-۱]
        logits[logits < top_k_threshold] = float('-inf')

    # ۴. Top-P (Nucleus) Filtering: Cumulative probability cutoff
    if ۰.۰ < top_p < ۱.۰:
        sorted_logits, sorted_indices = torch.sort(logits, descending=True)
        cumulative_probs = torch.cumsum(F.softmax(sorted_logits, dim=-۱), dim=-۱)

        # Remove tokens with cumulative probability above threshold
        sorted_indices_to_remove = cumulative_probs > top_p
        sorted_indices_to_remove[۱:] = sorted_indices_to_remove[:-۱].clone()
        sorted_indices_to_remove[۰] = False

        indices_to_remove = sorted_indices[sorted_indices_to_remove]
        logits[indices_to_remove] = float('-inf')

    # ۵. Multinomial probabilistic sampling from remaining candidate tokens
    probabilities = F.softmax(logits, dim=-۱)
    next_token_id = torch.multinomial(probabilities, num_samples=۱).item()
    return next_token_id
نقش پارامتر دما (Temperature) در توزیع احتمال Softmax
پارامتر دما (Temperature) به عنوان مخرج کسر درون تابع سافتمکس قرار میگیرد (logits / T). با تنظیم دما روی مقادیر نزدیک به صفر (مانند T=۰.۰ یا ۰.۲)، تفاوت امتیاز کلمات تشدید شده و مدل همیشه کلمهای با بالاترین قطعیت ریاضی را انتخاب میکند (Greedy Decoding) که برای حل مسائل ریاضی، نگارش کدهای حساس و استخراج داده ایدهآل است. برعکس، با افزایش دما (T=۰.۸ تا ۱.۰)، توزیع احتمالات هموارتر شده و مدل شانس انتخاب کلمات نامعمولتر را پیدا میکند که موجب خلاقیت داستانی و طوفان فکری میشود.
استراتژیهای Top-K و Top-P (Nucleus Sampling)
روش Top-K انتخابها را منحصراً به K توکن برتر محدود میکند و توکنهای کماحتمال را حذف میسازد. روش پیشرفتهتر Top-P یا نمونهبرداری هستهای (Nucleus Sampling) است؛ در این روش، توکنها بر اساس احتمال نزولی مرتب شده و تنها کلماتی وارد حلقه انتخاب میشوند که مجموع احتمال تجمعی آنها به آستانه P (مثلاً ۹۰ درصد) برسد. این مکانیزم مانع افتادن مدل در تله جملات بیمعنی یا تکراری میشود.
بهینهسازی کارایی در زمان اجرا: حافظه پنهان KV Cache و FlashAttention
بزرگترین گلوگاه مدلهای زبانی در پروداکشن، هزینه حافظه و پهنای باند است. از آنجا که مدل توکن به توکن به صورت خودبازگشتی خروجی میدهد، برای تولید توکن پانصدم نباید ماتریسهای Key و Value برای ۴۹۹ توکن قبلی مجدداً از اول محاسبه شوند!
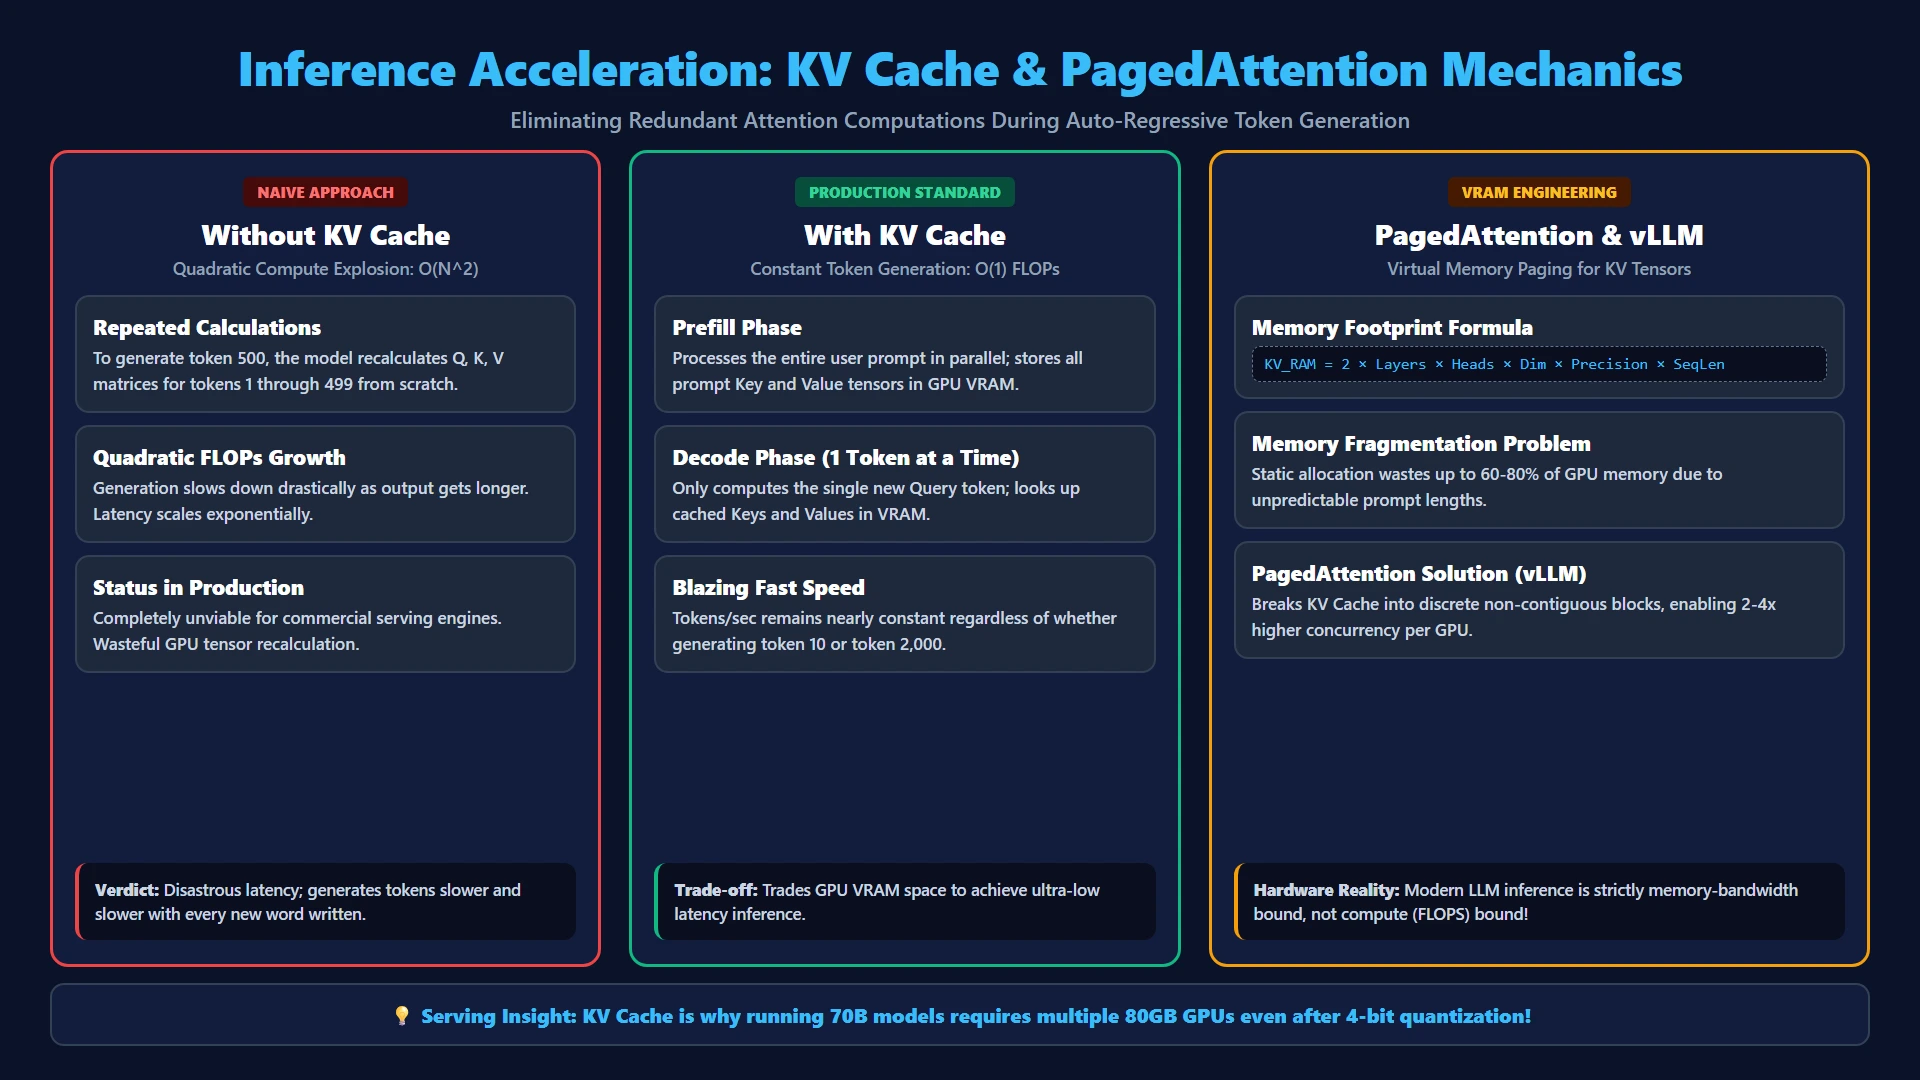
from typing import Tuple, Optional
import torch

class KVCache:
    """
    Key-Value Cache for auto-regressive inference acceleration.
    Stores past token Keys and Values to maintain O(۱) FLOPs per generated token.
    """
    def __init__(self, max_batch_size: int, max_seq_len: int, n_heads: int, d_k: int, device: str = "cuda"):
        self.k_cache = torch.zeros((max_batch_size, n_heads, max_seq_len, d_k), device=device)
        self.v_cache = torch.zeros((max_batch_size, n_heads, max_seq_len, d_k), device=device)
        self.current_seq_len = ۰

    def update(
        self,
        new_k: torch.Tensor,
        new_v: torch.Tensor
    ) -> Tuple[torch.Tensor, torch.Tensor]:
        """
        Appends new token keys/values to the cache and returns full history.
        new_k: [batch, n_heads, new_tokens, d_k]
        """
        start_pos = self.current_seq_len
        new_tokens = new_k.shape[۲]
        end_pos = start_pos + new_tokens

        # In-place tensor assignment in GPU VRAM
        self.k_cache[:, :, start_pos:end_pos, :] = new_k
        self.v_cache[:, :, start_pos:end_pos, :] = new_v
        self.current_seq_len = end_pos

        return self.k_cache[:, :, :end_pos, :], self.v_cache[:, :, :end_pos, :]
با بهرهگیری از KV Cache، ماتریسهای Key و Value توکنهای گذشته درون حافظه پرسرعت VRAM کارت گرافیک نگهداری میشوند و برای توکن جدید تنها بردار Query محاسبه میشود. همچنین الگوریتم سختافزاری FlashAttention با سازماندهی دادهها در حافظه کش محلی SRAM پردازنده گرافیکی، نیاز به تبادل مداوم داده با حافظه اصلی GPU (HBM) را حذف کرده و سرعت استنتاج را تا ۴ برابر افزایش میدهد.
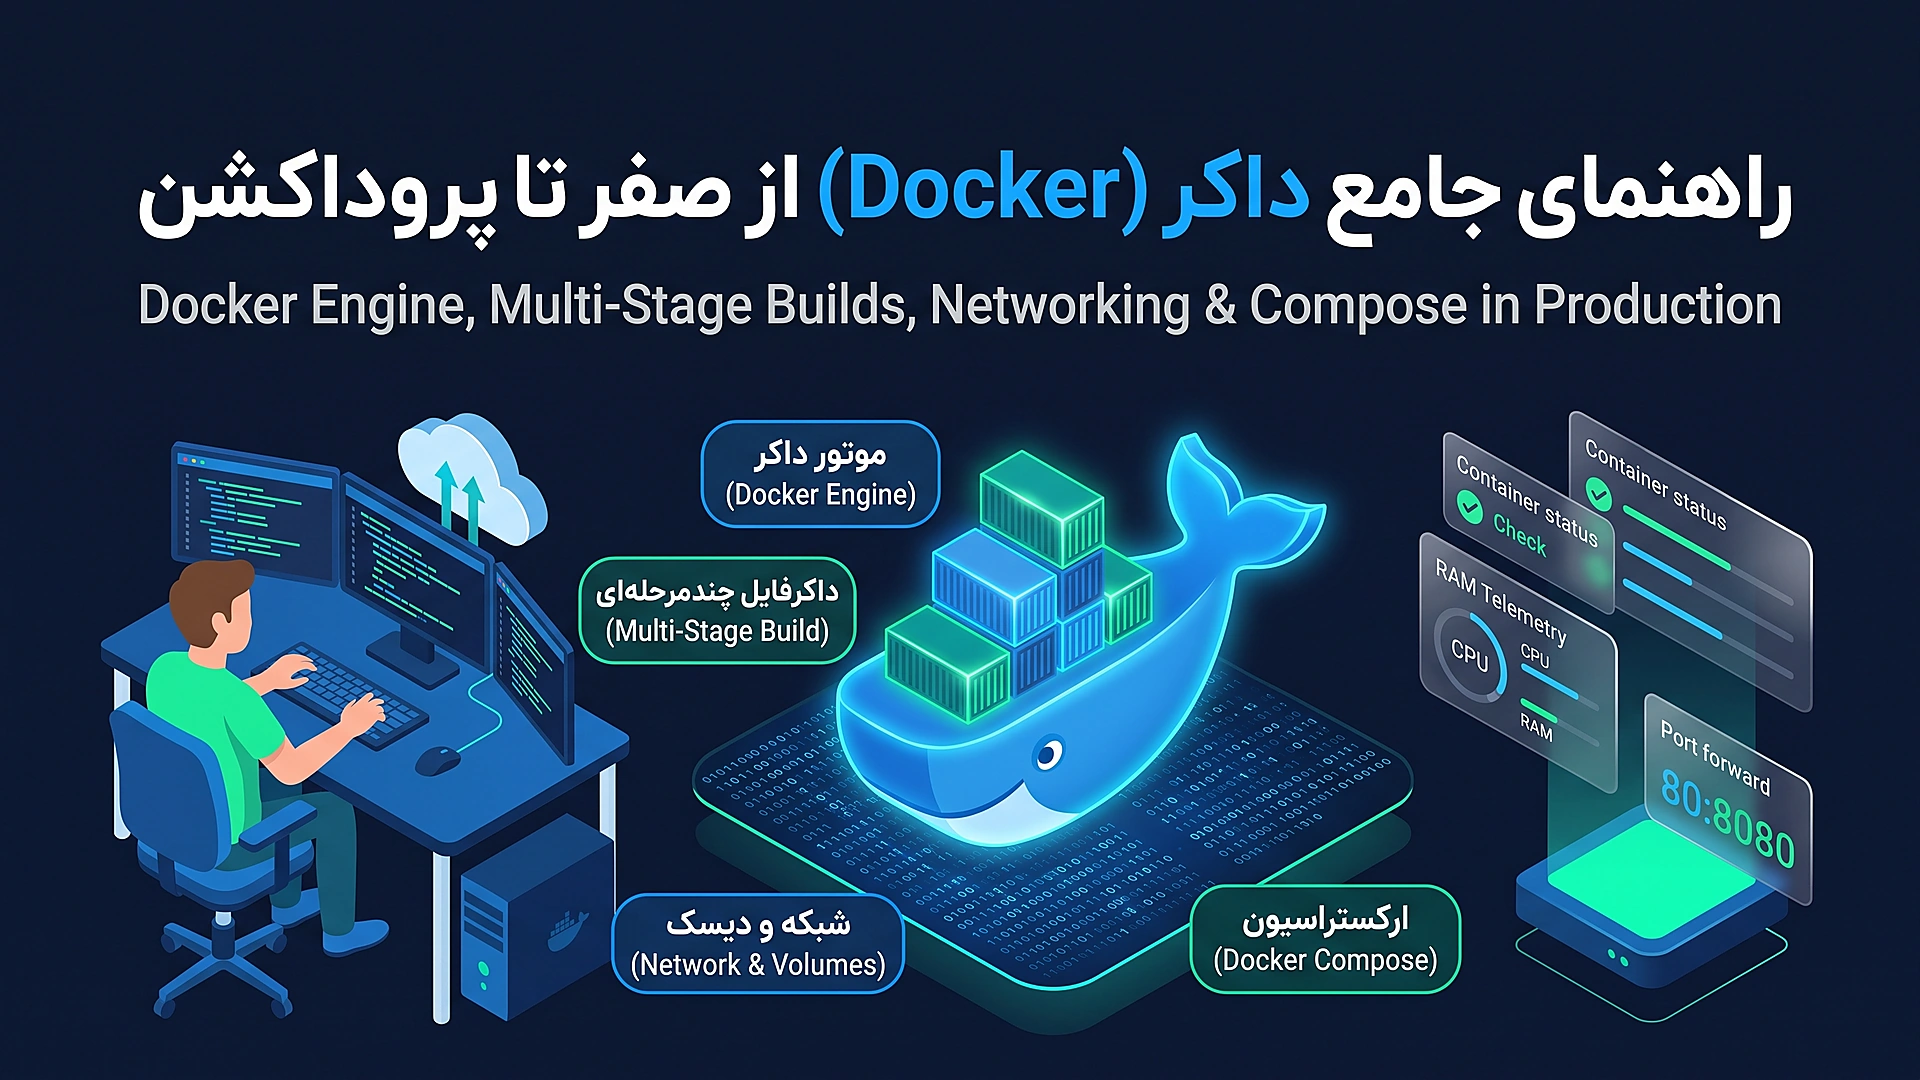
کانتینرسازی و استقرار سرور استنتاج محلی مدلها با داکر
در سازمانهایی با الزامات محرمانگی شدید اطلاعات مالی و هویتی، استفاده از APIهای ابری عمومی مجاز نیست. مهندسان سیستم با ابزارهایی چون vLLM و Ollama میتوانند مدلهای قدرتمند متنباز نظیر Llama ۳ یا DeepSeek را در زیرساخت ابری اختصاصی کانتینریزه کرده و سرویس دهند:
# Production Docker Stack for High-Throughput Local LLM Inference Server (vLLM)
services:
  llm_inference_engine:
    image: vllm/vllm-openai:v0.4.2
    container_name: local_llm_inference
    restart: unless-stopped
    ports:
      - "۸۰۰۰:۸۰۰۰"   # OpenAI-compatible REST API
    environment:
      - MODEL_NAME=meta-llama/Meta-Llama-۳-۸B-Instruct
      - MAX_MODEL_LEN=۸۱۹۲
      - GPU_MEMORY_UTILIZATION=۰.۹۰
      - TENSOR_PARALLEL_SIZE=۱
    volumes:
      - llm_weights_data:/root/.cache/huggingface
    deploy:
      resources:
        reservations:
          devices:
            - driver: nvidia
              count: all
              capabilities: [gpu]
    command: >
      --model meta-llama/Meta-Llama-۳-۸B-Instruct
      --dtype bfloat۱۶
      --enforce-eager
      --port ۸۰۰۰
    healthcheck:
      test: ["CMD-SHELL", "curl -f http://localhost:8000/health || exit ۱"]
      interval: ۳۰s
      timeout: ۱۰s
      retries: ۳
      start_period: ۶۰s

volumes:
  llm_weights_data:
    driver: local
برای آشنایی جامع با اصول مدیریت کانتینرها، پایدارسازی دادهها و شبکه در داکر، مطالعه راهنمای عمیق داکر پیشنهاد میشود:
معماری تمیز در اتصال میکروسرویسها به مدلهای زبانی
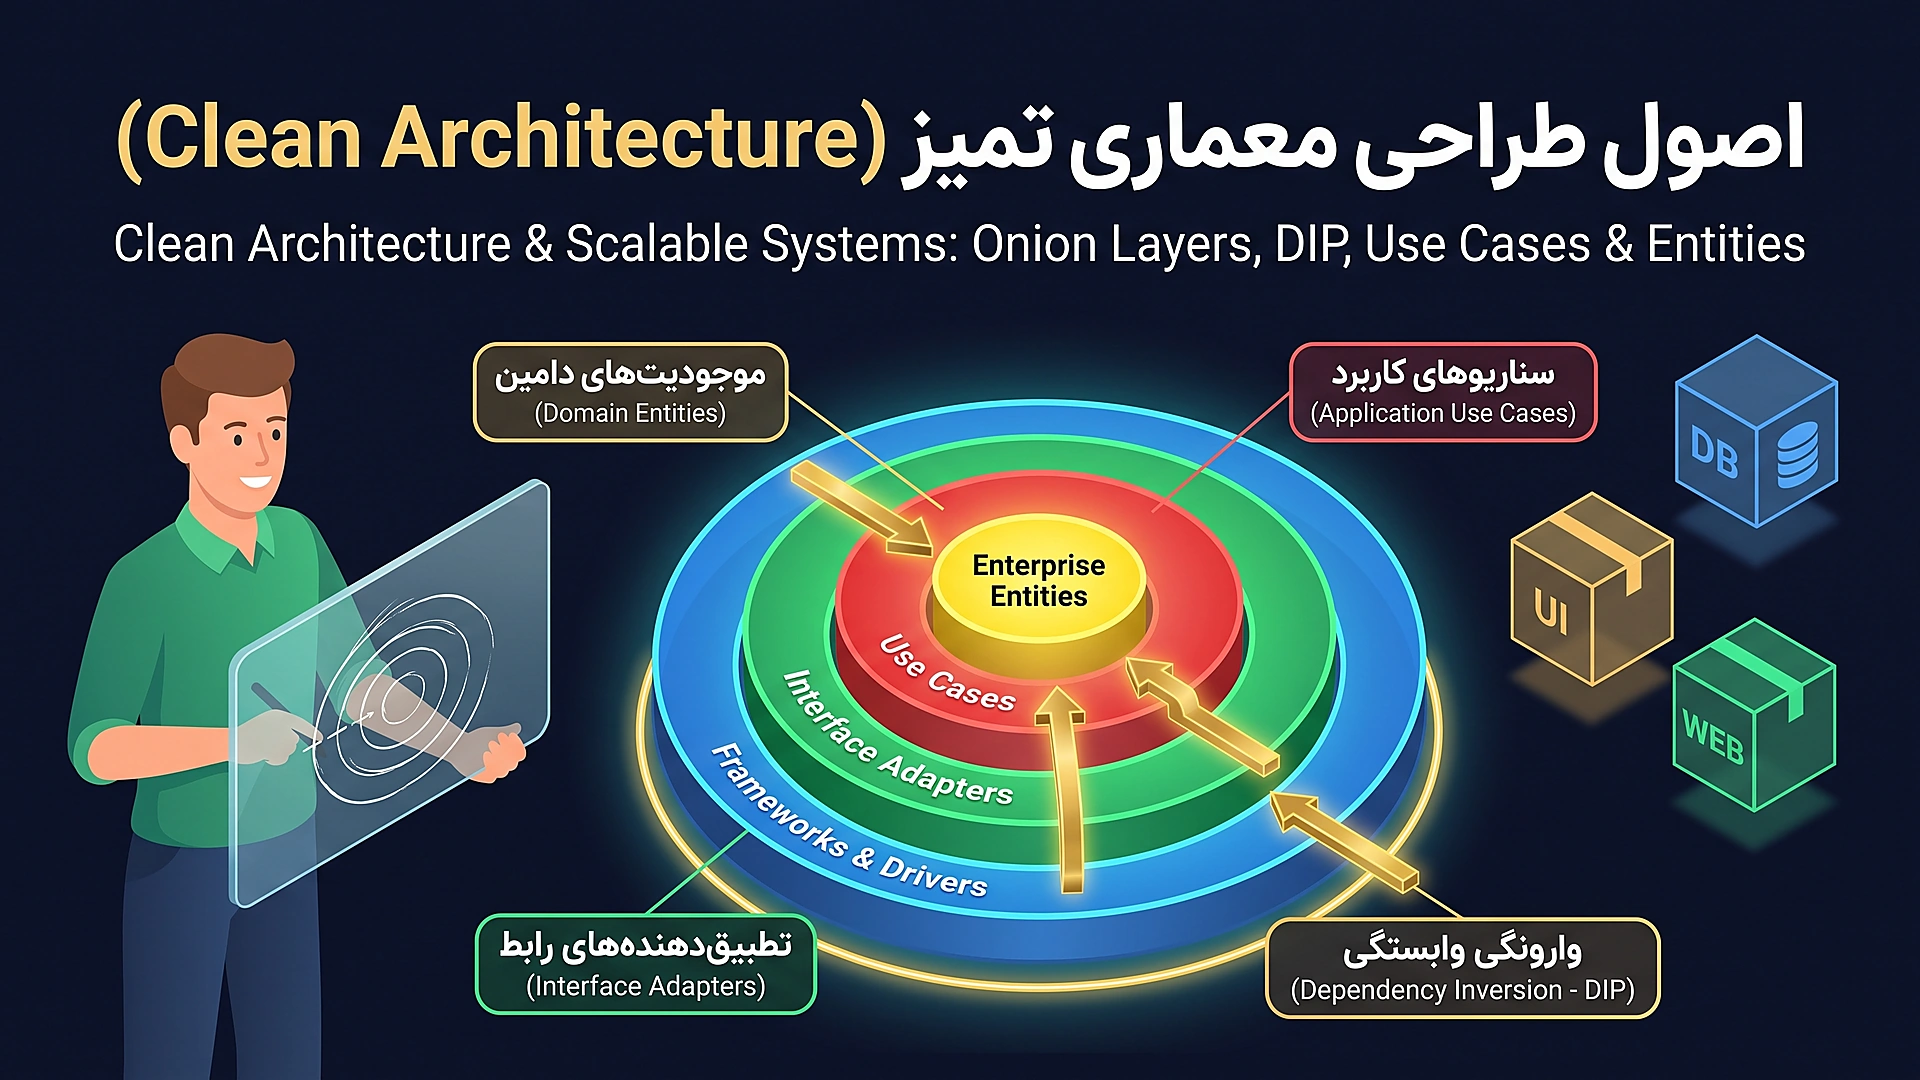
توسعه نرمافزارهای تجاری مبتنی بر هوش مصنوعی نیازمند رعایت اکید تفکیک دغدغههاست. نباید کدهای درخواست HTTP یا SDKهای اختصاصی OpenAI و Anthropic را در هسته منطق تجاری یا کنترلرهای برنامه بنویسید.
با استفاده از اصول معماری تمیز (Clean Architecture)، یک اینترفیس انتزاعی نظیر LLMInferenceGateway در لایه دامنه تعریف میکنیم و پیادهسازیهای اتصال به vLLM محلی، OpenAI یا Claude را به عنوان جزئیات لایه زیرساخت (Infrastructure) در نظر میگیریم. به این ترتیب با تغییر مدل یا جابجایی بین پرووایدرها، کدهای کسبوکار دستنخورده باقی میمانند.
غلبه بر محدودیتهای دانشی LLM با معماری بازیابی RAG
همانطور که در واکاوی معماری ترنسفورمر مشاهده کردید، وزنهای مدل زبانی پس از اتمام مرحله آموزش ثابت (Frozen) میشوند. مدل نمیتواند به دادههای زنده اینترنت، اسناد جدید گیتهاب یا تراکنشهای روزانه سازمان دسترسی داشته باشد و در صورت پرسش درباره وقایع اخیر، دچار توهم آماری خواهد شد.
الگوی تولید مبتنی بر بازیابی (RAG) با اتصال مدل زبانی به دیتابیسهای برداری (مانند Qdrant و Chroma)، حقایق معتبر را در زمان پرسوجو استخراج کرده و به کانتکست پرامپت تزریق مینماید تا مدل به جای حدسزدن، با استنا
نتیجهگیری و افقهای پیش رو در توسعه نرمافزارهای هوشمند
مدلهای زبانی بزرگ شاهکار مهندسی نرمافزار، جبر خطی و بهینهسازی محاسباتی هستند. از الگوریتمهای فشردهسازی BPE گرفته تا ماتریسهای پویای توجه چندسر، ضرب داخلی مقیاسشده و کشینگ حافظه KV Cache، تمامی اجزا برای پیشبینی دقیقتر و هوشمندانهتر کلمات طراحی شدهاند.
مهندسانی که به این سازوکارهای درونی مسلط باشند، میتوانند پرامپتهایی بهینه و کمهزینه طراحی کنند، با معماری تمیز سیستمهای پایدار خلق نمایند و با ترکیب RAG و کانتینرسازی، نسل بعدی نرمافزارهای سازمانی را پایهریزی کنند.
امتیاز و نظرات
هنوز نظری ثبت نشده است. اولین نفر باشید.