
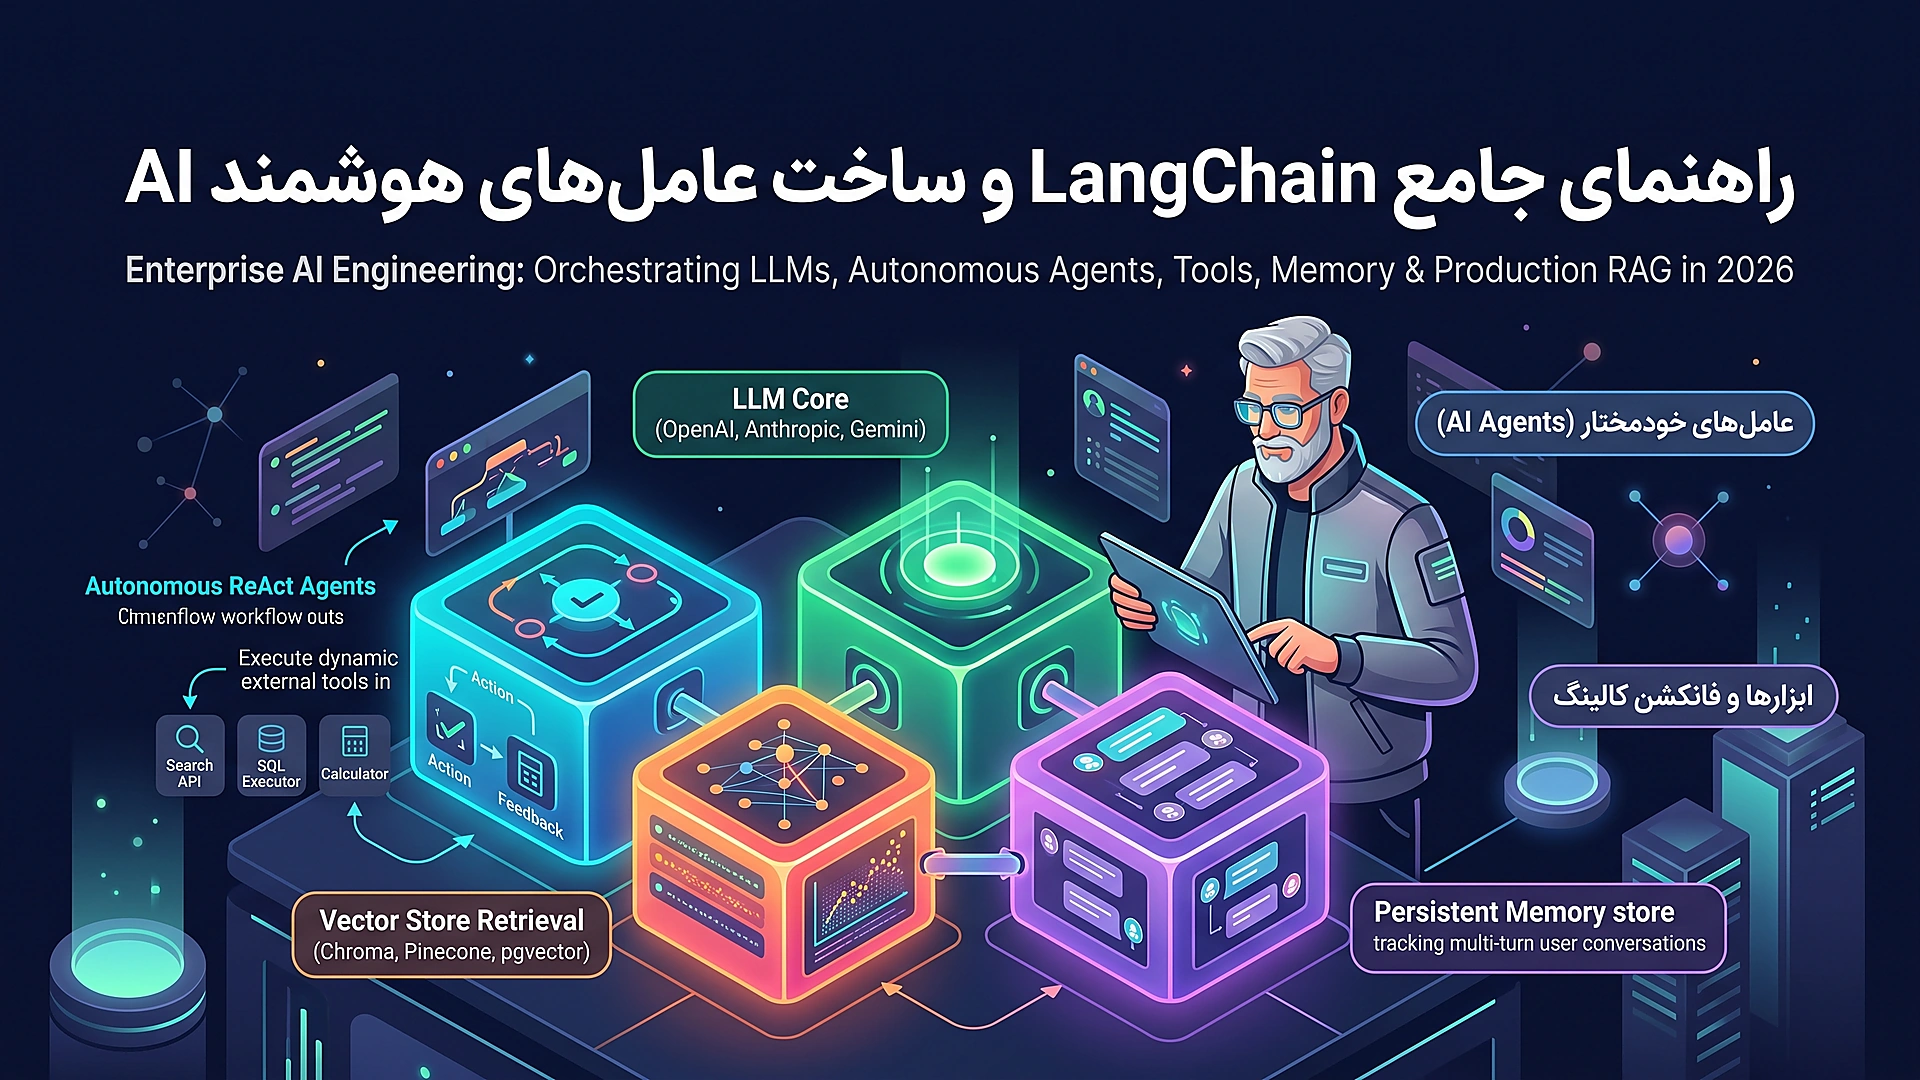
با ظهور نسل جدید مدلهای زبانی بزرگ (LLMs) نظیر GPT-۴o، کلود و جمنای، پارادایم برنامهنویسی دستخوش دگرگونی بنیادینی شد. دیگر مدلهای هوش مصنوعی صرفاً برای تکمیل متن یا ترجمه به کار نمیروند؛ بلکه به عنوان «موتورهای استدلال عمومی» درون معماری سیستمهای نرمافزاری تعبیه میشوند. با این حال، یک مدل زبانی به تنهایی فاقد دسترسی به دادههای اختصاصی سازمان، حافظه بلندمدت و توانایی اجرای اکشن در دنیای واقعی است. برای پر کردن این شکاف مهندسی، فریمورک LangChain متولد شد.
همانطور که در راهنمای طرز کار مدل های زبانی بزرگ (LLM) تبیین کردیم، مدلها بر پایه پیشبینی توکنهای بعدی عمل میکنند و برای تعامل با دنیای بیرونی نیازمند لایههای ارکستریشن هستند. لانگچین این فرآیند را از طریق ماژولار ساختن جریانهای داده، ابزارها و حافظه به استانداردی بینالمللی بدل کرده است.
۱. کالبدشکافی معماری LangChain: کامپوننتها و زبان بیانی LCEL
لانگچین مجموعهای از ماژولهای مستقل و هماهنگ است که هر یک گوشهای از زنجیره ارزش هوش مصنوعی را مدیریت میکنند:
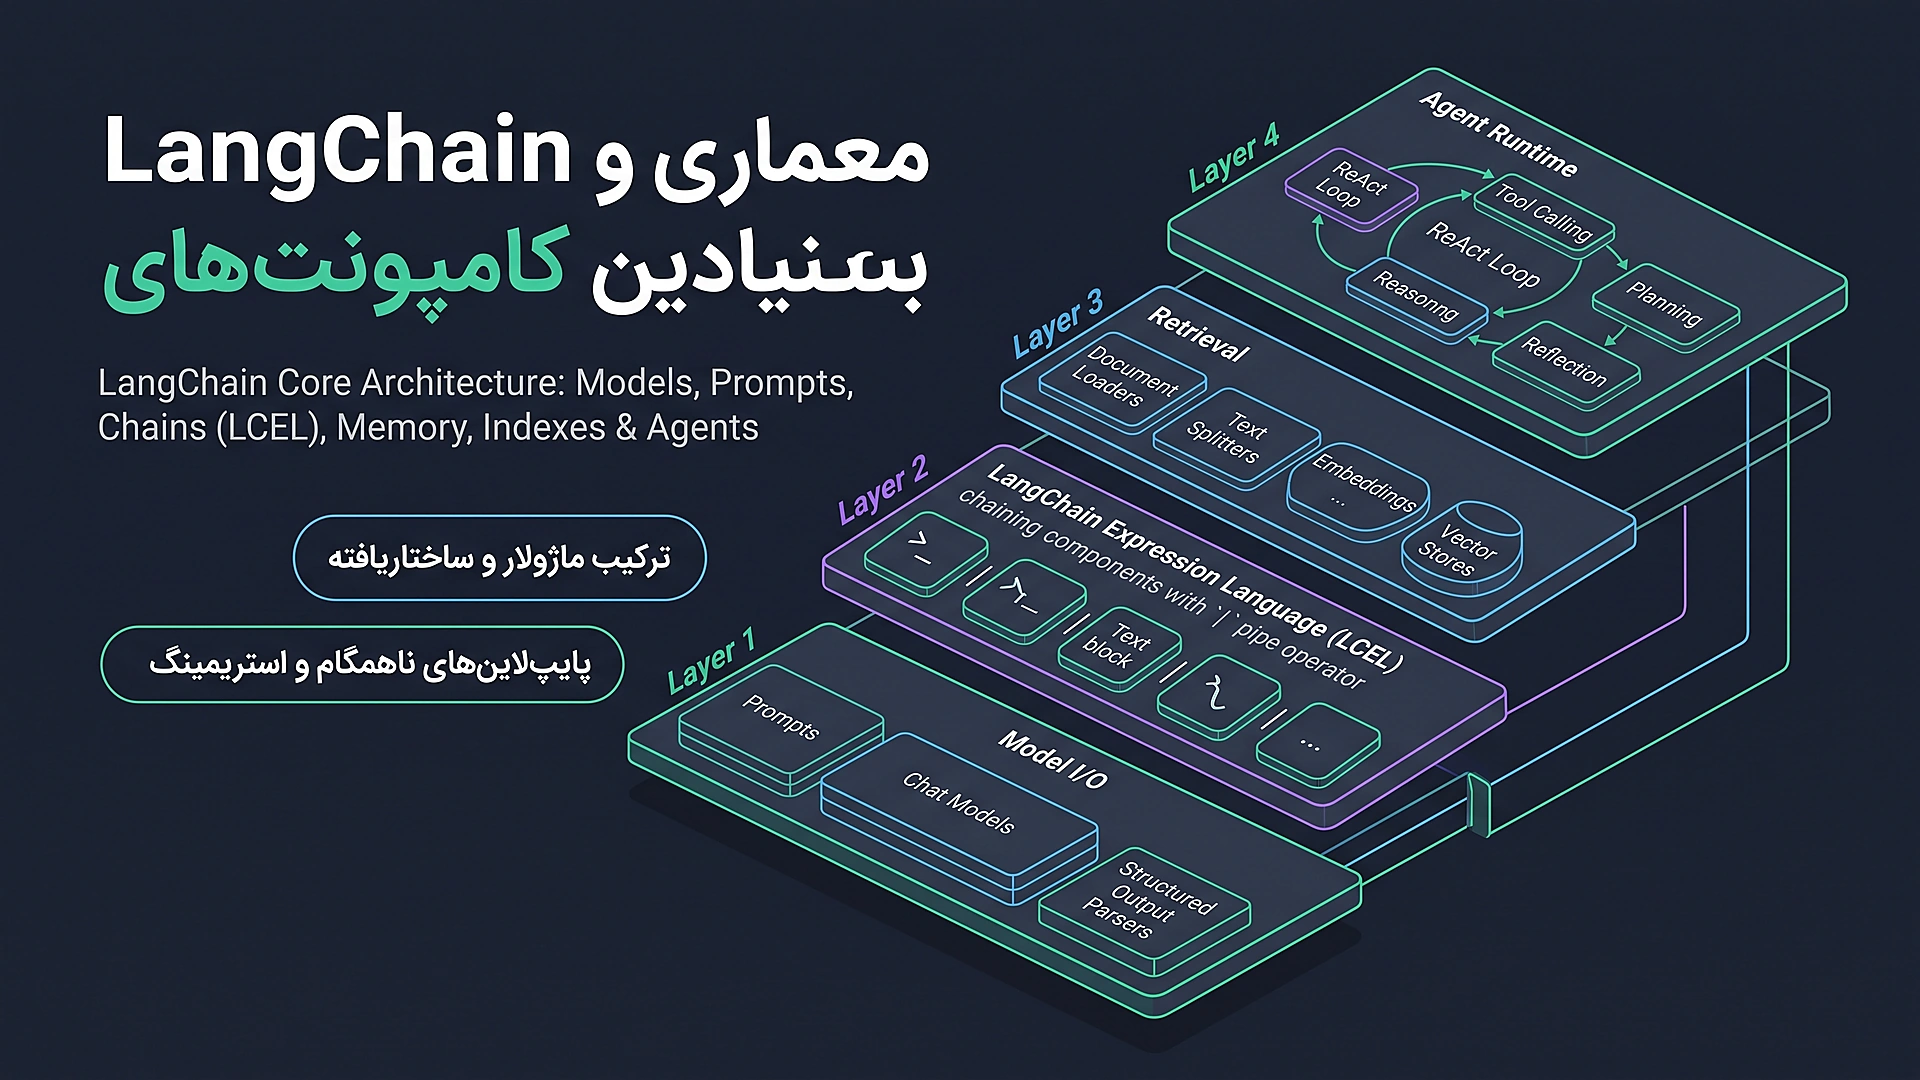
زبان بیانی لانگچین (LCEL - LangChain Expression Language)
در نسخههای مدرن لانگچین، تمام کامپوننتها پروتکل استانداردی به نام Runnable را پیادهسازی میکنند. این ویژگی به توسعهدهندگان اجازه میدهد اجزای مختلف (پرامپت، مدل، پارسر و ابزارها) را با استفاده از عملگر پایپ پایتون (|) به صورت فوقالعاده تمیز، ناهمگام (Async) و با پشتیبانی پیشفرض از استریمینگ (Streaming) ترکیب کنند:
from langchain_core.prompts import ChatPromptTemplate
from langchain_core.output_parsers import StrOutputParser
from langchain_openai import ChatOpenAI

# تعریف زنجیره پردازشی مدرن با سینتکس LCEL
prompt = ChatPromptTemplate.from_template("تحلیل فنی مختصری درباره مزیت معماری {topic} ارائه دهید:")
model = ChatOpenAI(model="gpt-4o", temperature=0.2)
output_parser = StrOutputParser()

# اتصال اجزا با عملگر پایپ |
analysis_chain = prompt | model | output_parser

# اجرای ناهمگام با استریمینگ زنده
for chunk in analysis_chain.stream({"topic": "Event-Driven Architecture"}):
    print(chunk, end="", flush=True)
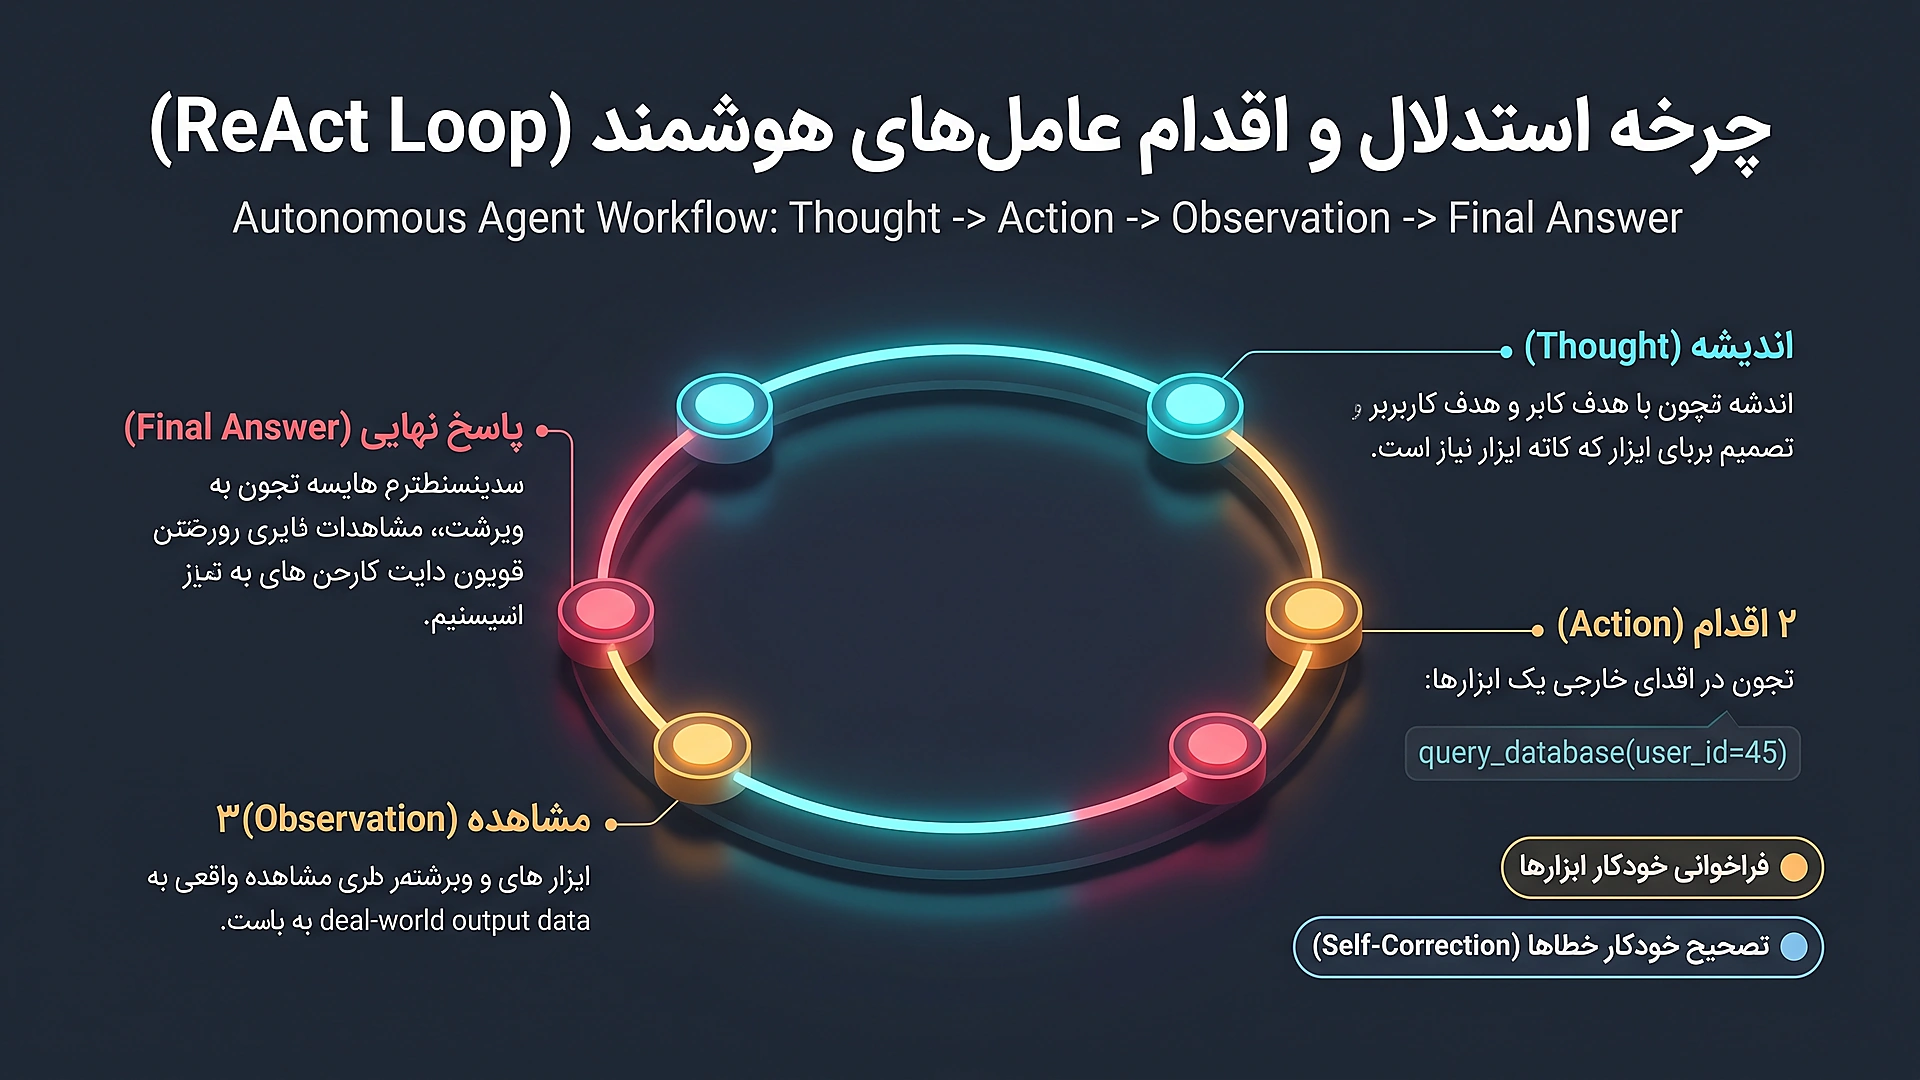
۲. ساخت عاملهای هوشمند خودمختار: چرخه استدلال و اقدام (ReAct Loop)
بزرگترین جهش هوش مصنوعی در سالهای اخیر، حرکت از چتباتهای ایستا به سمت عاملهای خودمختار (Autonomous AI Agents) است. یک عامل برخلاف یک زنجیره ثابت، خود تصمیم میگیرد که برای پاسخ به کاربر به چه ابزاری نیاز دارد، خروجی ابزار را بررسی میکند و در صورت عدم رسیدن به نتیجه، مسیر خود را اصلاح مینماید.
تعریف ابزار های سفارشی (Custom Tools) با Pydantic
برای آنکه مدل زبانی بتواند کارهای واقعی انجام دهد (مانند بررسی موجودی انبار یا کوئری زدن به دیتابیس)، ابزارها با اسکیمای دقیق تعریف میشوند:
from langchain_core.tools import tool
from pydantic import BaseModel, Field
class OrderQueryInput(BaseModel):
order_id: int = Field(description="شناسه عددی سفارش مشتری")
@tool("query_order_status", args_schema=OrderQueryInput)
def query_order_status(order_id: int) -> str:
"""بررسی وضعیت ارسال و صورتحساب یک سفارش مشخص در دیتابیس سازمانی."""
# شبیهسازی کوئری واقعی دیتابیس
orders_db = {101: "ارسال شده با پست پیشتاز", 102: "در حال پردازش در انبار"}
return orders_db.get(order_id, "سفارش با این شناسه یافت نشد.")
۳. استراتژیهای مدیریت حافظه در سیستم های گفتگومحور سازمانی
مدلهای زبانی ذهنیت بدون حالت (Stateless) دارند و با هر فراخوانی جدید، گفتگوهای قبلی را فراموش میکنند. از سوی دیگر، ارسال کل تاریخچه چت در پنجره زمینه (Context Window) تصاعدی هزینههای API را افزایش داده و سرعت استنتاج را کاهش میدهد:
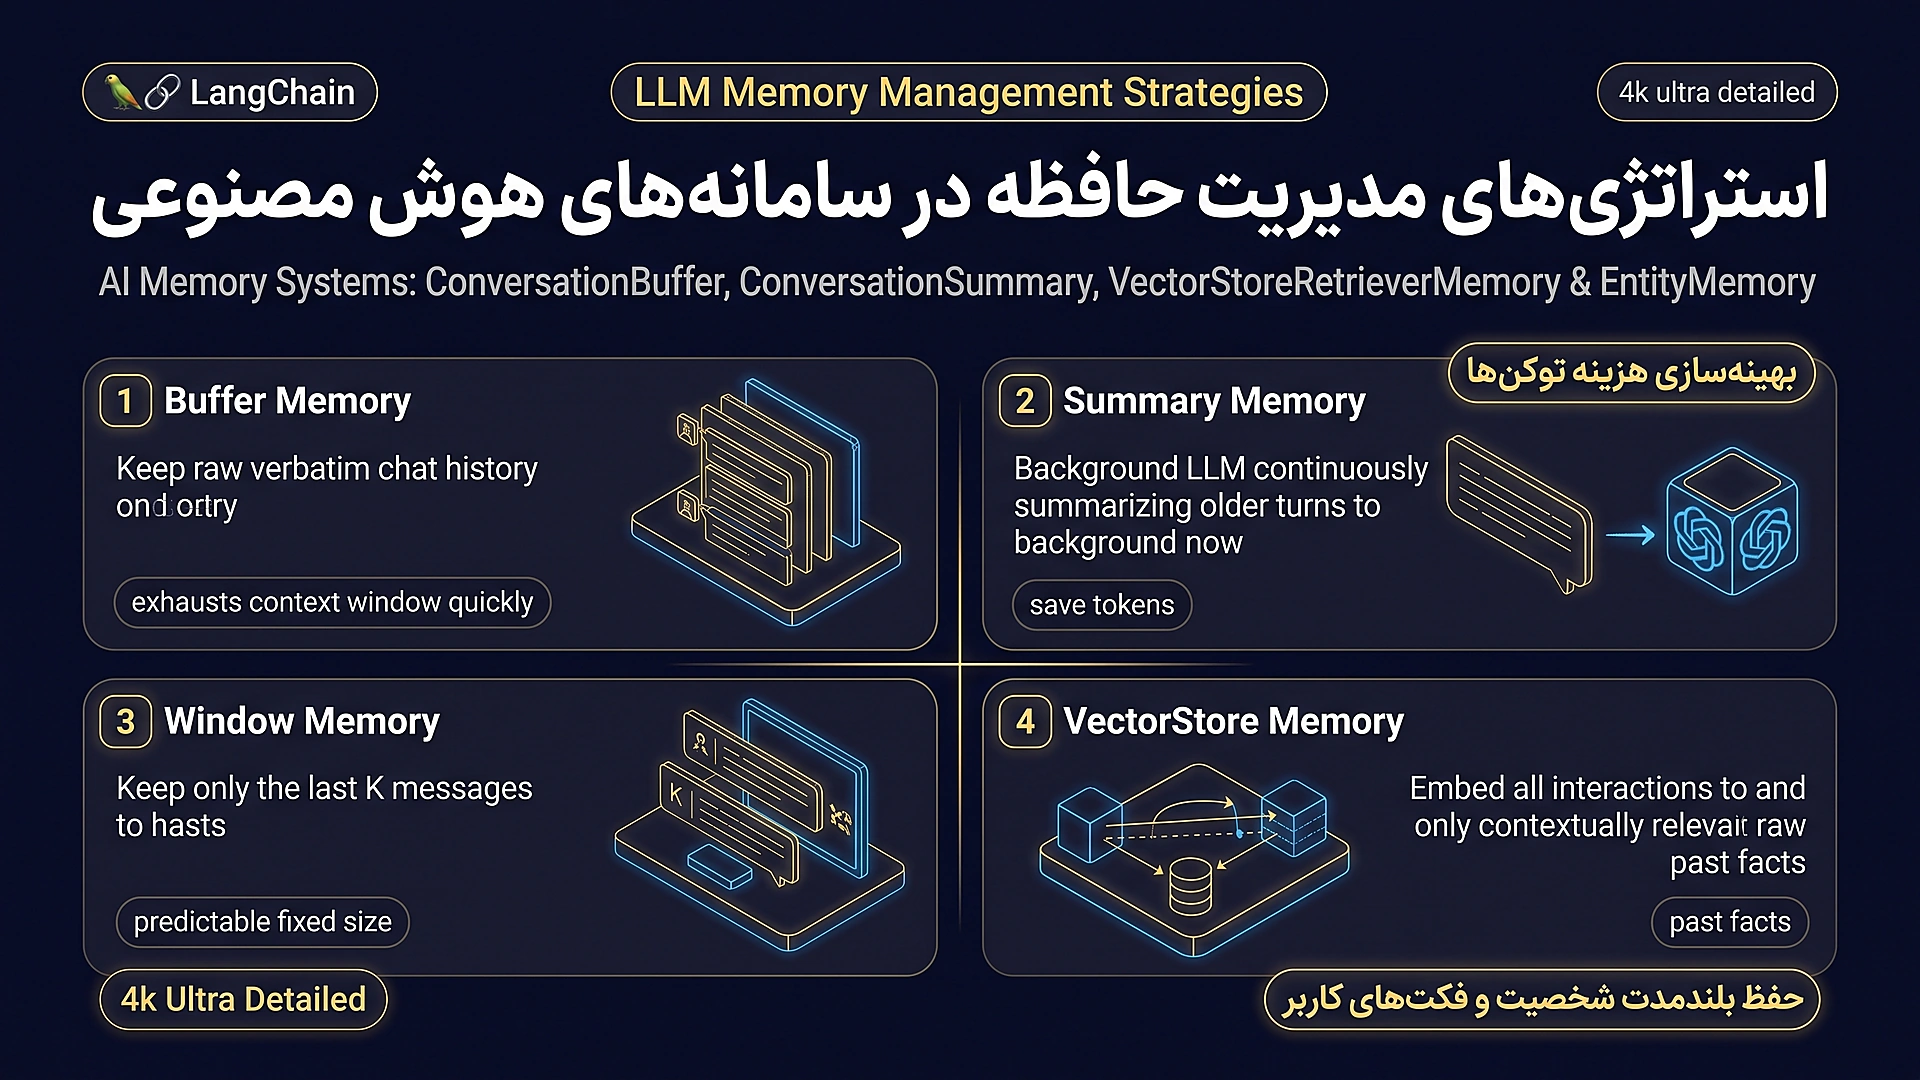
مقایسه مدل های حافظه
- ConversationBufferWindowMemory: تنها K پیام آخر (مثلاً ۱۰ پیام انتهایی) را ذخیره میکند؛ سریع و کمهزینه اما حافظه بلندمدت ندارد.
- ConversationSummaryMemory: یک مدل زبانی ارزان در پسزمینه گفتگوهای قدیمی را به طور مداوم خلاصه میکند و فکتهای کلیدی کاربر را در حجم توکن بسیار ناچیز نگه میدارد.
- VectorStoreRetrieverMemory: تمام دیالوگها و فکتهای گذشته به صورت بردارهای عددی در دیتابیس ذخیره میشوند و متناسب با موضوع پیام جاری کاربر، بخشهای مرتبط از گذشته بازخوانی میگردند.
۴. پایپ لاین پیشرفته RAG سازمانی: از اسناد تا بازیابی هیبرید
همانطور که در مقاله مرجع معماری و پیادهسازی RAG سازمانی بررسی کردیم، بازیابی ابتدایی بر مبنای تشابه کسینوسی (Naive RAG) در اسناد پیچیده حقوقی یا مالی پاسخگو نیست.
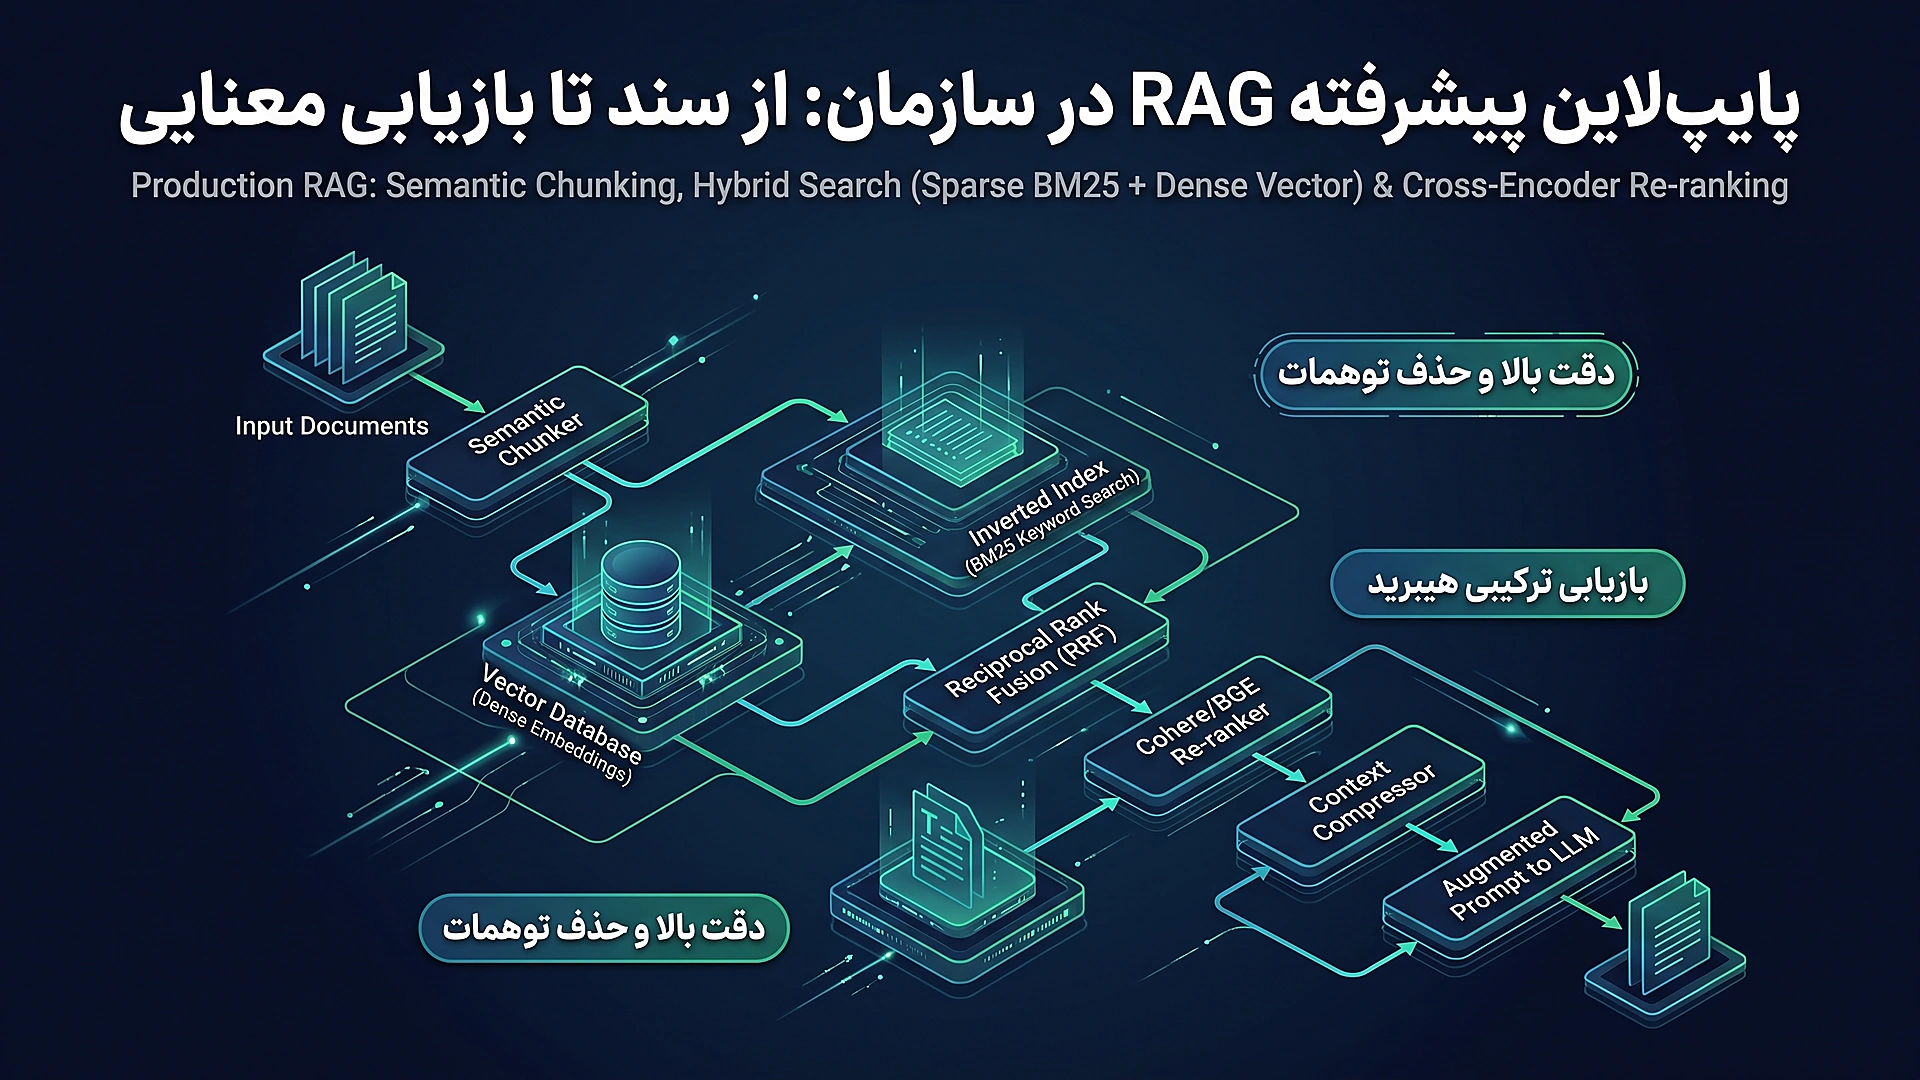
المانهای RAG در مقیاس صنعتی
- خردسازی معنایی (Semantic Chunking): شکستن اسناد بر پایه تغییرات معنایی پاراگرافها به جای خردسازی کورکورانه بر مبنای تعداد ثابت کاراکتر.
- جستجوی هیبرید (Hybrid Search): ادغام جستجوی دقیق کلیدواژهای با الگوریتم BM۲۵ در کنار جستجوی برداری عمیق HNSW با فرمول Reciprocal Rank Fusion (RRF).
- بازرتبهبندی (Re-ranking): عبور دادن ۵۰ سند برتر اولیه از یک مدل تخصصی Cross-Encoder برای امتیازدهی مجدد و انتخاب ۵ سند با بیشترین دقت موضوعی.
۵. رصدپذیری، دیباگ و ارزیابی با اکوسیستم LangSmith
بزرگترین کابوس مهندسان در دیپلوی اپلیکیشنهای هوش مصنوعی به پروداکشن، پدیده «جعبه سیاه» است. وقتی یک زنجیره پیچیده شکست میخورد یا پاسخی نامناسب تولید میکند، چگونه بفهمیم کدام گام یا کدام ابزار لغزیده است؟
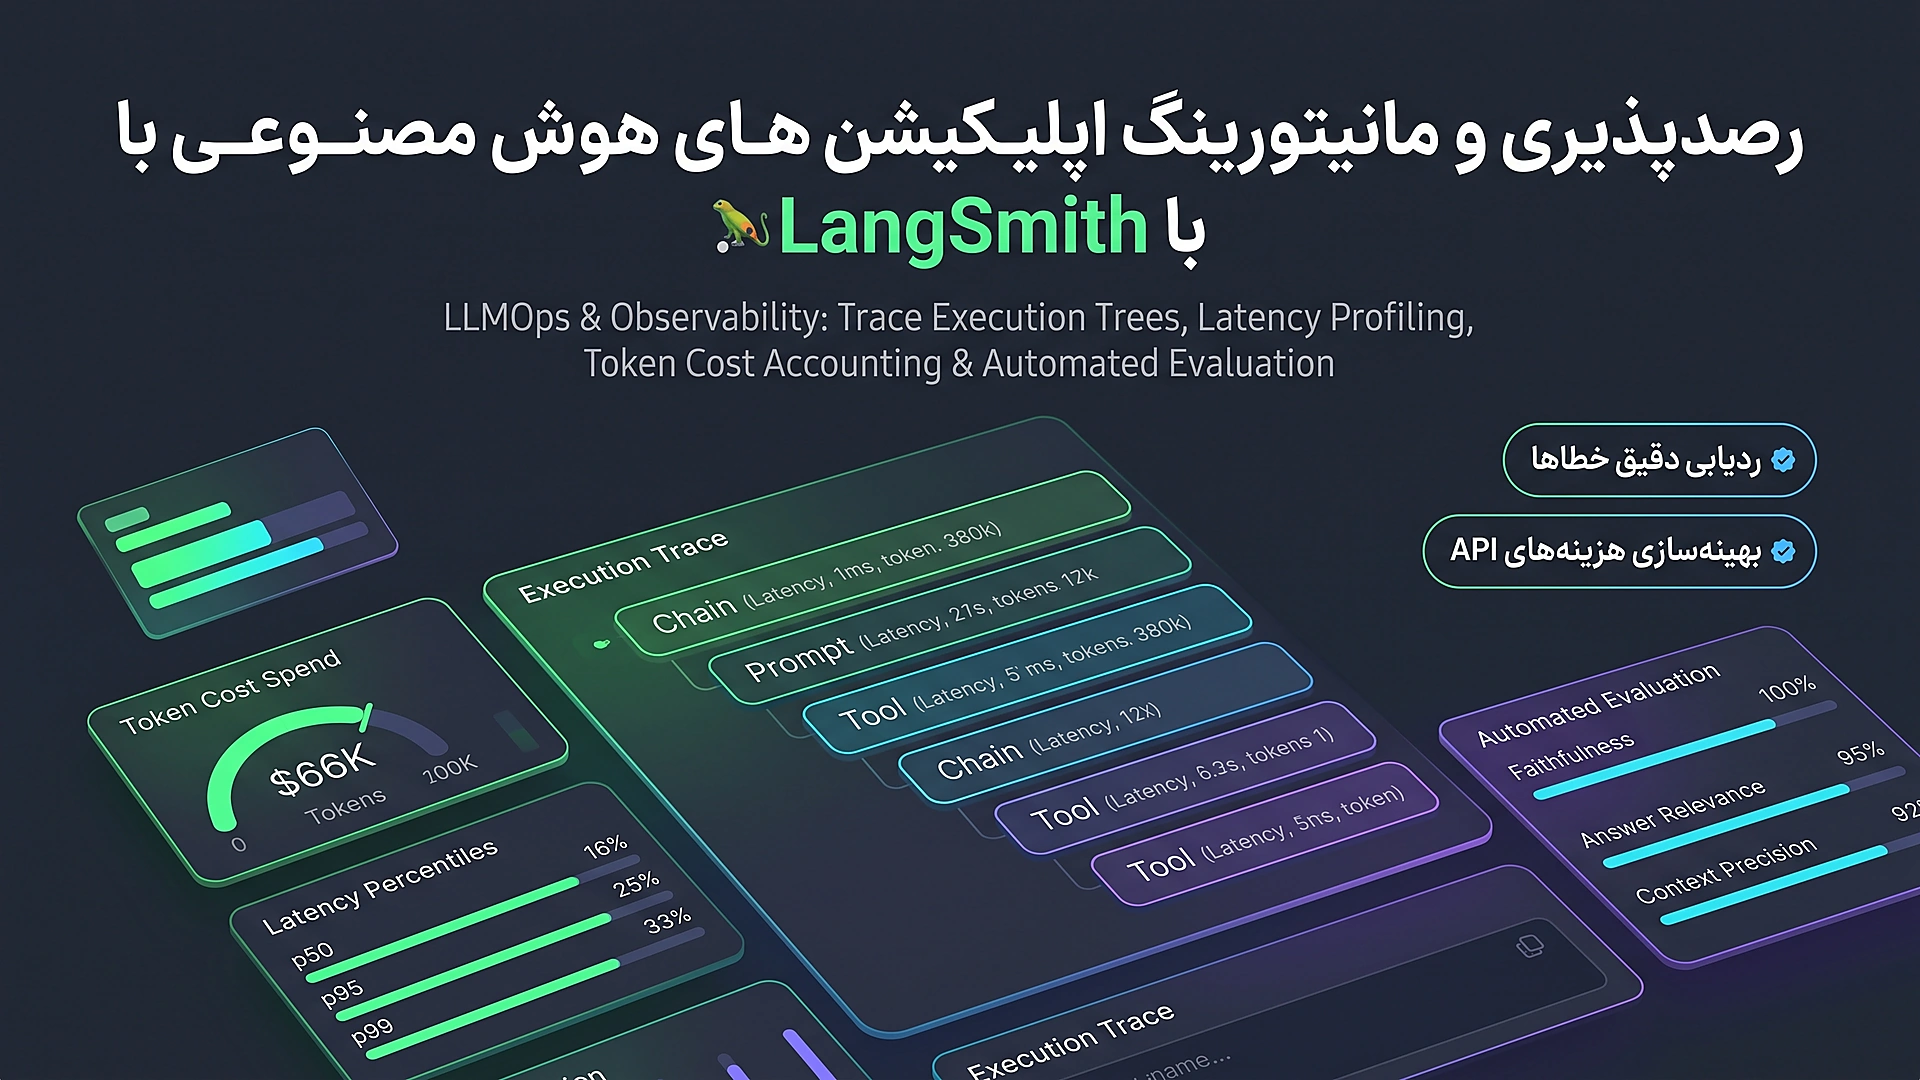
پلتفرم LangSmith با اتصال به کدهای لانگچین، تمامی مراحل را به صورت یک درخت گرافیکی از فراخوانیها (Trace Tree) با تفکیک دقیق زمان تاخیر، توکنهای ورودی/خروجی، پرامپت خام ارسالی به مدل و پاسخ ابزارها ثبت میکند. این ابزار به معماران اجازه میدهد تاخیرهای p۹۹ را کشف کرده و سنجههای کیفیت (Faithfulness و Context Precision) را مداوماً اندازهگیری کنند.
نتیجهگیری و جمعبندی
فریمورک LangChain زیرساخت مدرن مهندسی نرمافزار در عصر هوش مصنوعی است. با درک اصول ماژولار زنجیرههای LCEL، استقرار عاملهای خودمختار با فراخوانی امن ابزارها و اتکا به پلتفرمهای مانیتورینگ و ارزیابی نظیر LangSmith، تیمهای مهندسی میتوانند محصولات هوشمندی خلق کنند که نه تنها شگفتانگیز و تعاملی هستند، بلکه از نظر ضریب اطمینان، سرعت و هزینههای عملیاتی به استانداردهای سختگیرانه پروداکشن سازمانی پاسخ میدهند.
امتیاز و نظرات
هنوز نظری ثبت نشده است. اولین نفر باشید.