
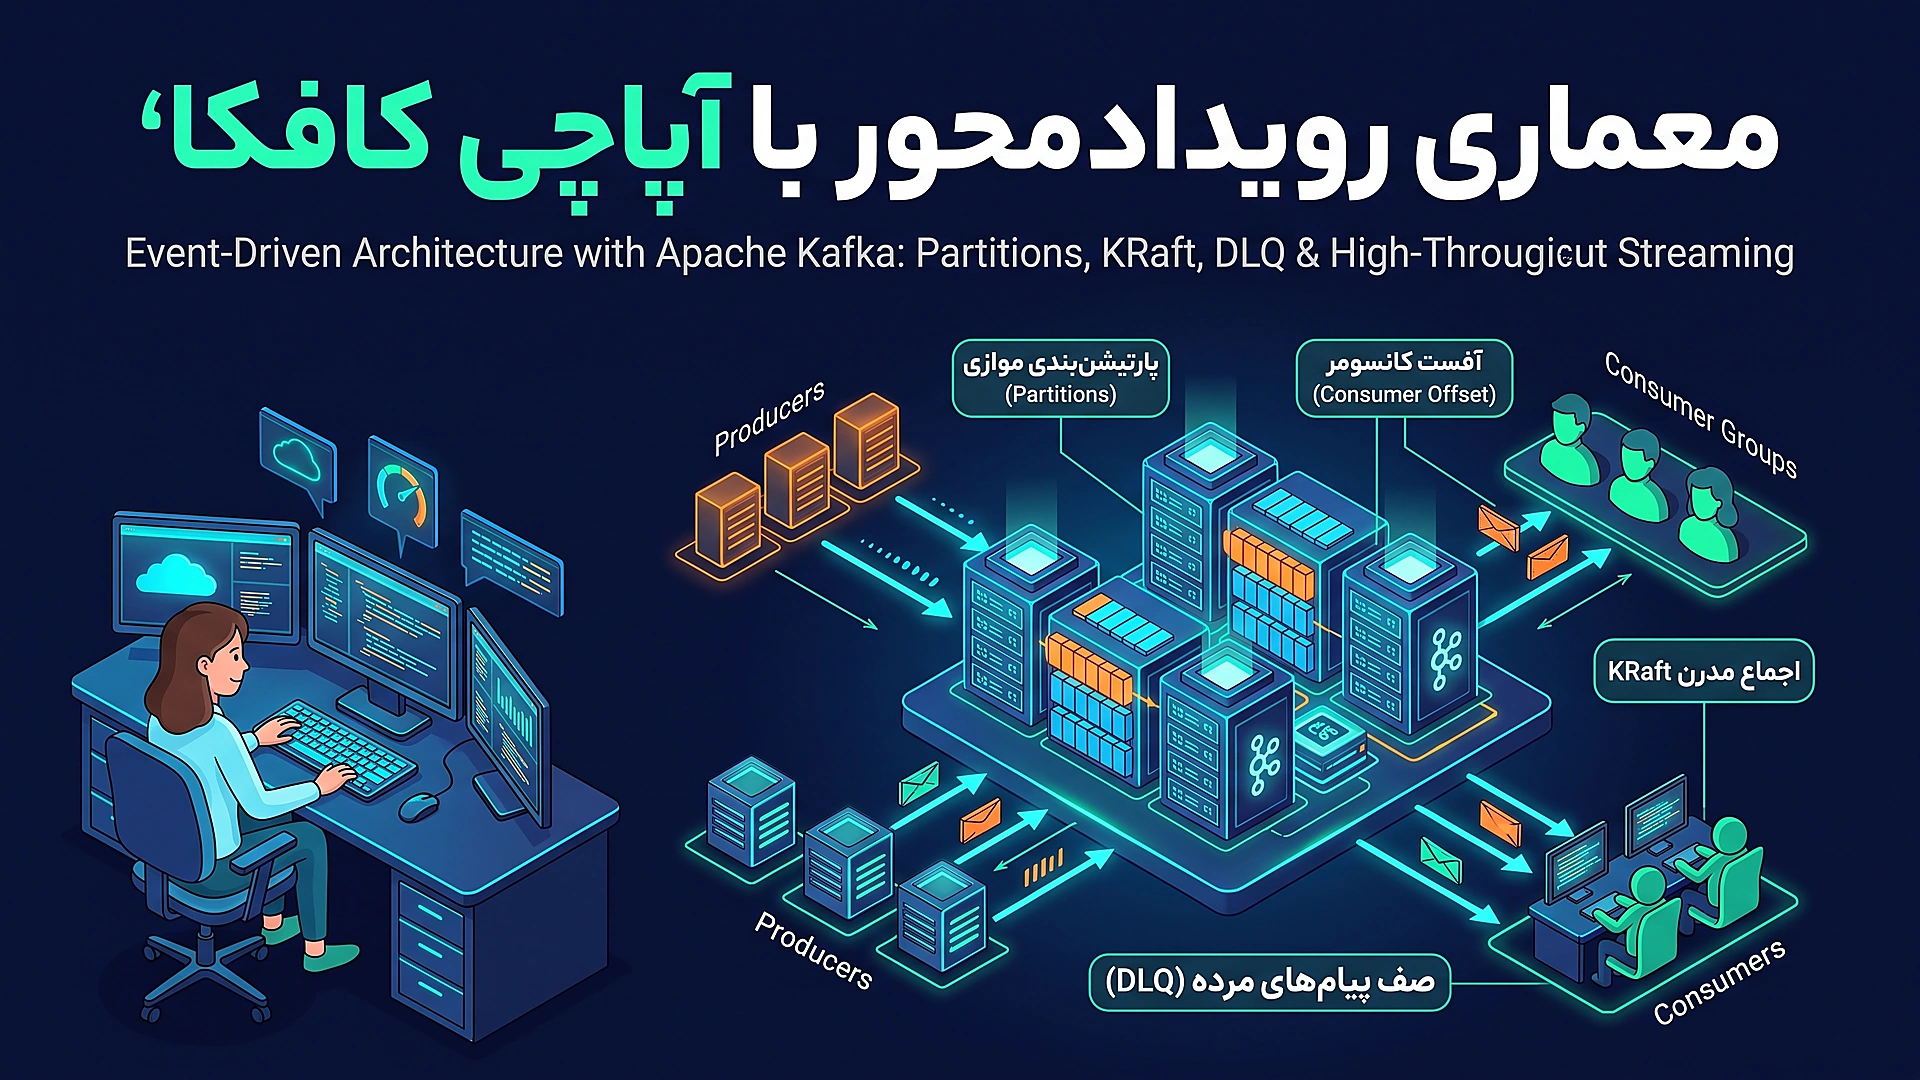
در قلمرو توسعه نرم افزارهای سازمانی مدرن و مهندسی سیستم های توزیع شده با مقیاس میلیونی، معماری های متداول مبتنی بر فراخوانی همگام نظیر REST API و پروتکل های سنتی gRPC که بر چرخه ساده درخواست-پاسخ (Request-Response) متکی هستند، با بحران های ساختاری جبرانناپذیری مواجه شدهاند. هنگامی که نرخ پردازش یک پلتفرم از صدها درخواست به ده ها هزار یا صدها هزار رویداد همزمان در هر ثانیه جهش پیدا میکند، وابستگی زمانی سرویس های، تقویت نمایی تاخیر دم (Tail Latency Amplification) و پدیده ویرانگر از کارافتادگی آبشاری (Cascading Failures)، پایداری سرویس را متلاشی میسازد. معماری رویداد محور (Event-Driven Architecture یا EDA) با بازتعریف فلسفه ارتباطی میان میکرو سرویس های و معرفی رویداد به عنوان یک حقیقت ثبتشده و تغییرناپذیر از رخدادهای پیشین، زیربنای مهندسی مقیاس پذیر جهان امروز را شکل داده است. در قلب تپنده این اکوسیستم نوین، آپاچی کافکا (Apache Kafka) نه فقط یک صف پیام، بلکه یک پایگاه داده دفترکل لاگ توزیع شده با کارایی شگفتانگیز است. در این مگامقاله تخصصی، کالبدشکافی عمیق کافکا، مکانیزم های عملکردی هسته لینوکس، مهاجرت ساختاری از ZooKeeper به KRaft، الگو های تراکنشی Outbox، تابآوری خطا با صف های مرده (DLQ) و دستورالعمل های پروداکشن را گامبهگام بررسی خواهیم کرد.
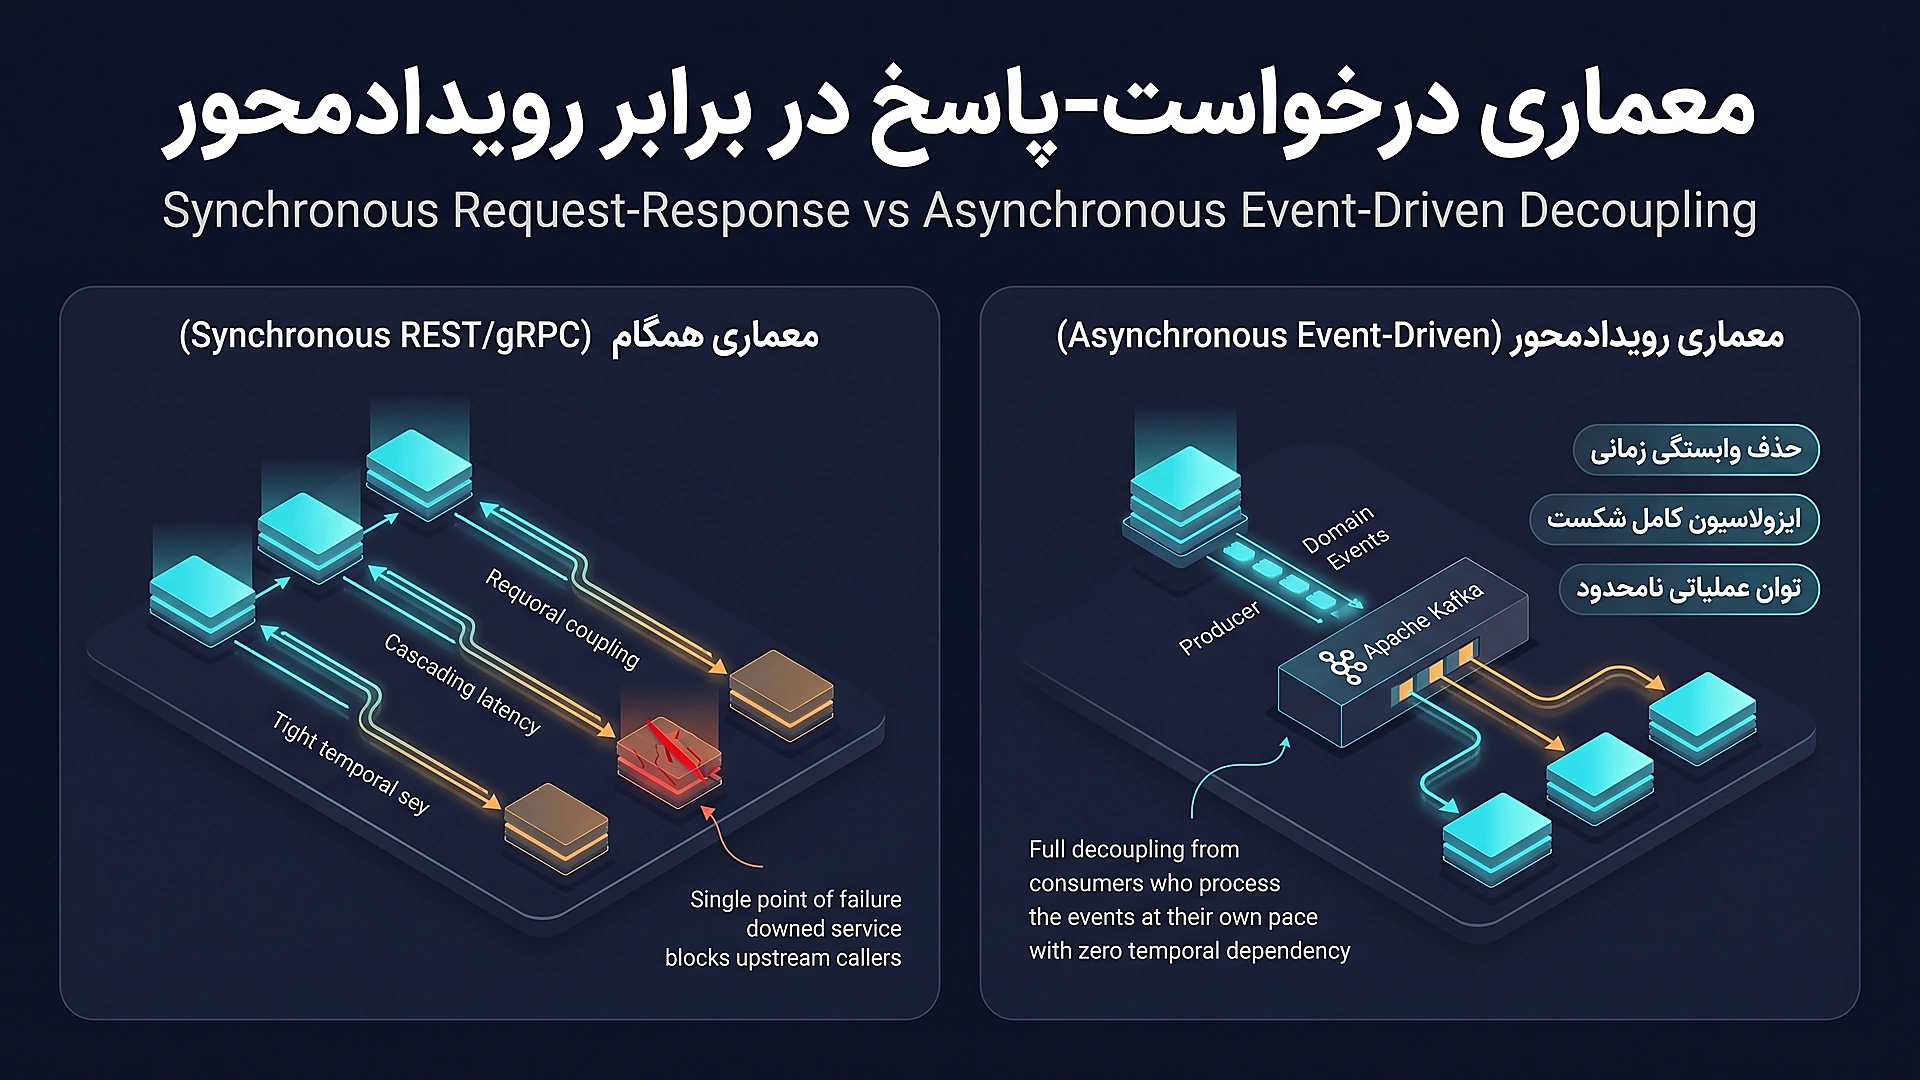
۱. مانیفست معماری رویداد محور در برابر پارادایم همگام درخواست-پاسخ
برای فهم چرایی سلطه آپاچی کافکا در شرکت های غولآسای دنیای فناوری همچون لینکدین، نتفلیکس، اوبر و پیپال، نخست باید محدودیت های ذاتی معماری های همگام سنتی را تحلیل کنیم. در یک سیستم میکرو سرویسی سنتی، هنگامی که کاربری فرآیند خرید اینترنتی را به سرانجام میرساند، سرویس سفارشات (Order Service) برای قطعی کردن فرآیند ناچار است یک زنجیره تودرتوی همگام را اجرا کند:
- فراخوانی سرویس پرداخت (Payment Service) برای برداشت وجه از حساب کاربر.
- فراخوانی همگام سرویس انبارداری (Inventory Service) جهت قفل کردن موجودی فیزیکی انبار.
- ارسال درخواست به سرویس لجستیک و حملونقل برای تخصیص پیک.
- درخواست صدور صورتحساب مالیاتی و ارسال پیامک به کاربر از طریق درگاه های مخابراتی.
این ساختار زنجیرهای که در اصطلاح مهندسی کوپلینگ شدید زمانی و مکانی (Temporal and Spatial Coupling) نامیده میشود، سیستم را در معرض خطرات عظیمی قرار میدهد:
- انباشت تاخیر صدک نود و نهم (p۹۹ Tail Latency): هر گره جدید در این زنجیره، زمان پاسخگویی نهایی را افزایش میدهد. اگر پنج سرویس به صورت متوالی فراخوانی شوند که هر یک در صدک ۹۹ خود ۲۰۰ میلیثانیه تاخیر دارند، تجربه کاربر نهایی با تاخیری بیش از ۱ ثانیه مواجه خواهد شد.
- انسداد منابع و نخ های پردازشی (Thread Starvation): وبسرور های تعداد محدودی کانکشن و نخ اجرایی برای مدیریت ریکوئست ها در اختیار دارند. اگر سرویس انبارداری به دلیل قفل شدن ردیف های پایگاه داده چند ثانیه کند شود، تمام نخ های سرویس سفارشات اشباع شده و پذیرش درخواست های جدید ناممکن میگردد.
- سرایت قطعی سرویس (Cascading Collapse): از کار افتادن سرویس صدور پیامک یا سامانه حسابداری نباید تجربه خرید کاربر را مختل سازد؛ اما در مدل همگام بدون ایزولاسیون دقیق، قطعی یک ماژول کماهمیت به کل کسبوکار سرایت میکند.
در مقابل، در معماری رویداد محور، سرویس سفارشات پس از اعتبارسنجی اولیه، تنها یک رویداد قطعی به نام OrderPlaced را در کارگزار پیام منتشر کرده و بلافاصله وضعیت را به کاربر اعلام مینماید. سرویس هایی انبارداری، حسابداری، لجستیک و پیامرسانی به صورت مستقل و ناهمگام این رویداد را مصرف میکنند. در این ساختار، تولیدکننده رویداد کوچکترین اطلاعی از مصرفکنندگان ندارد و در صورتی که یکی از سرویس های خاموش یا در حال بهروزرسانی باشد، رویدادها در صف کافکا انباشته شده و پس از بازگشت سرویس، بدون مفقودی پردازش میشوند. این تفکیک وابستگی و تفویض وظایف، دقیقا مصداق عملیاتی پیاده سازی اصول معماری تمیز در پروژه های مقیاس پذیر است که بر اساس آن مرزهای دامنه و جزئیات تبادل پیام در لایه های بیرونی معماری ایزوله میگردند.
۲. کالبدشکافی آپاچی کافکا: دفترکل لاگ توزیع شده در برابر صف های سنتی
بسیاری از برنامه نویسان در نخستین گام، کافکا را با کارگزارهای صف سنتی (Message Brokers) نظیر RabbitMQ یا ActiveMQ مقایسه میکنند. این مقایسه از پایه اشتباه است! سیستم های سنتی بر مبنای استاندارد AMQP فعالیت میکنند؛ در این سامانه ها، صف ها موجودیت های موقتی هستند که پیام ها پس از واکشی و دریافت تاییدیه (ACK) توسط مصرفکننده، بلافاصله از حافظه یا دیسک پاک میشوند (Destructive Reading). اما کافکا یک دفترکل ترتیبی تغییرناپذیر فقط-افزودنی (Distributed Append-Only Commit Log) است.
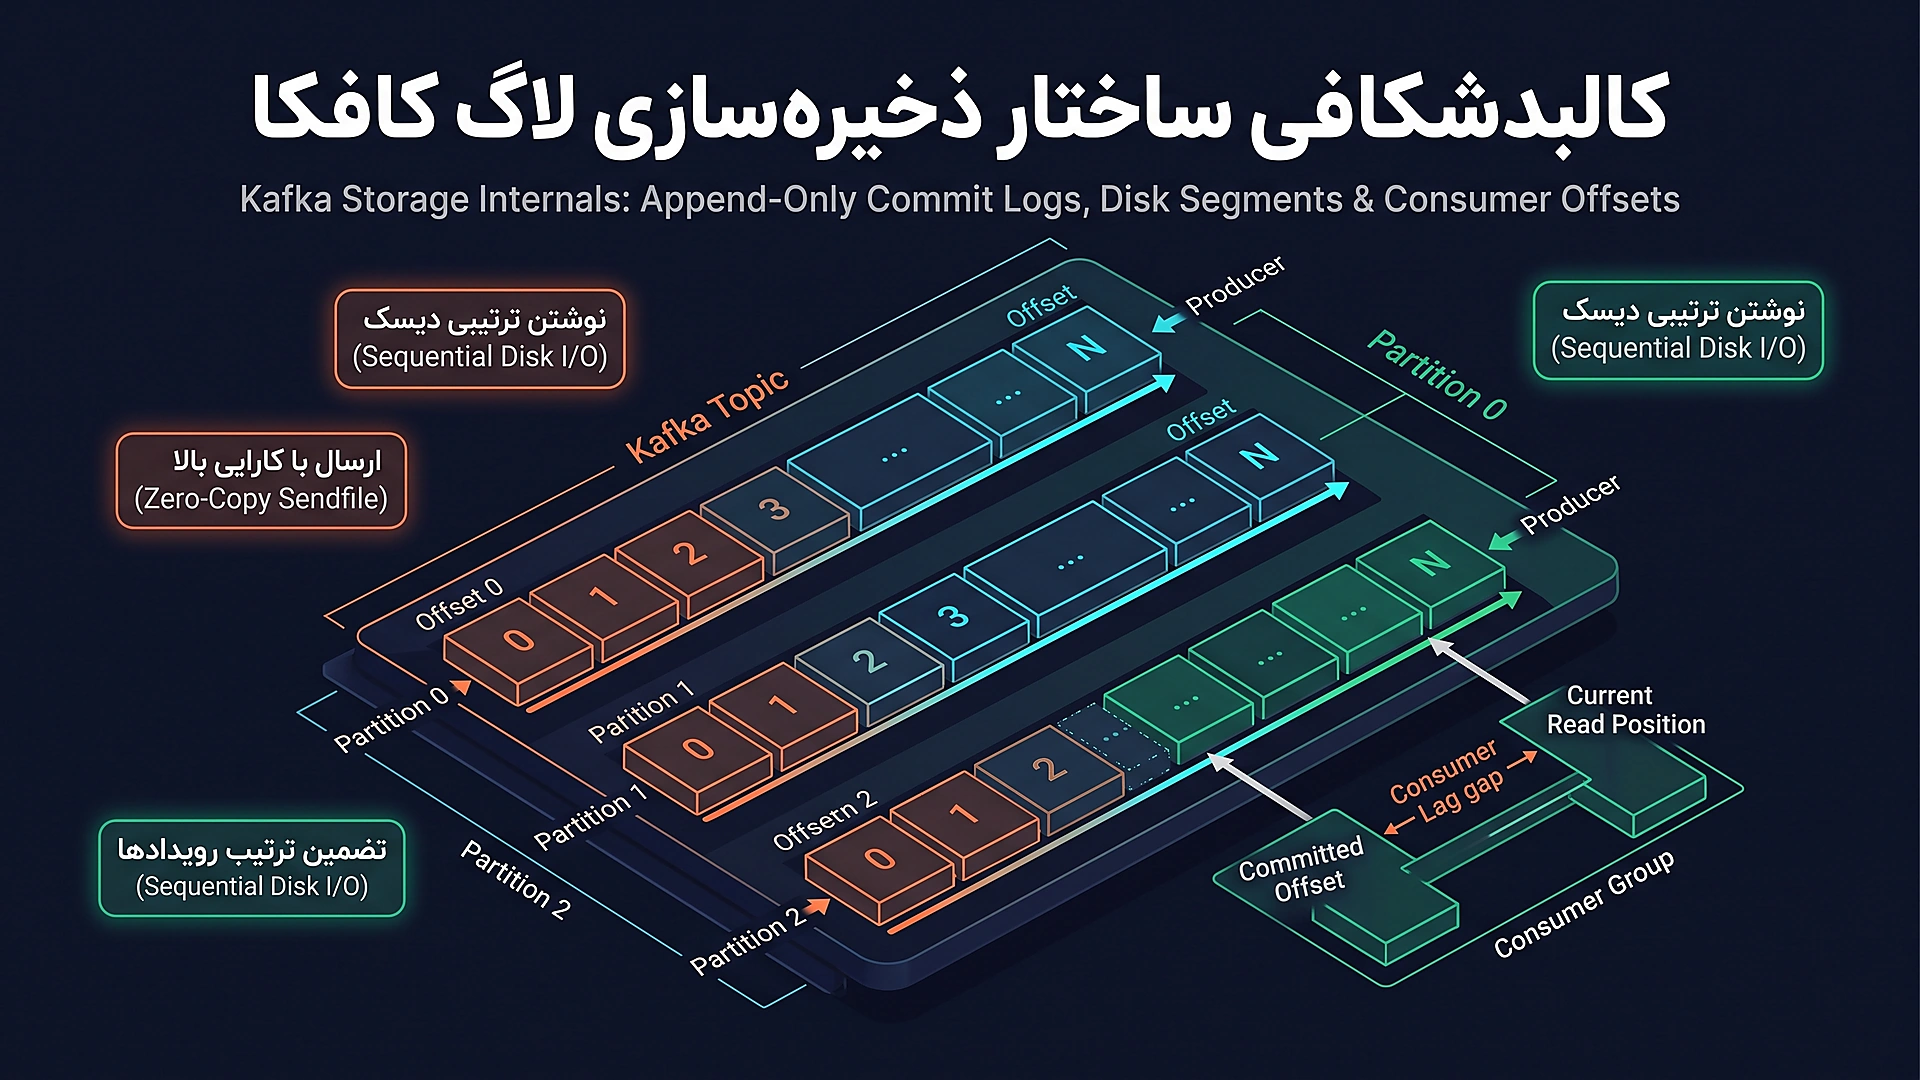
در کافکا، رویدادها پس از خوانده شدن توسط مصرفکنندگان پاک نمیشوند! رویدادها بر اساس سیاست نگه داری (Retention Policy) که میتواند روزها، ماه ها یا حتی سال ها باشد، روی دیسک پایدار باقی میمانند. این تفاوت فلسفی، چندین قابلیت بیبدیل خلق میکند:
- امکان پخش مجدد تاریخچه (Event Replayability): اگر یک باگ منطقی در سرویس محاسبات مالیاتی کشف شود، تیم مهندسی میتواند پس از اصلاح کد، اشارهگر آفست مصرفکننده را به سه روز قبل بازگرداند و تمامی رویدادها را مجدداً با کد جدید پردازش کند؛ امری که در صف های سنتی رویایی دستنیافتنی است.
- مصرفکنندگان چندگانه با سرعت های متفاوت: یک سرویس میتواند رویدادها را در کسری از میلیثانیه به صورت بلادرنگ بخواند، در حالی که یک خط لوله یادگیری ماشین یا پردازش دستهای (Batch) همان رویدادها را با تاخیر یک ساعته برای تحلیل کلان داده واکشی کند، بدون آنکه تداخلی میان آن ها ایجاد شود.
راز عملکرد فرابشری کافکا: بهرهگیری از Zero-Copy و کش صفحه لینوکس
شاید بپرسید چگونه سیستمی که داده ها را بر روی دیسک فیزیکی ذخیره میکند، میتواند عملکردی سریعتر از سیستم های پیامرسان متکی بر حافظه رم (In-Memory) ارائه دهد؟ راز در دو معماری درخشان سیستم های عامل لینوکس نهفته است:
۱. کش صفحه لینوکس (OS PageCache): کافکا با زبان های اسکالا و جاوا نوشته شده است، اما رویدادها را در حافظه رم JVM (هیپ) انباشته نمیکند تا دچار وقفه های طولانی Garbage Collection نشود. در عوض، سیستمعامل لینوکس تمامی بایت های خواندهشده و نوشتهشده روی دیسک را به صورت خودکار در PageCache کش میکند. در عمل، پیام های تازه تولیدشده همواره مستقیماً از حافظه رم سیستمعامل به مصرفکنندگان تحویل داده میشوند.
۲. مکانیزم Zero-Copy و فراخوانی سیستمیsendfile: در حالت عادی، بایت های پیام از دیسک خوانده شده، به فضای هسته (Kernel Space)، سپس به فضای کاربری پردازش جاوا (User Space)، مجدداً به بافر سوکت در فضای هسته و در نهایت به کارت شبکه (NIC) منتقل میشوند که شامل ۴ مرحله کپی پرهزینه و تعویض بافت (Context Switch) است. کافکا با بهرهگیری از سیستمکالsendfileاین مسیر را حذف کرده و داده را به طور مستقیم از بافر کش صفحه به کارت شبکه تزریق میکند؛ این یعنی نرخ انتقال داده توسط سرعت فیزیکی کارت شبکه کلاستر محدود میشود، نه CPU!
۳. استراتژی های پارتیشن بندی، تضمین ترتیب و تحلیل پیچیدگی محاسباتی
پارتیشن (Partition) رگ حیات و واحد بنیادین توازی و مقیاس پذیری در کافکا است. هر تاپیک میتواند به چندین پارتیشن تقسیم شود که هر کدام بر روی بروکرهای متفاوتی در کلاستر توزیع شدهاند. برای مثال، تاپیکی با ۱۲ پارتیشن میتواند روی ۳ سرور مجزا مستقر شده و همزمان توسط ۱۲ پردازش موازی خوانده شود. اما این مقیاس پذیری خیرهکننده با یک اصل مهندسی حیاتی محدود شده است: ترتیب پیام ها در کافکا صرفاً در محدوده یک پارتیشن تضمین میشود و هیچ ترتیبی میان پارتیشن های مختلف وجود ندارد.
هنگامی که یک پرودوسر پیامی را ثبت میکند، اگر کلید پیام (Message Key) خالی باشد، کافکا پیام را به صورت راند-رابین یا استراتژی چسبنده (Sticky Partitioner) میان پارتیشن ها توزیع میکند تا تعادل بار کامل حفظ شود. اما اگر حفظ ترتیب رخدادها ضروری باشد، باید یک کلید هششونده نظیر order_id تعیین شود. کافکا با استفاده از الگوریتم هشینگ MurmurHash2، شماره پارتیشن مقصد را محاسبه میکند:
TargetPartition = abs(MurmurHash۲(Key)) % TotalPartitions
با این مکانیزم ریاضی، تمامی رویدادهای متعلق به یک موجودیت مشخص (مثلاً تمام تغییرات وضعیت سفارش شماره ۱۰۰۴۲) منحصراً به یک پارتیشن خاص سرازیر میشوند و کانسومر مربوطه آن ها را دقیقاً با همان ترتیبی که در واقعیت رخ دادهاند، دریافت و پردازش خواهد کرد.
از منظر علم داده و الگوریتم، هزینه افزودن پیام جدید به انتهای فایل پارتیشن دیسک به صورت پیوسته و متوالی انجام میشود که هزینه زمانی ثابت \(O(۱)\) را به ارمغان میآورد. همچنین پیدا کردن موقعیت یک پیام بر مبنای شماره آفست از طریق جداول نمایه سبک (Sparse Index Files) و با استفاده از جستجوی دودویی بر روی داده های مرتب، در زمان لگاریتمی \(O(\log N)\) انجام شده و به بازیابی مستقیم در حافظه میانجامد؛ مفاهیمی که تحلیل عمیق آن ها را پیشتر در تحلیل پیچیدگی الگوریتم ها و نماد Big-O موشکافی کردهایم.
۴. تحول تاریخی کلاستر: بازنشستگی ZooKeeper و طلوع اجماع KRaft
برای بیش از یک دهه، کافکا برای نگه داری فراداده های کلاستر، انتخاب بروکر کنترلر (Controller Election)، ردیابی وضعیت پارتیشن ها و اعمال مجوزهای امنیتی به سامانه خارجی آپاچی زوکیپر (Apache ZooKeeper) وابسته بود. این معماری دو لایه، پاشنه آشیل کافکا در سیستم های بزرگ سازمانی به شمار میرفت:
- تنگنای مقیاس پذیری پارتیشن ها: اگر تعداد پارتیشن های یک کلاستر از ۲۰۰ هزار عدد فراتر میرفت، زوکیپر زیر بار ذخیره و واچرهای هماهنگ سازی رم دچار خفگی میشد.
- زمان طولانی ریکاوری پس از کرش (Failover Lag): با از کار افتادن نود کنترلر، کنترلر جدید باید کل وضعیت متادیتا را مجدداً از زوکیپر بازیابی میکرد که در کلاستر های غولپیکر چندین دقیقه زمان میبرد و موجب قطع دسترسی پرودوسرها میشد.
- پیچیدگی دوگانه نگه داری در لایه زیرساخت: تیم های دواپس ناچار بودند کلاستر زوکیپر را جداگانه مانیتور، پشتیبانگیری و امن سازی کنند.
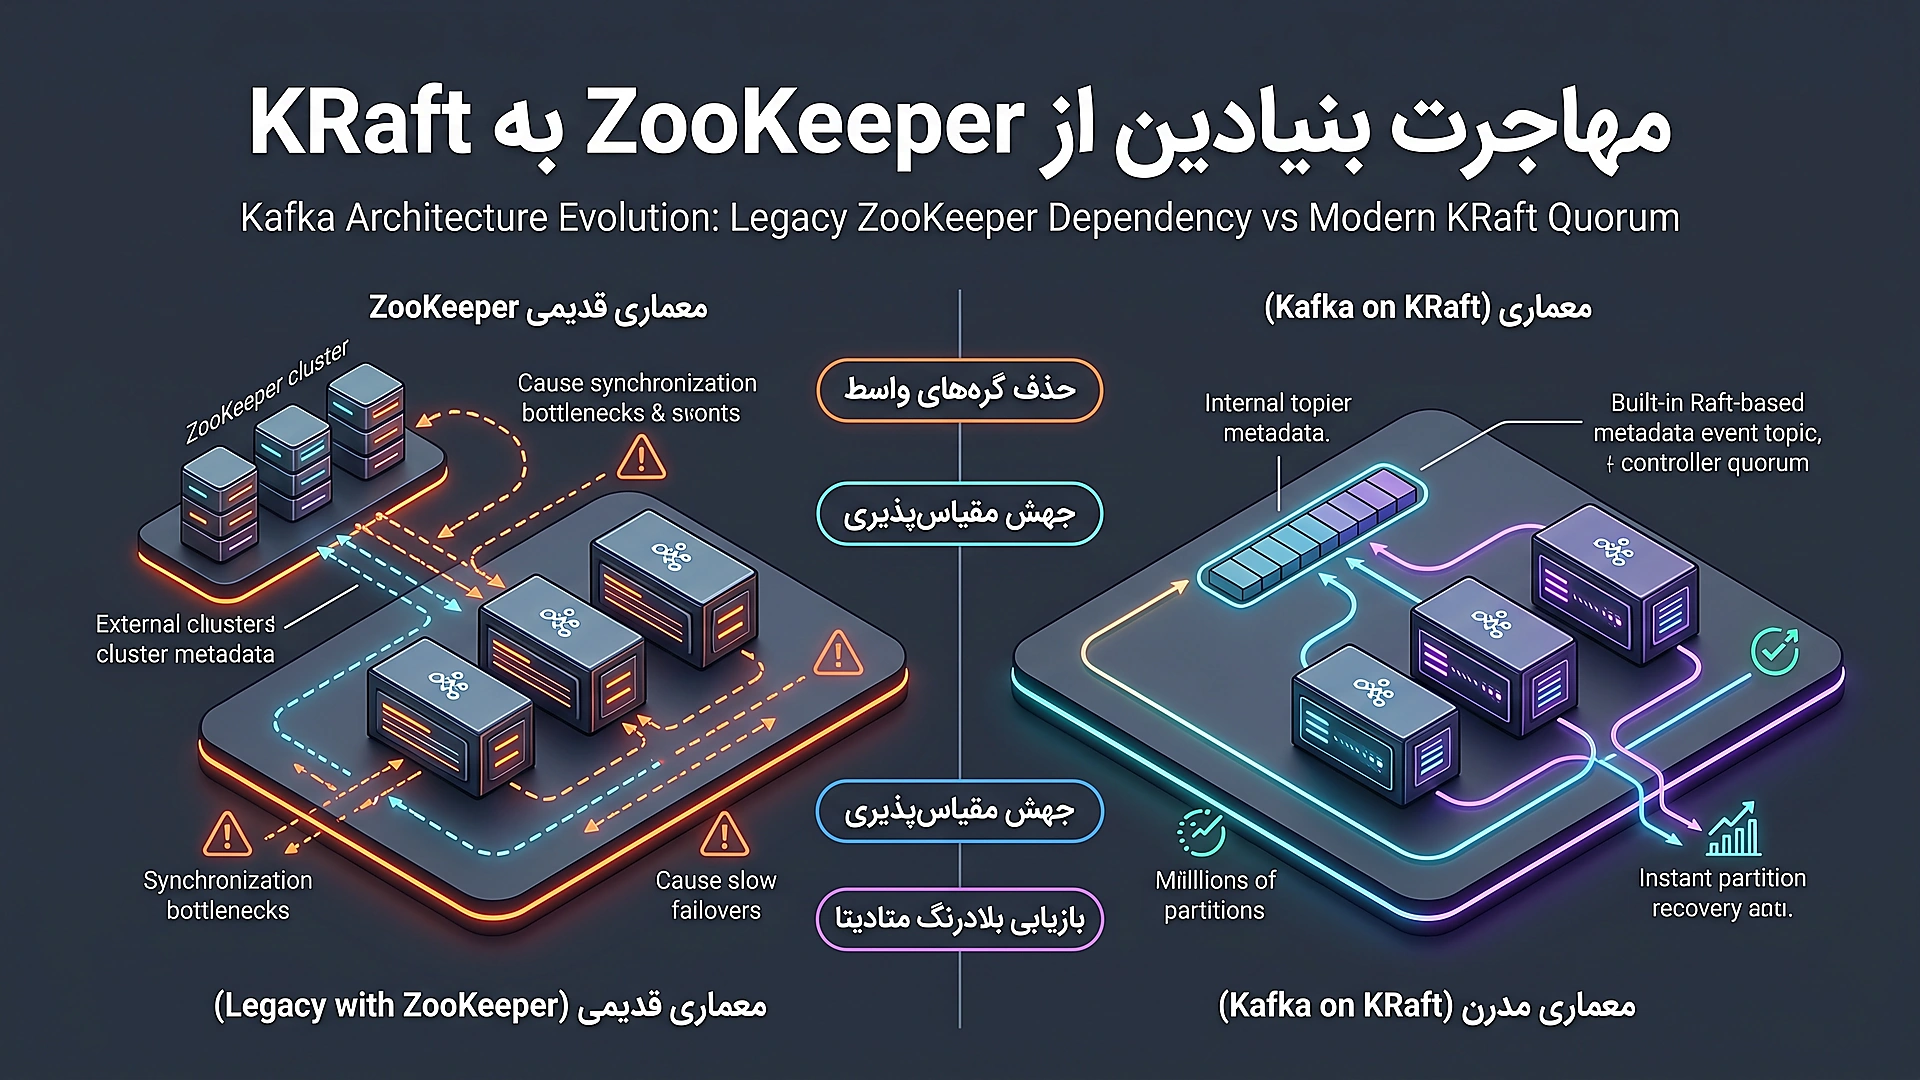
با معرفی پروتکل اجماع KRaft (Kafka Raft Metadata Mode) در KIP-۵۰۰، وابستگی به زوکیپر به صورت دائمی از کافکا حذف شد. در معماری نوین KRaft، نودهای خود کافکا نقش اعضای هیئت اجماع Raft را ایفا میکنند. فراداده های کلاستر دیگر در یک دیتابیس جداگانه ثبت نمیشوند، بلکه در قالب یک تاپیک تکپارتیشن داخلی ویژه به نام @metadata ذخیره شده و میان کنترلرها رپلیکیت میگردند. این رویداد انقلابی زمان بازیابی رهبر کلاستر را از چند دقیقه به زیر ۱۰۰ میلیثانیه رساند و ظرفیت مدیریت کلاستر را تا مرز میلیون ها پارتیشن گسترش داد.
۵. استقرار عملیاتی کلاستر ۳ گرهی با Docker Compose و KRaft
برای شبیه سازی یک کلاستر آماده پروداکشن در محیط محلی یا بر روی سرور هایی ابری، استفاده از کانتینرسازی استانداردترین رویکرد مهندسی است. در ادامه، بر پایه متدولوژی های مدون در راهنمای جامع داکر از صفر تا پروداکشن، فایل docker-compose.yml کامل برای راهاندازی کلاستر ۳ بروکره کافکا در حالت KRaft (بدون نیاز به زوکیپر) به همراه داشبورد مانیتورینگ تحت وب Kafka UI ارائه شده است:
version: '3.8'

services:
  kafka-1:
    image: bitnami/kafka:3.7
    container_name: kafka-node-1
    ports:
      - "9092:9092"
    environment:
      - KAFKA_CFG_NODE_ID=1
      - KAFKA_CFG_PROCESS_ROLES=controller,broker
      - KAFKA_CFG_CONTROLLER_QUORUM_VOTERS=1@kafka-1:9093,2@kafka-2:9093,3@kafka-3:9093
      - KAFKA_KRAFT_CLUSTER_ID=L7Nx5yMvS9yZ3mRtPqW1aQ
      - KAFKA_CFG_LISTENERS=PLAINTEXT://:9092,CONTROLLER://:9093
      - KAFKA_CFG_ADVERTISED_LISTENERS=PLAINTEXT://localhost:9092
      - KAFKA_CFG_LISTENER_SECURITY_PROTOCOL_MAP=CONTROLLER:PLAINTEXT,PLAINTEXT:PLAINTEXT
      - KAFKA_CFG_CONTROLLER_LISTENER_NAMES=CONTROLLER
      - KAFKA_CFG_INTER_BROKER_LISTENER_NAME=PLAINTEXT
      - KAFKA_CFG_DEFAULT_REPLICATION_FACTOR=3
      - KAFKA_CFG_NUM_PARTITIONS=6
    volumes:
      - kafka_1_data:/bitnami/kafka

  kafka-2:
    image: bitnami/kafka:3.7
    container_name: kafka-node-2
    ports:
      - "9094:9092"
    environment:
      - KAFKA_CFG_NODE_ID=2
      - KAFKA_CFG_PROCESS_ROLES=controller,broker
      - KAFKA_CFG_CONTROLLER_QUORUM_VOTERS=1@kafka-1:9093,2@kafka-2:9093,3@kafka-3:9093
      - KAFKA_KRAFT_CLUSTER_ID=L7Nx5yMvS9yZ3mRtPqW1aQ
      - KAFKA_CFG_LISTENERS=PLAINTEXT://:9092,CONTROLLER://:9093
      - KAFKA_CFG_ADVERTISED_LISTENERS=PLAINTEXT://localhost:9094
      - KAFKA_CFG_LISTENER_SECURITY_PROTOCOL_MAP=CONTROLLER:PLAINTEXT,PLAINTEXT:PLAINTEXT
      - KAFKA_CFG_CONTROLLER_LISTENER_NAMES=CONTROLLER
      - KAFKA_CFG_INTER_BROKER_LISTENER_NAME=PLAINTEXT
    volumes:
      - kafka_2_data:/bitnami/kafka

  kafka-3:
    image: bitnami/kafka:3.7
    container_name: kafka-node-3
    ports:
      - "9096:9092"
    environment:
      - KAFKA_CFG_NODE_ID=3
      - KAFKA_CFG_PROCESS_ROLES=controller,broker
      - KAFKA_CFG_CONTROLLER_QUORUM_VOTERS=1@kafka-1:9093,2@kafka-2:9093,3@kafka-3:9093
      - KAFKA_KRAFT_CLUSTER_ID=L7Nx5yMvS9yZ3mRtPqW1aQ
      - KAFKA_CFG_LISTENERS=PLAINTEXT://:9092,CONTROLLER://:9093
      - KAFKA_CFG_ADVERTISED_LISTENERS=PLAINTEXT://localhost:9096
      - KAFKA_CFG_LISTENER_SECURITY_PROTOCOL_MAP=CONTROLLER:PLAINTEXT,PLAINTEXT:PLAINTEXT
      - KAFKA_CFG_CONTROLLER_LISTENER_NAMES=CONTROLLER
      - KAFKA_CFG_INTER_BROKER_LISTENER_NAME=PLAINTEXT
    volumes:
      - kafka_3_data:/bitnami/kafka

  kafka-ui:
    image: provectuslabs/kafka-ui:latest
    container_name: kafka-ui-dashboard
    ports:
      - "8080:8080"
    environment:
      - KAFKA_CLUSTERS_0_NAME=production-cluster
      - KAFKA_CLUSTERS_0_BOOTSTRAPSERVERS=kafka-1:9092,kafka-2:9092,kafka-3:9092
    depends_on:
      - kafka-1
      - kafka-2
      - kafka-3

volumes:
  kafka_1_data:
  kafka_2_data:
  kafka_3_data:
جهت اجرای این استک در پسزمینه سرور، دستور زیر را در خط فرمان اجرا کنید:
docker compose up -d
پس از برپایی کانتینر ها، کنسول مدیریتی Kafka UI روی پورت 8080 بالا آمده و به شما امکان میدهد تاپیک ها، توزیع رپلیکاها، اعضای گروه های مصرفکننده و پیام های جریانیافته را با واسط کاربری گرافیکی پایش کنید.
۶. مهندسی تولیدکننده مقاوم (Resilient Producer) و جلوگیری از نشت داده ها
در پیاده سازی سرویس هایی تجاری، پرودوسر باید به گونهای پیکربندی شود که تحت بدترین شرایط شبکه یا ریاستارت سرور های، هیچ پیامی مفقود نگردد. برای تحقق این هدف، سه پارامتر اساسی باید به صورت همزمان تنظیم شوند:
- تنظیم تاییدیه حداکثری (
acks=all): لیدر پارتیشن موظف است صبر کند تا پیام ارسالی علاوه بر ذخیره در دیسک خودش، در تمام اعضای همگام (In-Sync Replicas) نیز کپی شود و سپس پاسخ موفقیت را مخابره نماید. - فعال سازی پرودوسر همروند بدون تکرار (
enable.idempotence=true): اگر پس از ذخیره موفق پیام در بروکر، خط ارتباط شبکه قطع شود و پرودوسر تاییدیه را دریافت نکند، به صورت پیشفرض پیام را بازنشر میدهد. قابلیت Idempotence با الصاق یک شناسه یکتایProducerIdو شماره ترتیبیSequenceNumberبه پیام، به بروکر این امکان را میدهد که پیام های تکراری را بدون درج مضاعف در لاگ شناسایی و خنثی سازد. - فشرده سازی مدرن و ارسال دستهای (Batching & Compression): ارسال تکتک پیام ها باعث افزایش overhead هدرهای TCP میشود. با تنظیم
linger.ms=20و استفاده از الگوریتم فشرده سازی بسیار سریعzstd، کارایی پهنای باند و توان خروجی پیام ها به میزان چشمگیری جهش مییابد.
import json
import logging
from confluent_kafka import Producer

logging.basicConfig(level=logging.INFO)
logger = logging.getLogger("KafkaProducerService")

def delivery_callback(err, msg):
    if err:
        logger.error(f"Message delivery failed: {err}")
    else:
        logger.info(
            f"Message delivered to topic '{msg.topic()}' "
            f"[Partition: {msg.partition()}] at Offset {msg.offset()}"
        )

producer_config = {
    'bootstrap.servers': 'localhost:9092,localhost:9094,localhost:9096',
    # تضمین مقاومت در برابر خطای از دست رفتن پیام (Data Loss Prevention)
    'acks': 'all',
    'enable.idempotence': True,
    'retries': 5,
    'max.in.flight.requests.per.connection': 5,
    # بهینه سازی عملکرد و توان خروجی (Throughput)
    'compression.type': 'zstd',
    'linger.ms': 20,
    'batch.size': 64 * 1024, # 64 KB
}

producer = Producer(producer_config)

def publish_order_event(order_id: str, customer_id: str, total_amount: float):
    event_payload = {
        "event_id": f"evt_{order_id}",
        "event_type": "OrderCreated",
        "timestamp": "2026-09-13T12:00:00Z",
        "data": {
            "order_id": order_id,
            "customer_id": customer_id,
            "amount": total_amount,
            "currency": "IRR"
        }
    }

    # استفاده از order_id به عنوان کلید پارتیشن بندی جهت تضمین اکید ترتیب رخدادها
    partition_key = str(order_id).encode('utf-8')
    serialized_value = json.dumps(event_payload).encode('utf-8')

    try:
        producer.produce(
            topic='orders.v1',
            key=partition_key,
            value=serialized_value,
            on_delivery=delivery_callback
        )
        # فراخوانی سرویس برای آزادسازی رویدادهای ارسالی در صف داخلی
        producer.poll(0)
    except BufferError:
        logger.warning("Local producer buffer full, flushing messages...")
        producer.flush()
        producer.produce(topic='orders.v1', key=partition_key, value=serialized_value, on_delivery=delivery_callback)

# ارسال داده ها و تخلیه بافر پیش از خاتمه پردازش
publish_order_event("ord_98421", "cust_1054", 45000000.0)
producer.flush()
۷. مهندسی مصرف کننده و کنترل آفست با استراتژی ری بالانس مشارکتی
سمت مصرفکننده (Consumer) محلی است که بیشترین خطاهای انسانی و منطقی در آن رخ میدهد. اتکا به کامیت خودکار آفست ها (enable.auto.commit=true) یکی از خطرناکترین اشتباهات برنامه نویسی است. در کامیت خودکار، کانسومر به صورت زمان بندیشده (مثلاً هر ۵ ثانیه) آفست را افزایش میدهد؛ اگر کانسومر پیامی را دریافت کند و پیش از تکمیل ثبت آن در دیتابیس کرش کند، آفست در سرور کامیت شده و با بالا آمدن مجدد کانسومر، آن پیام هرگز دوباره پردازش نمیشود که این یعنی نشت سایلنت داده ها!
راهکار حرفهای، کامیت دستی و سنکرون آفست (Manual Commit) است. در این شیوه، آفست تنها و تنها پس از تایید موفقیتآمیز تراکنش پایگاه داده کامیت میشود. علاوه بر این، استفاده از پروتکل CooperativeStickyAssignor که از کافکا ۲.۴ به بعد استاندارد شده است، مانع از توقف فراگیر کلاستر (Stop-The-World) در هنگام پیوستن یک نود کانسومر جدید به گروه میشود:
import json
import logging
from confluent_kafka import Consumer, KafkaError, KafkaException
logging.basicConfig(level=logging.INFO)
logger = logging.getLogger("PaymentConsumerService")
consumer_config = {
'bootstrap.servers': 'localhost:9092,localhost:9094,localhost:9096',
'group.id': 'payment-processing-service-group',
'auto.offset.reset': 'earliest',
# غیرفعال سازی اکید کامیت خودکار جهت جلوگیری از نشت داده در خطاهای پردازشی
'enable.auto.commit': False,
# استفاده از استراتژی مدرن تعاونی پایدار به جای ریبالانس سنتی
'partition.assignment.strategy': 'cooperative-sticky',
'session.timeout.ms': 45000,
'max.poll.interval.ms': 300000
}
consumer = Consumer(consumer_config)
consumer.subscribe(['orders.v1'])
def process_business_logic(order_data: dict) -> bool:
# عملیات اعتبارسنجی کارت و ثبت تراکنش در پایگاه داده اصلی
logger.info(f"Processing payment for Order: {order_data['data']['order_id']} with Amount: {order_data['data']['amount']}")
return True
try:
while True:
msg = consumer.poll(timeout=1.0)
if msg is None:
continue
if msg.error():
if msg.error().code() == KafkaError._PARTITION_EOF:
logger.debug(f"Reached end of partition {msg.partition()} at offset {msg.offset()}")
else:
raise KafkaException(msg.error())
else:
try:
payload = json.loads(msg.value().decode('utf-8'))
success = process_business_logic(payload)
if success:
# ثبت قطعی و دستی آفست تنها پس از پایان موفقیتآمیز لایه دامنه
consumer.commit(message=msg, asynchronous=False)
except Exception as exc:
logger.error(f"Transient error processing offset {msg.offset()}: {exc}")
# هدایت به تاپیک صف تلاش مجدد یا ثبت در Dead Letter Queue (DLQ)
finally:
logger.info("Closing consumer connection safely and releasing partitions...")
consumer.close()۸. الگو های معماری در سیستم های رویداد محور: Transactional Outbox و CDC
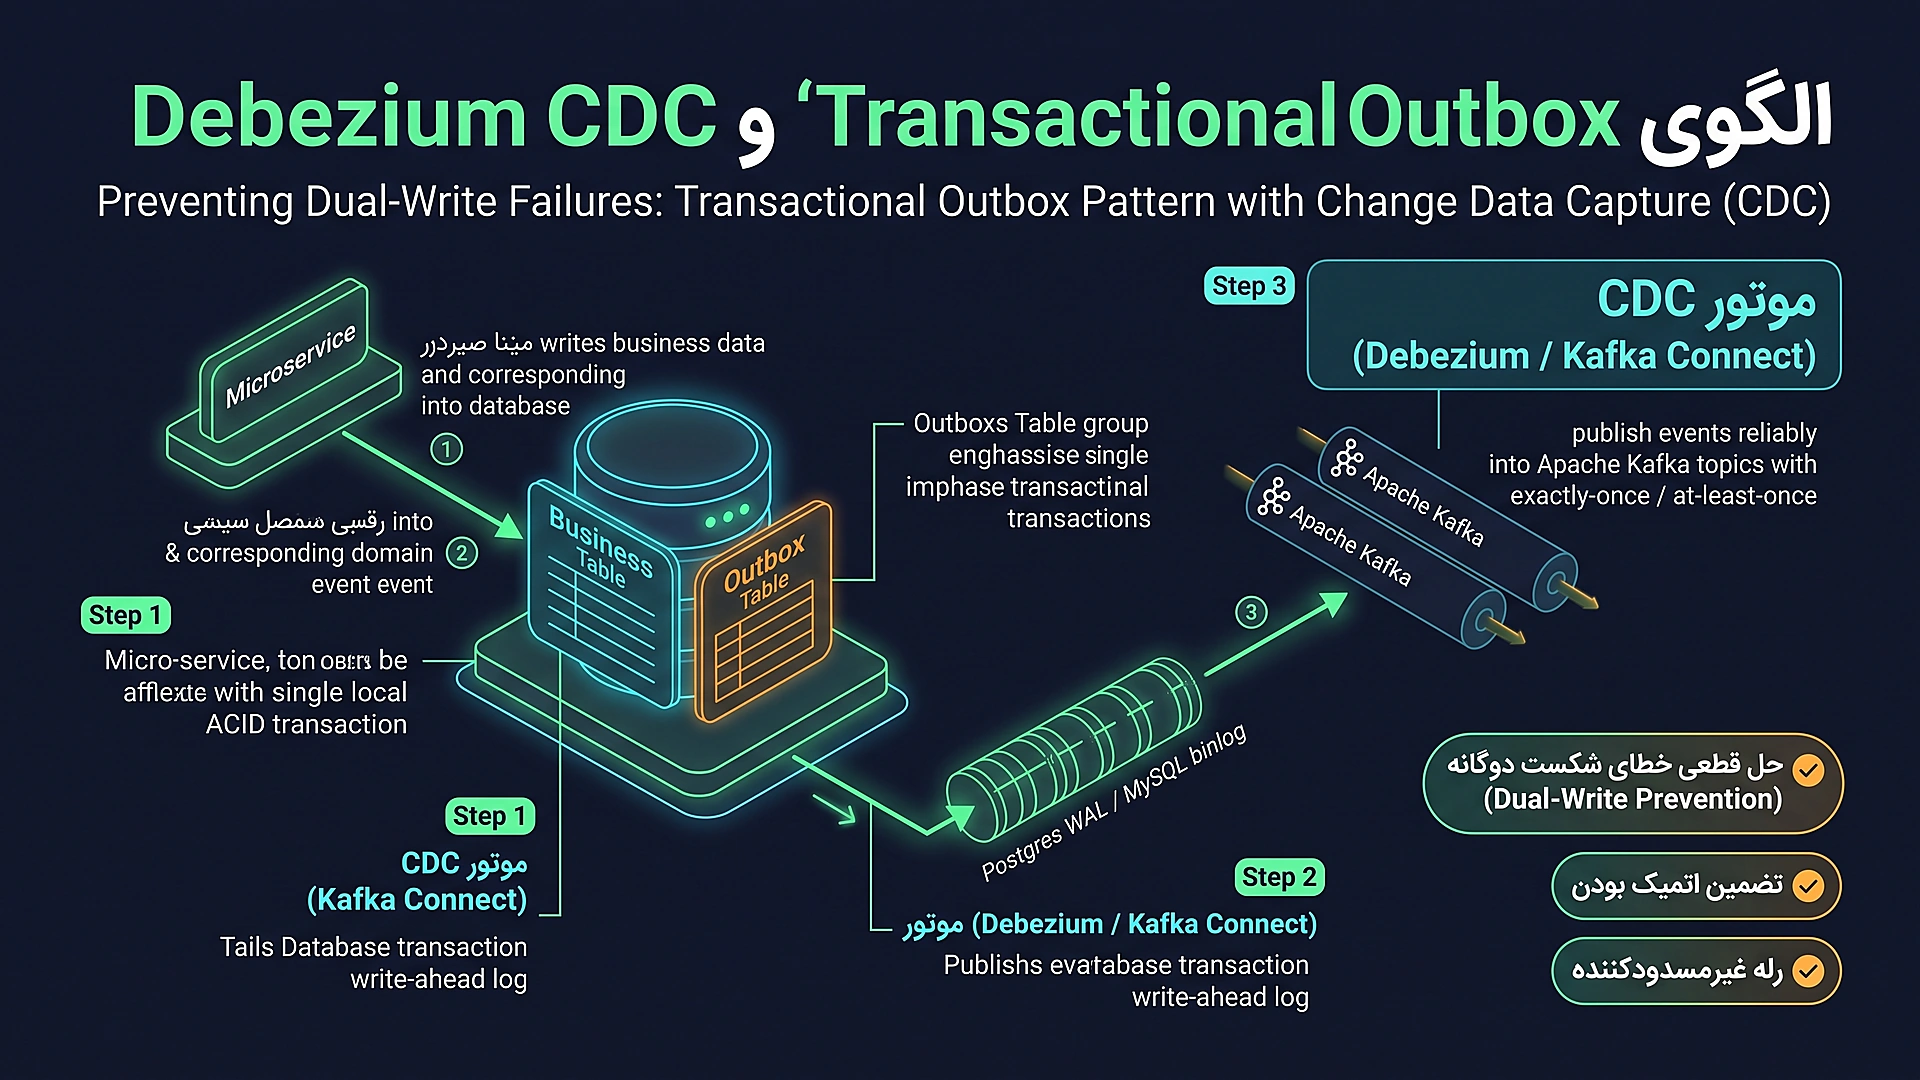
یکی از دشوارترین مسائل در سیستم های توزیع شده، مسئله بهروزرسانی دوگانه (Dual-Write Problem) است: فرض کنید سرویس سفارشات باید یک ردیف جدید در دیتابیس PostgreSQL ثبت کند و همزمان پیامی به تاپیک کافکا ارسال نماید. چه اتفاقی میافتد اگر ثبت دیتابیس با موفقیت انجام شود، اما اتصال به کافکا دچار قطعی گردد؟ یا بالعکس، پیام به کافکا ارسال شود اما تراکنش دیتابیس با خطای Rollback مواجه شود؟ در چنین شرایطی، سیستم دچار تناقض و ناسازگاری فاحش دادهای میشود.
برای حل این معضل بدون نیاز به پروتکل های سنگین و کند دو مرحلهای (۲PC)، از الگوی جعبه ارسال تراکنشی (Transactional Outbox Pattern) استفاده میشود. در این الگو، به جای ارسال مستقیم پیام به کافکا، رویداد در قالب یک جدول کمکی به نام outbox_events در همان پایگاه داده رابطهای و در دل همان تراکنش کسبوکار ذخیره میشود:
-- جدول سفارشات در دیتابیس تراکنشی اصلی (PostgreSQL / MySQL)
CREATE TABLE orders (
order_id VARCHAR(64) PRIMARY KEY,
customer_id VARCHAR(64) NOT NULL,
total_amount NUMERIC(15, 2) NOT NULL,
status VARCHAR(32) NOT NULL,
created_at TIMESTAMP WITH TIME ZONE DEFAULT CURRENT_TIMESTAMP
);
-- جدول جعبه ارسال پیام (Outbox Table) در همان دیتابیس
CREATE TABLE outbox_events (
id UUID PRIMARY KEY DEFAULT gen_random_uuid(),
aggregatetype VARCHAR(128) NOT NULL,
aggregateid VARCHAR(128) NOT NULL,
type VARCHAR(128) NOT NULL,
payload JSONB NOT NULL,
created_at TIMESTAMP WITH TIME ZONE DEFAULT CURRENT_TIMESTAMP
);
-- تراکنش اتمیک کسبوکار: ثبت همزمان سفارش و رویداد در یک ترنزکشن ACID واحد
BEGIN;
INSERT INTO orders (order_id, customer_id, total_amount, status)
VALUES ('ord_99104', 'cust_440', 85000000.0, 'PENDING');
INSERT INTO outbox_events (aggregatetype, aggregateid, type, payload)
VALUES (
'Order',
'ord_99104',
'OrderCreated',
'{"order_id": "ord_99104", "customer_id": "cust_440", "amount": 85000000.0, "currency": "IRR"}'::jsonb
);
COMMIT;سپس یک ابزار اختصاصی ضبط تغییرات داده یا Change Data Capture (CDC) نظیر Debezium مستقیماً لاگ های تراکنشی پایگاه داده (Write-Ahead Log یا WAL در پستگرس) را مانیتور کرده و رکوردهای اضافهشده به جدول Outbox را با تضمین قطعی و بدون کوچکترین سربار محاسباتی بر روی پایگاه داده، به تاپیک کافکا پمپاژ میکند.
۹. مهندسی تاب آوری خطا: الگوی صف تلاش مجدد و صف پیام های مرده (DLQ)
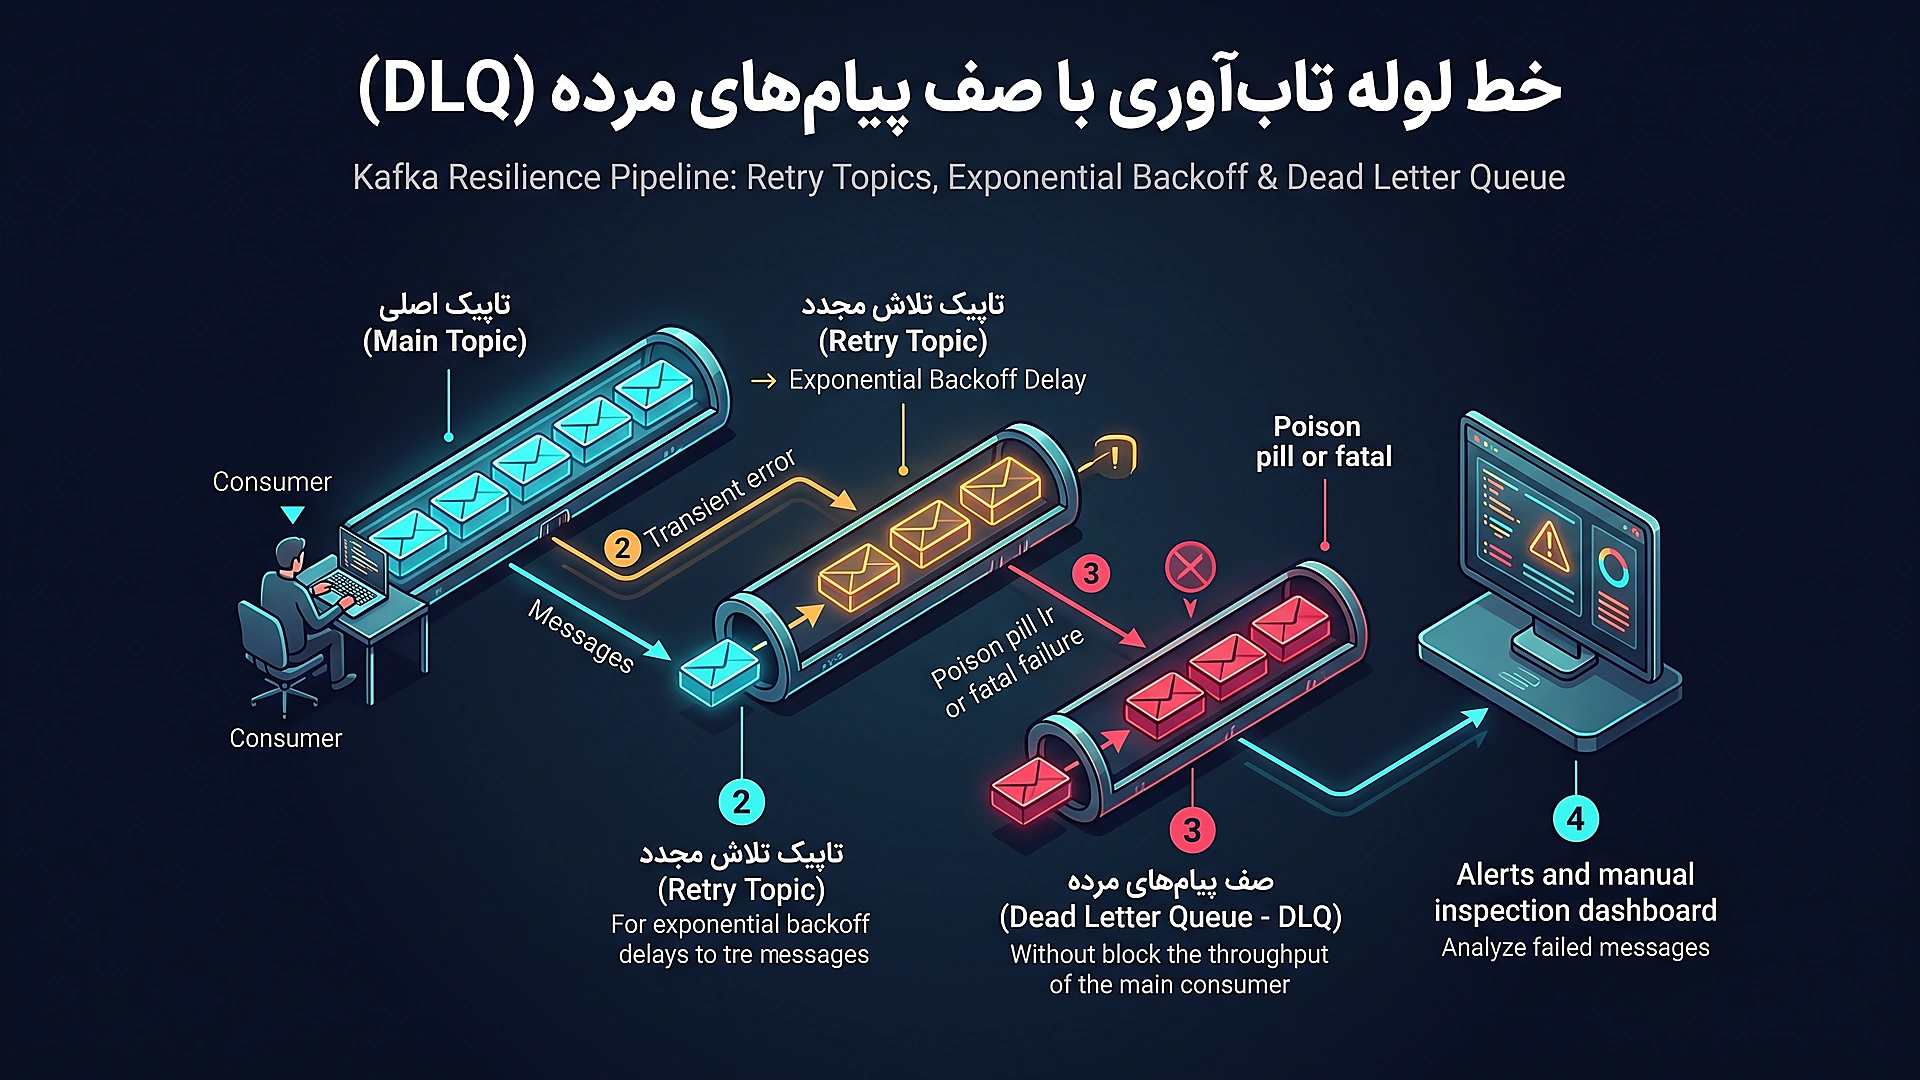
در سیستم های پرترافیک، مواجهه با پیام های معیوب یا خطاهای موقت شبکه امری روزمره است. اگر یک پیام به دلیل خطای منطقی نتواند پردازش شود و کانسومر دائماً کرش کند، کل پارتیشن متوقف شده و مصرف پیام های سالم بعدی ناممکن میگردد. برای خنثی کردن این بنبست، معماری خط لوله خطای چند مرحلهای به شرح زیر پیاده سازی میشود:
- تاپیک اصلی (Main Topic): کانسومر پیام را دریافت و تلاش به پردازش میکند. در صورت موفقیت، آفست کامیت میشود.
- تاپیک تلاش مجدد با تاخیر (Retry Topic): در صورت بروز خطای گذرا، پیام به تاپیک رترای ارسال شده و آفست تاپیک اصلی کامیت میگردد تا جریان لاگ متوقف نشود. در تاپیک رترای، کانسومر دیگری با تاخیرهای نمایی (مثلاً ۳۰ ثانیه، ۲ دقیقه و ۵ دقیقه) تلاش به اجرای مجدد میکند.
- صف پیام های مرده (Dead Letter Queue - DLQ): اگر پیام پس از سقف مجاز تلاش ها همچنان با خطا مواجه شود، به عنوان یک پیام سمی (Poison Pill) شناسایی شده و همراه با کلیه هدرهای بافت خطا (Error Context Headers) به تاپیک DLQ فرستاده میشود. تیم عملیات با هشدارهای سیستم مانیتورینگ متوجه شده و پس از رفع ایراد برنامه، از طریق خطوط لوله بازپخش (Replay Pipelines) پیام ها را مجدداً به چرخه بازمیگردانند.
۱۰. جعبه ابزار مدیریت کلاستر در خط فرمان (CLI Toolkit)
تسلط بر اسکریپت های توزیع شده رسمی کافکا برای معماران داده امری اجتنابناپذیر است. ساخت تاپیک با پارتیشن بندی و فاکتور رپلیکیشن صحیح، بررسی لیدرها و سنجش میزان تاخیر کانسومرها به صورت دستوری صورت میپذیرد. همچنین نگه داری تاریخچه تمامی اسکریپت های زیرساختی و تعاریف تاپیک ها به عنوان کد در سیستم کنترل نسخه گیت (Git) (Git) ضامن استقرار تکرارپذیر و هماهنگی تیمی است:
# ۱. ایجاد تاپیک سازمانی جدید با ۶ پارتیشن و فاکتور تکثیر ۳
kafka-topics.sh --bootstrap-server localhost:9092 \
--create --topic orders.v1 \
--partitions 6 \
--replication-factor 3 \
--config min.insync.replicas=2 \
--config retention.ms=604800000
# ۲. مشاهده پیکربندی، وضعیت پارتیشن ها و موقعیت لیدرها (Leader Replicas)
kafka-topics.sh --bootstrap-server localhost:9092 \
--describe --topic orders.v1
# ۳. پایش لحظهای تاخیر مصرفکننده (Consumer Group Lag) در کلاستر پروداکشن
kafka-consumer-groups.sh --bootstrap-server localhost:9092 \
--describe --group payment-processing-service-group۱۱. ماتریس مقایسه فنی: کافکا، RabbitMQ و Redis Streams
برای اتخاذ تصمیم هوشمندانه در سازمان، جدول مقایسهای زیر مزایا و مرزهای کاربردی هر یک از ابزار های شناختهشده تبادل پیام را تبیین میکند:
| شاخص فنی | آپاچی کافکا (Kafka) | ربیتامکیو (RabbitMQ) | ردیس استریم (Redis Streams) |
|---|---|---|---|
| ساختار ذخیره سازی داده | لاگ ترتیبی فقط-افزودنی روی دیسک (Log) | صف پیام مصرفشدنی درون رم/دیسک | درخت رادیکس (Radix Tree) در حافظه رم |
| ماندگاری رویدادها (Retention) | مبتنی بر زمان/حجم (روزها یا سال ها) | حذف بلافاصله پس از تایید مصرف (ACK) | محدود به سقف حافظه رم (تکنیک Capping) |
| حداکثر توان عملیاتی | بسیار عظیم (میلیون ها پیام در ثانیه) | متوسط (ده ها هزار پیام در ثانیه) | فوقالعاده سریع با تاخیر زیر میلیثانیه |
| پخش مجدد داده ها (Replay) | پشتیبانی کامل و نیتیو با تغییر آفست | ناممکن پس از تایید مصرف پیام | محدود به پیام های حفظشده در رم |
| بهترین زمینه کاربرد | جریان کلان داده، پردازش رویداد، EDA | مسیریابی پیچیده پیام و وظایف پسزمینه | خط لوله های داده سبک با تاخیر بحرانی |
۱۲. چک لیست نهایی پروداکشن: مانیتورینگ متریک های حیاتی کلاستر
پیش از استقرار کلاستر کافکا در پروداکشن، رعایت چکلیست زیر پایداری ۹۹.۹۹ درصدی سرویس شما را تضمین میکند:
- ✅ پایش مداوم Consumer Lag: مهمترین متریک در کافکا، فاصله میان آخرین آفست تولیدشده و آخرین آفست مصرفشده است. رشد مداوم Lag هشداری فوری مبنی بر ناتوانی کانسومرها یا کندی پایگاه داده است.
- ✅ تنظیم دقیق پارامتر
min.insync.replicas=2: با فاکتور تکثیر ۳، تضمین میکند پیام ها تنها زمانی پذیرفته شوند که حداقل در دو نسخه مستقل به صورت همگام ثبت شده باشند. - ✅ ممنوعیت انتخاب لیدر ناهماهنگ (
unclean.leader.election.enable=false): مانع از لیدر شدن گره های عقبافتاده در هنگام بروز بحران شبکه میشود تا از حذف سایلنت تاریخچه جلوگیری گردد. - ✅ استفاده از حافظه های NVMe و فایلسیستم XFS: تفکیک فیزیکی دیسک سیستمعامل از دیسک ذخیره داده ها و تنظیم آپشن های بهینه I/O در کرنل لینوکس.
۱۳. نتیجه گیری: ساخت سیستم های رویداد محور نسل آینده
معماری رویداد محور با آپاچی کافکا تنها یک انتخاب فناوری نیست، بلکه بازتعریف شیوه تفکر مهندسان نسبت به تبادل داده در عصر اطلاعات است. کافکا با ساختار نبوغآمیز لاگ متوالی، بهینه سازی های زیرسیستمی Zero-Copy در سیستمعامل، گذار موفق به اجماع بومی KRaft و اکوسیستم قدرتمند پردازش جریانی، بنیان محکم و مطمئنی برای هدایت ترافیک های سهمگین فراهم میآورد. با تسلط بر استراتژی های پارتیشن بندی، الگو های تراکنشی Outbox و مدیریت خطای خطوط لوله DLQ، نرم افزارهای شما به چنان درجهای از تابآوری و مقیاس پذیری دست خواهند یافت که در برابر هر حجم از ترافیک سازمانی سربلند خواهند بود.
امتیاز و نظرات
هنوز نظری ثبت نشده است. اولین نفر باشید.